TokenOps:用数据科学降低AI智能体的Token成本

TokenOps:用数据科学方法管控AI智能体Token成本,从结构、度量、决策三层构建效率框架。
随着AI智能体在企业中规模化落地,Token成本正以超出预期的速度膨胀。微软Frontier首席数据科学家Gareth Bland提出TokenOps概念,系统性地分析了这一问题的根源与应对方法。成本膨胀的核心原因在于:推理输出Token价格是基础输入的5倍,而多轮智能体循环中未缓存的输入会呈二次方增长,40轮任务可达预期成本的16倍。为此,他提出由自主完成率、Token效率比、价值生成比组成的三层漏斗效率评分体系,帮助团队从任务完成、有效部署到真实价值交付逐层追踪效率。同时,S曲线框架为企业提供了判断何时加码投入、何时止步于"镀金"的决策工具。TokenOps的本质是将财务与工程效率视角引入AI运营,将Token消耗作为需持续优化的战略资源而非单纯的账单数字。
随着AI智能体(Agent)在企业中落地,一个被频繁忽视的问题浮出水面:成本正在以超出预期的速度膨胀。微软Frontier公司首席数据科学家Gareth Bland提出了一个值得关注的概念——TokenOps,即通过数据科学方法,帮助企业持续做出关于Token花在哪里、如何花得更有价值的战略决策。
智能体成本的隐藏结构
很多人对Token成本的理解停留在"发消息、收消息"的简单模型上,但真实的成本结构要复杂得多。Bland指出,智能体最强大的能力是推理(reasoning),而推理恰恰发生在模型的输出环节——输出Token的价格约为基础输入Token的5倍。
除此之外,还有几类容易被忽略的成本。当智能体在循环中向缓存写入内容时会产生写入成本;而一旦内容进入缓存,再次读取时的成本只有基础成本的十分之一。这意味着,缓存的使用效率直接决定了整体支出的高低。
为什么成本会呈二次曲线上升
智能体并非"一问一答"的工作模式,而是通过多轮循环(agentic loop)逐步推理完成任务。Bland举了一个直观的例子:假设一个典型任务需要约10轮才能完成,这对应1倍的预期成本。
随着智能体不断增加轮次、上下文持续累积,未缓存的输入成本会呈现二次方上升曲线。当任务进行到40轮时,成本并不是线性的4倍,而是惊人的16倍。这正是TokenOps要解决的核心痛点——通过上下文工程(context engineering),尽可能复用缓存输入,把这条上升曲线压回到十分之一的水平。
上下文工程(Context Engineering)是指对输入模型的提示词内容进行结构化管理,以最大化缓存命中率、减少冗余Token传输。在多轮智能体循环中,每一轮都会将前序对话、工具调用结果、中间推理过程拼接进新一轮的输入上下文。如果不加干预,这些内容会完全以"未缓存输入"的形式反复计费。上下文工程的核心手段包括:将稳定不变的系统提示与动态内容分离(前者可长期命中缓存)、压缩或摘要化历史轮次、对工具返回值做精简处理。对于主流大模型API,提供商通常以5分钟至1小时为单位维护提示缓存(Prompt Cache),超时即失效。这意味着,即使是工程质量本身不差的智能体,若任务跨越缓存窗口,也会无谓地重新支付全量输入费用,使成本曲线重新陡峭起来。
用三个比率衡量智能体效率
工程系统离不开合适的遥测(telemetry)与度量指标。Bland提出了一个"整体智能体效率评分",由三个层层递进的比率构成,构成一个漏斗模型。
**自主完成率(Autonomous Completion Rate)**位于漏斗顶端,衡量有多少工作在没有失败、无需人工干预的情况下自主完成。这是评估智能体可靠性的第一道关口。
**Token效率比(Token Efficiency Ratio)**衡量在已完成的工作中,有多少真正被合并进生产环境、具备为用户提供服务的能力。换句话说,完成不等于有用,能够部署上线才算有效产出。
**价值生成比(Value Generation Ratio)**位于漏斗底端。对于那些已经上线、服务用户的功能,它们是否真正"推动了指标"?是否为用户带来了他们期待的价值?这才是衡量Token投入是否值得的终极标准。
遥测(Telemetry)在AI智能体语境下,特指对每次模型调用的Token用量、延迟、成功/失败状态、缓存命中情况等运行时数据的系统性采集与追踪。与传统软件监控不同,智能体的遥测需要精细到单次循环(loop iteration)级别,因为一个用户请求背后可能隐藏着数十次内部模型调用,每次调用的输入输出构成独立的计费单元。若缺乏这一层可观测性,团队将无法区分"任务完成是因为推理高效"还是"任务完成但消耗了不必要的50轮循环"。常见的遥测实现方案包括OpenTelemetry标准的LLM Span追踪、以及LangSmith、Weights & Biases、Helicone等专为LLM应用设计的可观测性平台,它们可将Token级别的成本直接映射到业务流程的具体步骤上。
S曲线:判断该投入还是该收手
Bland用一条S曲线来帮助团队判断自己处于软件开发的哪个阶段,这在"智能体工程时代"尤为关键。
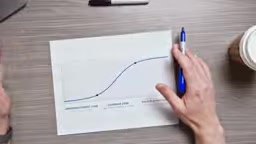
曲线起点是投入不足区(underinvestment zone)。在构建软件的最初几个功能时,团队还没有足够的功能来形成MVP或试点,无法为用户或业务流程带来价值。
越过某个阈值后,团队进入杠杆区(leverage zone)。在这个区间,每一次功能的增量改进或新功能都能切实为用户创造价值,是投入产出比最高的阶段。
但到达饱和点之后,情况就变了——这时的开发往往沦为"镀金(gold plating)":改进本已完善的功能、添加无人需求的特性,把Token花在了无法推动指标的地方。识别团队或下一个产品功能在S曲线上的位置,是避免资源浪费的关键。
S曲线(S-Curve)模型源自技术采纳与产品开发领域,描述了一项技术或功能集合在其生命周期内价值回报的典型形态:初期投入大、回报低(投入不足区);中期每单位投入带来最高边际回报(杠杆区);后期回报趋于饱和乃至递减(镀金区)。在传统软件开发中,识别这一曲线的位置依赖用户研究与A/B测试数据。但在AI智能体场景下,这一判断更为紧迫,因为每次无效功能迭代不仅消耗工程资源,还会直接转化为可量化的Token账单。"镀金"一词(gold plating)来自项目管理领域,特指在需求已充分满足后仍持续添加功能的行为,被视为资源浪费的典型反模式。将S曲线与Token效率指标结合,能让团队用数据而非直觉来判断何时应将资源从功能开发转向性能优化或新方向探索。
对企业的启示
TokenOps本质上是把财务与工程效率的视角引入AI智能体的运营中。它提醒企业:Token消耗不是简单的API账单,而是一项需要持续优化的战略资源。
从成本结构上看,输出和未缓存输入是最昂贵的部分,上下文工程和缓存复用是最直接的降本手段;从效率衡量上看,不能只看任务是否完成,而要追踪到价值交付;从投入决策上看,S曲线提供了一个判断何时加码、何时止步的直观框架。
对于正在大规模部署智能体的团队而言,建立起这套遥测与度量体系,或许比盲目追求更强的模型更能影响最终的ROI。
相关推荐

Anthropic SDK v1.12.0 更新解读:新增 Claude Haiku 5.5 与多项 API 能力
Anthropic SDK v1.12.0 正式发布,新增 claude-haiku-5-5 模型支持、类型化 computer/browser 工具调用、模型能力元数据扩展及 RBAC 权限改进。本文详解本次更新的核心功能、Bug 修复与开发者升级建议。

丽笙酒店接入ChatGPT:AI重塑旅行预订体验
丽笙酒店集团联手埃森哲,基于OpenAI技术打造ChatGPT插件,让旅行者在对话中查找、比较并预订酒店。本文解析这一举措背后的对话式商务趋势与行业影响。

用乐高轮子+开源Robium技能,教Stack-chan学会自主驾驶
开发者将M5Stack Stack-chan改装成轮式机器人,用乐高电机和开源Robium技能仓库训练ACT策略,通过模仿学习实现自主循迹驾驶。本文解析其硬件搭建、数据采集与AI辅助开发全流程。