同一份战绩,四种读法:给AI对手历史而非记忆

实验显示AI模型确实会读对手战绩,但读法各异且未必用对。
一项在QUANT.POKER平台上进行的实验,让四款模型(Jev、Gemini、luna、Haiku)在无记忆条件下通过文本简报获取对手历史记录,进行单挑无限注德州扑克对局。实验覆盖4800手牌,发现所有模型都会读取简报——移除记录后答案变化远超重复提问噪声。但每款模型读取的部分不同:Jev和Gemini下注对手会跟注的尺度但诈唬方向错误,luna恰好相反,Haiku完全不做尺度调整。更关键的是,使用记录不等于用好记录——Jev对从不弃牌的对手几乎总是all-in,恰恰浪费了记录提供的核心信息。Jev作为专用决策模型速度最快、成本最低,但对记录最敏感却策略最僵化。
当大模型没有记忆,它们会读对手的历史吗?
一个有意思的实验给出了答案。有人在 QUANT.POKER 上搭建了一个平台,让人类与 AI 模型进行单挑无限注德州扑克对局。由于通过 API 调用的模型在请求之间没有任何记忆,研究者换了一种方式:每次决策时,把对手的全部行为记录以文字简报的形式"喂"给模型。
问题的核心很简单——模型真的会读这份战绩吗?如果会,它们各自又是怎么读的?
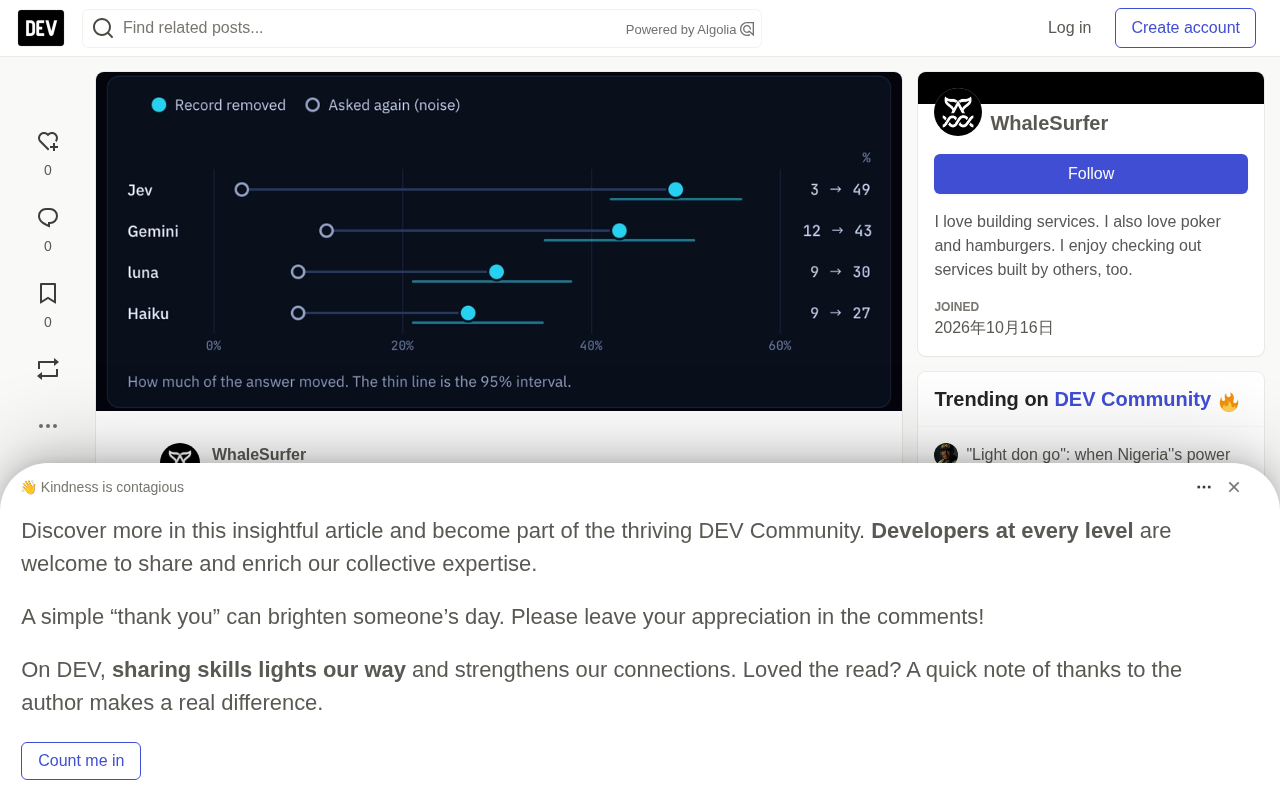
实验覆盖了四款模型、六个机器人对手、共计 4800 手牌。截图来自该实验的 RSS 源页面,展示了完整的观察报告框架。
实验设计:一次决策,一份简报
平台测试了四款模型。Jev-1.13.0 由 TypeSafe 开发,是一个专为快速回答设计的决策模型,并非语言模型——它不输出文字,只返回对给定选项的概率分布。另外三款是通用语言模型:Gemini-3.1-flash-lite、GPT-6-luna 和 Claude-Haiku-5.5。Haiku 和 luna 关闭了思考步骤,Gemini 使用提供方的默认设置。所有模型都没有被赋予人设或策略建议。
每次决策都是一个独立请求,不携带聊天历史。请求中包含一个 JSON 格式的状态描述:座位和筹码量、逐街的手牌进程、Hero 的底牌构成了什么牌型以及哪些牌能击败它,还有对手的行为记录。记录以"x of n"(在 n 次机会中执行了 x 次)的形式呈现,覆盖所有历史手牌和最近 30 手,按情境和下注尺度细分,并列出对手在摊牌时亮出的底牌。一份简报约 2100 到 3600 个 token。
六个机器人对手各遵循一条简单规则:station(check 或 call,从不弃牌)、shove(每次都 all-in)、raise(每次都做次大额加注)、min(总是最小加注)、stab(下最小注,AI 一旦下注就弃牌)、switch(50 手像 station,50 手像 raise,交替进行)。
每款模型与每个机器人对战 200 手,起始筹码 100 BB。
单挑无限注德州扑克(Heads-up No-Limit Texas Hold'em) 是 AI 决策研究中的经典测试场景,原因有三:状态空间巨大但规则明确;每一步都是不完全信息博弈,需要推断对手隐藏的手牌范围;收益以筹码计算,可以直接量化策略优劣。无限注意味着玩家可以在任何下注轮选择任意下注量(从最小注到全部筹码 all-in),这使得下注尺度本身成为策略的一部分,而非固定选项。本文中的六个机器人对手正是通过固定下注规则来简化这一维度,让研究者能够观察模型是否以及如何根据对手的反应模式调整自己的下注尺度——这恰好是教科书策略中最基础也最关键的一环。
核心发现一:四款模型都在使用对手记录
研究者从每款模型的对局后期抽取 60 个决策,当记录已经足够充分时,用三种方式重新提问:原始问题、相同简报重复提问两次、以及将记录替换为空记录(0 手)。
衡量答案是选项之间的概率转移量,称为总变差距离。0% 表示答案完全相同,100% 表示毫无重叠。
| 模型 | 重复提问的变化(噪声) | 移除记录后的变化 | 移除影响超过噪声的决策数 |
|---|---|---|---|
| Jev | 3% | 49% [42–56] | 58/60 |
| Gemini | 12% | 43% [35–51] | 41/60 |
| luna | 9% | 30% [21–38] | 29/60 |
| Haiku | 9% | 27% [21–35] | 35/60 |
数据非常清晰:四款模型都在读这份记录。对 Jev 而言,移除记录后答案移动了 49%,而同一简报重复提问的变化仅为 3%。三款语言模型对同一简报的回答约有 10% 的波动,这构成了所有比较的噪声底线。
记录还让每款模型都变得更加激进——下注、加注和 all-in 的总权重分别上升了 7 个百分点(luna)、12 个(Haiku)、16 个(Gemini)和 28 个(Jev)。
总变差距离(Total Variation Distance, TVD) 是衡量两个概率分布差异的标准方法,定义为一对分布在同一事件集合上概率差绝对值之和的一半。取值范围从 0(两个分布完全一致)到 1(或 100%,两个分布完全不重叠)。在本文场景下,研究者把模型对每个可选动作给出的概率视为一个分布,比较两次提问得到分布之间的 TVD,就能得到"答案移动了多少"的量化指标。TVD 的优点在于它同时捕捉了所有选项的联合变化,而不是逐个选项对比;缺点是对分布中微小但系统性偏移也很敏感,因此必须设置噪声基线。本文用"同一简报重复提问"的 TVD 作为噪声底线,再与方法移除记录后的 TVD 对比——只有当移除带来的移动显著超出噪声时,才能断定模型确实在使用记录里的信息。
核心发现二:每款模型读取的是不同部分
研究通过对照实验来观察模型具体读了什么。两个记录仅在一点上不同,由固定风格的脚本玩家与一个简单的主场玩家对战 300 手生成,确保记录包含该风格对每种下注尺度的反应。
下注尺度的调整
第一个对手对大额下注(大注、超额下注、all-in)弃牌,对中小注跟注;第二个对手恰好相反。教科书式调整是:面对前者,用大注诈唬、用强牌下小注;面对后者则反转。
| 模型 | vs 对大注弃牌 | vs 对小注弃牌 | 差异(百分点) |
|---|---|---|---|
| Jev | 28% | 82% | −54 [−58, −49] |
| Gemini | 35% | 68% | −33 [−47, −19] |
| luna | 58% | 42% | +16 [+8, +24] |
| Haiku | 52% | 51% | +1 [−5, +6] |
Jev 和 Gemini 无论手里拿着什么牌,都下注对手会跟注的尺度——这对强牌是正确的教科书调整。但用空气牌时就是反的:Jev 面对对大注弃牌的对手时,只有 23% 的时候下大注。luna 则无论持有什么牌,都下注对手会弃牌的尺度——这对诈唬正确,对强牌是反的。Haiku 根本不调整下注尺度。
四款模型没有一个根据自己手里的牌来改变下注尺度,每款都对所有手牌套用同一条规则。
诈唬的识别
面对被 check 后用小注下注任何牌的对手,教科书建议增加跟注频率。只有 Haiku 做出了调整:用空气牌时,面对任何牌都下注的对手,继续率高达 91%;面对只有成对以上才下注的对手,继续率为 69%。Jev、Gemini 和 luna 的简报里明明有这条记录行,却没有据此行动。
核心发现三:使用记录 ≠ 用好记录
这是整个实验中最值得深思的部分。
Jev 的万能答案。 当前位先行动时,Jev 几乎总是选择 all-in:对 min 是 97 次中的 91 次,对 raise 是 111 次中的 101 次,对 shove 是 103 次中的 103 次,对 station 是 103 次中的 99 次。唯一的例外是 stab——唯一会弃牌的机器人,100 次中只有 2 次 all-in。
面对一个什么都跟的玩家,随机手牌 all-in 大约只有一半胜率,几乎不赚筹码。打强牌、弃弱牌才能稳步盈利。记录明确告诉 Jev 对手从不弃牌,Jev 却用一个完全不利用这一信息的动作来回应。
对着墙下注。 面对 station 时,记录显示每一个河牌下注都被跟注。在 Hero 先行动且持有空气牌的河牌情境中:Gemini 83 次里下注 16 次,Haiku 84 次里下注 15 次,luna 92 次里 0 次。对一个从不弃牌的玩家诈唬,只会白白损失筹码。
在无限注德州扑克中,诈唬(bluff) 指用当前牌力不足以在摊牌中获胜的手牌主动下注或加注,目的是迫使对手弃掉更好的牌。诈唬能否盈利,取决于对手的弃牌频率:如果对手弃牌率高于某个阈值(取决于下注尺度相对于底池的比例),诈唬就是正期望值;如果对手从不弃牌,诈唬的期望值必然为负,等于把筹码白送给对方。反之,价值下注(value bet) 是用强牌下注,希望对手用更差的牌跟注。教科书策略因此强调"对跟注站用价值下注、减少诈唬;对过度弃牌的玩家用大尺度诈唬"。本文中 station 机器人从不弃牌,对它的任何诈唬都是纯亏损;而 shove 机器人总是 all-in,用随机手牌跟注也只有约一半胜率。Jev 对这五类从不弃牌的对手几乎恒定 all-in,等于把简报里最有价值的一条信息(对手不会弃牌)转化成了最不利的行动。
速度与成本
| 模型 | 响应时间(典型/慢) | 输入 token | 每次决策成本 |
|---|---|---|---|
| Jev | 0.19s / 0.23s | 2,150 | ≈ $0.00009 |
| Gemini | 1.28s / 1.52s | 2,909 | ≈ $0.0009 |
| luna | 2.02s / 2.63s | 2,388 | ≈ $0.0003 |
| Haiku | 1.42s / 1.95s | 3,619 | ≈ $0.0004 |
Jev 作为专用决策模型,速度快了一个数量级,成本也低得多。Haiku 的输入 token 最多,因为它的简报最长。
边界与局限
这项实验有明确的限制需要说明。每个模型与每个机器人只对战一次,只用了一副牌的发牌结果;机器人风格极端,结果反映的是四款模型如何应对六个简单玩家,而非真实人类对手。200 手的样本量下,运气的影响远大于技术,胜率的置信区间约为每百手 ±600 BB。每个模型在不同情境下被重新提问,跨模型比较只能粗略参考。
此外,概率是模型自己写出来的文字,没有人验证过"85%"是否真的意味着 85%。简报只有一种固定排版,而早期测试表明,仅改变排版就能让 Jev 的单个决策移动 10 到 30 个百分点。
这对 AI 应用意味着什么
这个实验的价值不在于扑克本身,而在于揭示了一个更普遍的问题:当我们将结构化数据以文本形式注入给 AI 模型时,模型确实会读取它——但读取方式高度分化。有的模型只抓住了信息的一半,有的抓住了错误的一半,还有的虽然正确使用了信息,却做出了与信息相悖的决策。
Jev 的案例尤其值得注意:它是对记录最敏感的模型(移除后 49% 的答案发生变化),同时也是最终策略最僵化的模型。敏感不等于明智。在实际的 AI 应用场景中——无论是客服系统读取用户历史、推荐引擎分析行为数据,还是 Agent 根据环境状态做决策——"模型使用了数据"和"模型用好数据"之间,可能隔着一道比我们想象中更宽的鸿沟。
相关推荐

Claude Code+Codex多智能体系统实测:缓存率98%背后的真问题
开发者公布Claude Code+Codex多智能体系统7天实测:缓存率98%、输入输出比354:1,作者却卡在组织调度与输出比例,并追问行业基准与成本度量方法。

Cursor SDK 新功能:实时操控运行中的 AI 代理
Cursor SDK 新增 run.steer() 功能,允许开发者在 AI 代理运行中实时注入消息,调整执行方向。子代理遇 steer 时自动转入后台继续任务,为 AI 编程工作流带来更灵活的运行时干预能力。

如何评估AI生成的研究摘要?三个关键维度
AI生成的研究摘要读起来流畅,但事实未必可靠。本文基于Reddit讨论,梳理评估AI研究摘要系统的三个核心维度:来源可追溯性、事实一致性与不确定性处理,并探讨其对深度学习从业者的实践意义。