通义千问Qwen3.8 Flash实测:百万上下文三步上手
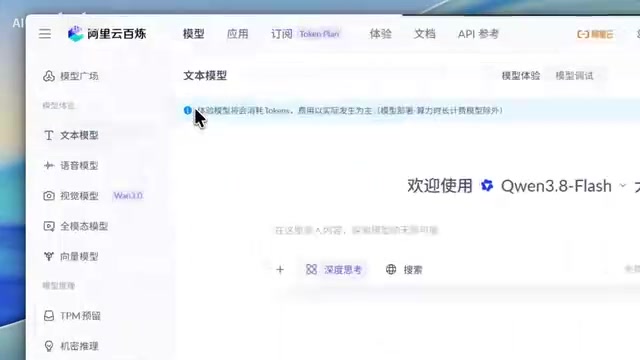
Qwen3.8 Flash以1250亿总参数、仅激活60亿的MoE架构,将多模态百万上下文能力开放给普通用户在线测试。
通义千问发布的Qwen3.8 Flash Next采用稀疏激活的MoE架构,总参数1250亿但每Token仅激活约60亿,在保持大模型知识容量的同时将推理成本压至可控范围。生产版Qwen3.8 Flash已上架阿里云百炼模型体验中心,支持文本、图片、视频三种输入方式,并原生支持百万级上下文,无需本地部署即可使用。文章给出了一套三步实测框架:选模型、喂图片与长文本、交付真实任务,并建议从短样本起步再递进至长材料。评估时重点关注三个维度:长材料关键信息是否遗漏、图片数字识别是否准确、输出格式是否可直接投入工作流,以此判断模型在实际场景中的真实价值。
别被参数吓退:1250亿总参数,只激活60亿
看到大模型的参数量,很多人第一反应是「这跟我没关系,得堆一台巨型电脑才跑得动」。但通义千问这次放出的下一代架构预览 Qwen3.8 Flash Next,恰恰打破了这种直觉。
它的总参数量达到 1250 亿,但每处理一个 Token,实际只激活其中约 60 亿。用一句话理解就是:模型看起来体量惊人,但真正跑起来时并不需要动用全部参数。这背后是稀疏激活(MoE 类)架构的思路——用「大模型的知识储备」换「小模型的推理成本」,让普通用户也有机会用上顶配能力。
对大多数人来说,比参数更重要的问题是:普通账号到底能测什么?答案是——生产版本 Qwen3.8 Flash 已经上架阿里云百炼的模型体验中心,可以直接选用,不需要部署,也不需要昂贵硬件。
MoE(Mixture of Experts,混合专家)架构的核心思想是:将模型内部划分为多个「专家」子网络,每次处理输入时,由一个轻量级的路由器(Router)动态选择少数几个专家参与计算,其余专家保持静默。这与传统的稠密模型(Dense Model)形成对比——稠密模型每处理一个 Token 都会激活全部参数。MoE 的优势在于:模型可以用极低的单次推理成本,享有远超同等激活参数量的「知识容量」。代价是训练和调度复杂度更高,且总参数量带来的存储需求依然存在。GPT-4、Mixtral、DeepSeek 等主流前沿模型均采用类似思路,Qwen3.8 Flash Next 的 1250 亿总参数/60 亿激活参数比例,属于当前业界较为激进的稀疏化设计。
能力盘点:文本、图片、视频输入,百万级上下文
Qwen3.8 Flash 是一个原生的多模态模型,输入端支持文本、图片、视频三种形式,输出端为文本。这意味着你既可以让它读一张图表,也可以直接喂给它一段视频内容做理解。
更关键的一点是它原生支持百万级上下文。上下文窗口决定了模型一次能「记住」多少内容,百万级别意味着你可以一口气把整份合同、整套课程笔记、一整场会议纪要塞进去,让它在完整语境下做处理,而不是分段截断后丢失前后关联。
这类长上下文能力对处理真实工作材料的价值很直接:不用再手动切分长文档,也减少了「模型只看了片段就下结论」带来的信息遗漏。
「上下文窗口」(Context Window)是指模型在单次推理中能够同时处理的最大 Token 数量,直接决定了模型的「短期记忆」上限。早期主流模型的上下文窗口仅有 4K 至 32K Token(大约对应几千到两三万汉字),处理稍长的文档就需要人工分段,容易在段落衔接处丢失关联信息。百万级上下文(约 100 万 Token,对应数十万至百万汉字)意味着可以将一整本书、完整的法律合同包或数小时的会议文字记录一次性纳入模型视野。需要注意的是,上下文越长,推理所需的计算量和内存也成比例增长,因此能否在百万级上下文下保持稳定的响应速度和信息提取精度,是评估此类模型的关键门槛。
三步实测法:从短样本到长材料
想验证这款模型是否好用,作者给出了一套可复制的三步操作流程。
第一步:进入体验中心选模型
打开阿里云百炼的模型体验中心,在模型列表里选择 Qwen3.8 Flash。这一步不需要任何本地环境配置,直接在网页端完成。
第二步:喂它一张图 + 一段长文本
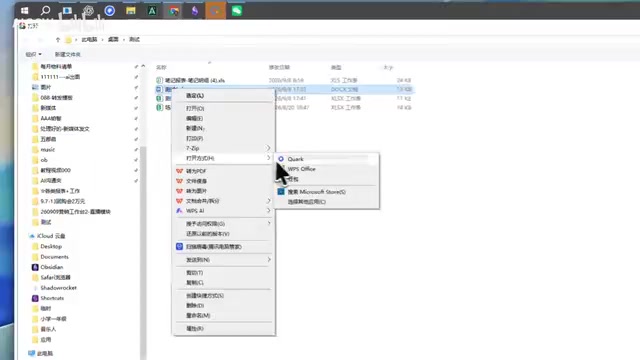
先上传一张带有数字或图表的图片,让模型读清楚其中的细节,检验它的图像理解精度;再贴入一段长文本,比如课程笔记、合同条款或会议纪要,测试它对长内容的消化能力。
第三步:给一个真实任务
不要只让它「总结一下」,而是给出具体、可验证的任务,例如把一份长材料整理成表格,或者按固定格式输出结构化总结。真实任务才能暴露模型的短板。
值得一提的是,模型支持「思考模式」,即先推理再作答;如果追求响应速度,也可以关闭思考直接拿结果。作者建议:首次测试先跑短样本,确认回复稳定后,再放长内容。这样能快速定位问题,避免一上来就用超长材料把变量搞复杂。
测试时要盯住的三个指标
跑测试的时候,光看「答得像不像样」是不够的,作者提醒要重点记录三件事:
- 长材料里的关键信息有没有漏——这是对长上下文能力最直接的考验;
- 图片里的数字有没有读错——多模态模型最容易在数字识别上出问题;
- 输出格式能不能直接拿来用——决定了它能否真正嵌入你的工作流。
这三条其实构成了一个务实的评估框架:召回(不漏)、准确(不错)、可用(格式对)。任何一环不达标,模型在真实场景里的价值都会打折扣。
小结:这次值得普通用户动手试一次
Qwen3.8 Flash 的意义不在于参数有多大,而在于它把「大参数、多模态、百万上下文」这套配置,通过在线体验中心的方式交到了普通账号手里,且推理成本因稀疏激活而可控。
对于经常要处理长合同、长笔记、图表报表的人来说,这类模型正好切中痛点。与其纠结技术名词,不如按上面的三步流程,拿一份自己手头最头疼的长材料去实测,用「漏没漏、错没错、能不能用」三个标准给它打分。
相关推荐
本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama、Chatbox、AnythingLLM搭建纯本地、可联网、带知识库的私人DeepSeek。涵盖蒸馏版模型选择、RAG知识库原理与API调用,隐私安全零门槛部署全流程干货。
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。