本地部署私人DeepSeek全攻略:联网+知识库+隐私安全
手把手教你用Ollama+AnythingLLM在本地免费部署DeepSeek,数据全程不离机。
本文系统梳理了在普通电脑上本地部署 DeepSeek 的完整方案。核心路径是:用 Ollama 运行蒸馏版模型(推荐32B,性能接近GPT-o1)、用 Chatbox 或 Page Assist 提供图形交互与联网能力、用 AnythingLLM 基于 RAG 架构构建私人知识库,并可通过 API 进行二次开发。文章解释了满血版(671B)与蒸馏版的区别、知识蒸馏原理、RAG 的"检索-增强-生成"三步流程及 Embedding 与向量数据库的作用。整套方案数据全程留在本地,免费、无内容限制、支持离线使用,普通用户按教程操作即可落地。
想用DeepSeek又担心数据泄露、平台限制或付费门槛?本地部署一套完全由自己掌控的私人大模型,是当前隐私敏感场景下最实用的方案。本文基于一份B站教程的完整拆解,把从模型选择、框架安装到知识库搭建、API调用的全流程梳理清楚,普通用户也能照做。
为什么选择本地部署
本地部署大模型的核心吸引力可以概括为六点:免费使用、数据私密、无内容限制、离线可用、低延迟、支持自定义知识库微调。无论是个人日常使用还是处理企业内部资料,数据全程留在本机,不必担心上传到第三方服务器。
但本地部署有一个绕不开的现实限制——吃硬件。普通电脑根本带不动DeepSeek的满血版。所谓满血版指的是拥有6710亿(671B)参数的完整版本,能力极强,但对显存和算力的要求高到普通人难以承受。
满血版与蒸馏版:先搞懂模型命名
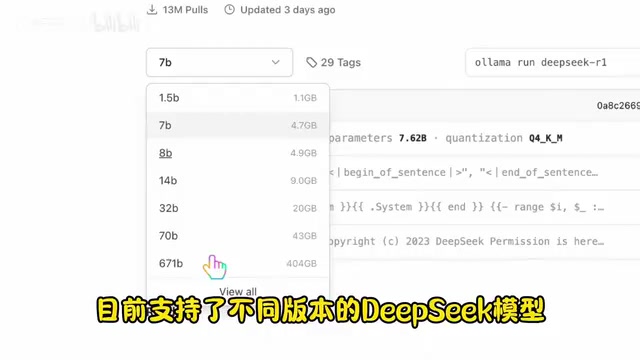
本地跑的DeepSeek通常都是蒸馏版。知识蒸馏是一种把大模型中的核心知识迁移到更小模型的技术,能在保持较高性能的同时大幅降低对算力的需求。目前蒸馏版本的参数量从1.5B到70B不等。
理解模型命名很重要。以「DeepSeek-R1-Distill-Qwen-32B」为例:R1是主模型名,Distill代表这是蒸馏版本,Qwen表示它基于阿里千问模型蒸馏而来,32B则是参数量——B即billion(10亿),32B约等于320亿参数。参数量越大,模型表达能力和复杂度越高,对资源需求也越高。
从公开对比数据看,DeepSeek-R1的32B蒸馏版在多数场景下的表现与GPT的o1、DeepSeek V3不相上下,是普通用户兼顾性能与成本的甜点选择。如果硬件条件允许,也可直接部署671B满血版,国内阿里云、腾讯云等厂商都提供了一键部署R1的方案,但本质上还是在卖设备。
知识蒸馏(Knowledge Distillation)的核心思路是用一个已训练好的大模型(教师模型)来指导小模型(学生模型)的训练,让小模型不仅学习真实标签,还学习教师模型输出的概率分布——这种"软标签"包含了更丰富的类间关系信息。以 DeepSeek-R1 的蒸馏版为例,研究团队用完整的 671B 模型生成高质量推理数据,再用这批数据微调 Qwen、Llama 等更小的基座模型,使其在推理能力上远超同参数量级的普通模型。这也解释了为什么 32B 蒸馏版能接近 GPT-o1 的表现:它继承的不只是压缩后的权重,而是大模型经过强化学习后形成的推理"思维链"模式。
用Ollama:成本最低的部署方式
目前主流且成本最低的本地部署方式是通过 Ollama。它是一个开源的本地大模型运行框架,专为在本地机器上部署和运行大模型设计,与市面上主流的本地AI工具兼容性都很好。
安装过程极其简单:访问 Ollama 官网,下载适用于对应系统(Windows/Mac/Linux)的安装包,双击按提示完成即可。安装成功后,命令行执行 ollama --version 可验证,同时 Ollama 会在本地监听 11434 端口。
下载并运行模型只需一条命令:ollama run 模型名称。如果本地没有该模型,会自动触发下载。在 Ollama 官网的模型列表里可以查到各版本 DeepSeek 模型及其所需磁盘空间,其中 DeepSeek 相关模型的下载量已接近1300万次,热度可见一斑。
用Chatbox提升交互体验
命令行交互对普通用户并不友好。Chatbox 是一个开源客户端,支持大部分主流模型接入,既能连本地部署的模型,也能接第三方服务商,跨平台且交互体验好,GitHub 上已有约29K Star。
配置方法:下载对应系统的客户端后,进入设置,模型提供商选择 Ollama,API 域名填本地的 11434 端口,它会自动识别本机已安装的 Ollama 模型。
值得一提的是,通过 Chatbox 配合硅基流动(SiliconFlow)也能方便地体验满血版 DeepSeek R1——注册账号、生成 API 密钥、在 Chatbox 中填入即可。硅基流动是付费服务,会赠送一定免费额度,用完需自付。
不过 Chatbox 的联网功能只支持部分模型。要让本地模型也能联网,可以用浏览器插件 Page Assist——同样开源,本来是给本地 AI 提供交互页面,最大特点是方便支持联网搜索,且所有交互都在本地完成。安装后点击图标,它会自动检测运行中的 Ollama 及已装模型,对话框底部的地球图标即为联网搜索开关。
用AnythingLLM打通本地知识库
要让本地模型基于自己的资料回答问题,核心技术是 RAG(检索增强生成)架构。简单理解就是「找资料—整理资料—回答问题」三步:先在知识库中检索与问题相关的内容,整理成上下文,再交给大模型生成精准且有依据的答案。
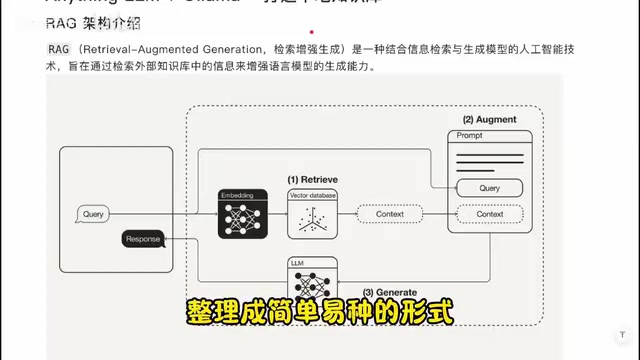
RAG 涉及三个关键概念:LLM(大语言模型)、Embedding(嵌入)、向量数据库。Embedding 通过专门模型把文本、表格等数据转换成机器能理解的向量,语义相近的内容在向量空间中距离更近(如「苹果」和「水果」接近,「苹果」和「汽车」较远);向量数据库负责高效存储和检索这些向量。检索(R)、增强(A)、生成(G)三步串起来,就是完整的 RAG 流程。
落地工具推荐 AnythingLLM,一款基于 RAG 架构的本地知识库工具,能把文档、网页等资料与本地大模型结合,构建个性化知识库系统。
配置要点:
- 选择大模型:选 Ollama,自动读取本地已装模型。
- Embedding 模型:默认可用 AnythingLLM 自带的免费模型,若追求准确度,OpenAI 的 Embedding 更强,但需联网付费。
- 向量数据库:默认 LanceDB,完全本地运行且免费。
- 工作区(Workspace):不同工作区可设置不同知识库,互相隔离。
RAG 与直接把文档塞进上下文(Long Context)的本质区别在于:Long Context 受限于模型的最大 Token 窗口,文档稍长就会被截断或使模型注意力分散;而 RAG 只把与当前问题最相关的片段检索出来送入模型,既节省算力,又能聚焦关键信息。Embedding 模型的质量在此至关重要——它决定了"语义相似"的判断是否准确。本地免费的 Embedding 模型通常基于较小的参数量训练,对中文语义的细粒度理解略逊于 OpenAI 的 text-embedding-3 系列;如果知识库以中文专业文档为主,也可考虑使用智谱 AI 或 BGE 等针对中文优化的开源 Embedding 模型作为替代。
知识库质量决定回答效果
知识库结构的好坏直接影响回答质量,理想的知识库应层次清晰、易于检索。AnythingLLM 支持多种文件类型:TXT、Markdown 等文本文件,PDF、Word 等文档,CSV、JSON 等数据文件,也支持直接粘贴网页链接构建知识库。
实测中,上传结构化的 Markdown 数据后询问商品价格,模型能精准返回结果;而网页多属非结构化数据,效果相对一般,建议先在本地处理成 AI 友好的结构再上传。
AnythingLLM 还内置了较强的 Agent 能力,包括网页深度抓取、图表上传、连接数据库、Web 搜索等。测试联网可用免费的 DuckDuckGo 或 SearXNG,在聊天窗口输入 @ 即可调起 Agent 能力。
进阶:通过API灵活定制
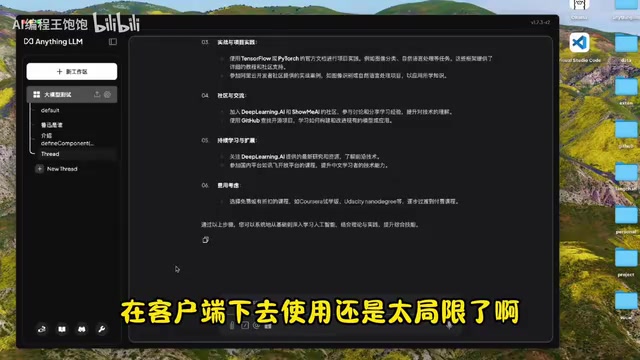
仅在客户端使用仍有局限。AnythingLLM 提供 API 调用能力,可用代码定制使用场景,比如搭建私人知识管理工具、企业内部客服等。
理解两个核心概念很关键:Workspace 是独立环境,知识库数据和设置都独立存在;Thread 代表工作区下的每一次对话记录,聊天必须在 Workspace 下的 Thread 中发起。
在设置的 API Keys 中创建密钥后,官方提供了详细的 API 文档和在线测试功能。最主要的接口是 Workspace-Thread 下的 chat 接口,需要 workspace slug 和 thread slug 两个必填参数。其中 workspace slug 无法在客户端直接查看,需通过接口返回值获取。拿到参数后,用文档提供的 cURL 示例即可构造代码,返回值中包含模型结果、检索到的知识库上下文及调用参数。
小结
整套方案的技术栈可以概括为:Ollama 负责跑模型、Chatbox/Page Assist 负责交互与联网、AnythingLLM 负责知识库与 Agent、API 负责二次开发。全程数据留在本地,兼顾隐私、离线与零平台限制。对普通用户而言,客户端已足够;对有编程能力的人,API 打开了构建更灵活 Agent 和工作流的空间。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。