同一提示词实测AI建模:Astra、Opus 5.5、Sol 6.1谁更强
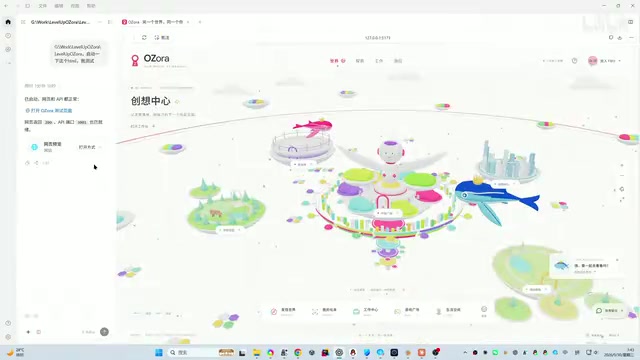
同一道OZ还原题横向评测,Astra观感最佳,Opus细节最丰,新款Sol明显掉队
B站UP主「Level Up」用还原《夏日大作战》OZ虚拟世界这道题,对Astra、Opus 5.5、GPT-6.1 Sol三款AI做了横向对比。Astra凭借对整体构图和留白的把握夺得最佳观感;Opus 5.5细节最为丰富,竞技场分层看台、角色定制等内容做得更满;新上市的Sol 6.1元素齐全却缺乏整体辨识度,与官方「接近Astra」的定位存在落差。测试揭示了一个关键认知:功能清单的丰富程度不等于最终观感,细节数量与整体打动人是两件需要分开衡量的事,而选模型也不能只靠参数与宣传,亲自跑实际项目才能验证真实能力。
最近的AI建模演示有个共同特点——你给它一句话,它就能生成一个完整的三维世界。从GPT系列到Astra、Opus 5.5,一个比一个热闹,三维场景、游戏、网站都能一键生成,看得人非常想亲自试一把。
为了把这些模型的真实能力放在同一标尺下检验,B站UP主「Level Up」用同一道题目——还原《夏日大作战》里的OZ虚拟世界——对Astra、Opus 5.5、Sol 6.1三个版本做了一次横向对比。结论先放出来:Astra整体观感最佳,Opus 5.5细节最多,而刚上市的Sol 6.1这次表现明显掉队。
为什么选OZ世界作为测试题
OZ这个虚拟世界非常适合检验AI的还原能力。它有大片白色留白空间、悬浮的岛屿、彩色的环形结构,还有在空中流动的晶莹元素。单独拿出每一个元素似乎都不难——球体、圆环、建筑,拼一拼就能有个大概。
真正的难点在于,把这些元素放在一起之后,观众还能不能一眼认出「这就是记忆里的OZ」。构图不是把东西塞满就会变好,关键在于哪里应该留白、哪里应该集中细节,主体和周围小岛的比例关系一旦不对,味道就变了。
更关键的是,这次任务做的是一个能在浏览器里运行的三维网站,既要有场景,也要有角色和交互。任务链条越长,越容易出现「前面做了构图,后面补功能又把画面挤乱」的问题。所以这次真正要考察的,是模型能不能把一个复杂想法从头到尾落成一个还能看的完整作品。
《夏日大作战》(Summer Wars)是日本导演细田守2009年的动画电影,其中虚构的网络虚拟世界「OZ」以极高的视觉辨识度著称:洁白的背景、大量悬浮的几何岛屿、色彩鲜明的环形建筑群,以及代表亿万用户账号的卡通形象在空中流动。正因为这个世界的视觉特征被大量观众熟记,它既能作为还原测试的明确参照,又能通过观众的直觉反应来判断AI输出结果是否「对味」——这是随机生成场景做不到的。选取一个有强烈集体记忆的视觉素材作为测试基准,是一种常见的AI能力评估方法:它规避了「生成结果无法衡量好坏」的困境,把判断标准从主观美感锚定到「与原作的相似度」上。
Astra:整体观感最打动人
Astra是UP主个人最喜欢的版本。它最大的优势在于整体观感——眼睛看场景时其实是先看大轮廓,再看颜色分布,最后才会去数有多少建筑、多少装饰。Astra这一版让人愿意先停下来,把整个世界完整看一遍。
对还原类任务来说,这一点尤为重要。因为既然有明确目标、观众脑子里也有对照,最先需要建立的就是那种熟悉的感觉,然后再一点点往里补内容。Astra在环形结构和浮空区域的组织上做得比较到位,主体没有被周围元素拖垮,颜色也没有互相打架。
当然,喜欢归喜欢,它远没有达到电影级还原。镜头拉近后,一些造型仍能看出程序生成和拼接的痕迹,电影里那种复杂又清晰的细节,仅靠第一版代码模型还做不出来。工程层面,Astra还做了角色定制、区域切换、工作面板、小游戏等内容,对一个长任务来说,兼顾这些确实比单独做一张漂亮截图复杂得多。UP主的总结是:方向对、整体效果最符合期待,但细节还值得继续打磨。
Opus 5.5:细节最舍得堆
Opus 5.5给人的感受很明确——细节更多,内容更满。越是愿意把镜头拉近、在各个区域逛一逛的时候,它越能提供更多值得看的东西。
以竞技场为例,工程里做到了分层看台、观众小人和不同的运动设计。这些单独说出来都是小事,但加在一起,就让一个地方从「这里放了个圆形建筑」变成「这里看起来真的有一片运动区域」。此外,角色定制的六边形入口、格斗相关的表现,Opus也花了不小篇幅去做,能明显感觉到它想把细节继续往里贴。
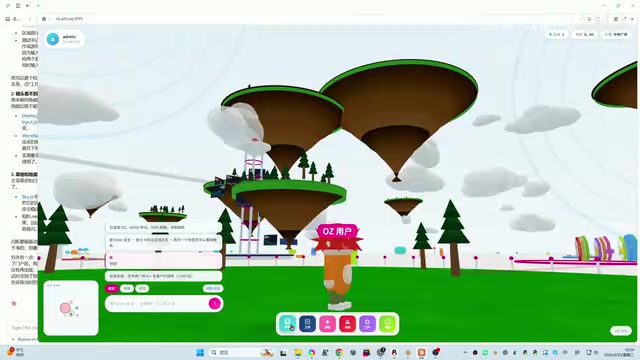
如果只问谁更舍得做细节,这次票会投给Opus。但UP主最终仍更偏爱Astra,原因在于:细节数量和最终观感是两件需要分开看的事。OZ本身就很考验留白,局部做得更好固然有意思,可当镜头退回全景,还要重新审视它和整个世界的关系。局部吸引人和整体打动人,不一定发生在同一份结果里——这正是这次对比最有意思的地方。
Sol 6.1:官方定位与实测的落差
Sol 6.1(即GPT-6.1 Sol)是当天刚上市的最新模型,官方定位很吸引人:以更低的成本,在复杂工作上提供接近Astra的表现。正因如此,把它拿来做同一个项目时的期待值并不低。
但结果让UP主直言「翻车了」。它并非完全没做东西——工程里同样有三维场景、角色和一些交互,拿着需求清单去对照,确实能找到不少对应内容。问题在于,当这些内容拼成最终画面时,没能呈现出想要的效果。
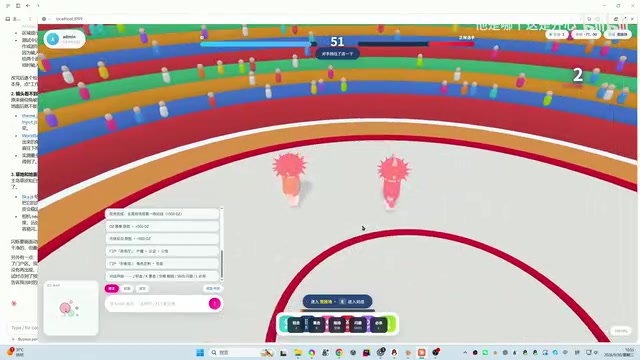
这很像一份「交差式」答卷:题目要求的名词都出现了,金鱼、浮岛、圆环这些元素都在,但整个答案离题目真正想要的东西还差一截。这次任务需要的是一个有辨识度的世界,光有零散元素还不够,更重要的是它们最后能否共同组成那个熟悉的画面。
需要强调的是,官方说的「接近Astra」是针对复杂工作的整体定位,并没有保证在这道具体的三维场景题上两个模型就能做得一样好。所以不能从这一次结果直接推导出「Sol什么都不行」。能确定的只是:在这次相同提示词的二次还原中,它最不符合预期。
GPT-6.1 Sol是OpenAI在GPT-4系列之后推出的分级模型策略中的一个档位,「Sol」这一名称代表该系列中主打性价比的版本,而「Astra」则对应旗舰档位。这种命名与分层定价策略在AI模型行业逐渐普遍:同一代底层架构下,厂商会针对算力消耗与任务复杂度推出高、中、低多个变体,供开发者按需选择。Sol的官方卖点是「用接近Astra的能力覆盖复杂任务,但API调用成本更低」。这意味着它的预期受众是有成本压力但仍需处理较高难度任务的开发者,而非追求极致输出质量的用户。在本次测试中,这种定位差异在三维创意还原场景下被放大,暴露了「复杂任务」的官方描述与创意类生成任务之间的语义落差。
评测的启示:别被功能清单带偏
这次对比最值得玩味的一点是:做这类项目时,最容易被带偏的地方,就是模型写了很多代码、列了一长串功能,人就下意识觉得它完成得很好。但回到任务本身,最重要的标准仍是——它交出来的东西,有没有让你觉得「像」。
这也解释了为什么新模型发布后,亲自拿一个实际项目去试仍有价值。宣传里的能力,最终要变成屏幕上能看到的结果,才真正有意义。同样一道题,换个题目,三个模型的表现完全可能反过来,因此这次的排名只是针对本次任务,而非给模型永久贴标签。
对普通用户来说,这轮实测给出的参考是:选模型不能只看参数和宣传,整体观感、细节密度、完成度往往需要分开评估,而不同任务对这三者的权重也不一样。
「功能清单偏差」(feature list bias)是AI产品评估中的一个常见认知陷阱:当模型输出包含大量可见的功能点——代码行数多、模块划分细、命名规范——评估者往往会高估其完成质量,而忽视这些功能是否真正服务于核心目标。这一现象在软件工程项目评审中同样存在,被称为「交付物数量与交付物价值的混淆」。对AI生成内容而言,这种偏差尤为突出,因为语言模型天然擅长输出结构完整、词汇丰富的文本,容易让人误以为「写得多=做得好」。真正有效的评估往往需要退一步,用任务的原始目标——而非模型的输出量——作为衡量尺度。
相关推荐
用n8n搭建WhatsApp智能线索自动化:AI分级让商机不再流失
拆解一个基于n8n的WhatsApp线索自动化工作流:用AI把客户消息分为hot/warm/cold四级,自动应答并评分,仅在高价值线索出现时通知老板,帮助中小企业高效管理商机、节省人力。

Arabagent.ai:面向中东市场的托管式N8N自动化方案
Arabagent.ai 面向中东市场提供托管式 N8N 自动化服务,含私有工作空间、无限工作流执行、AI 自愈架构及阿拉伯语双语支持,兼顾开源可控性与 SaaS 便捷。

用 n8n 打造 Gmail→Google Sheets 自动化 CRM 实战教程
手把手教你用 n8n 搭建 Gmail 到 Google Sheets 的 AI 自动化 CRM:收到邮件自动触发,由 OpenAI 读取理解内容并提炼任务信息写入待办表格,含触发器、AI 智能体、提示词与 Sheets 工具的完整配置步骤。