投稿JMLR是什么体验?跨学科PhD的真实困惑与考量

CS博士生因统计学导师tenure需求而考虑投JMLR,揭示两套学术文化在发表体系上的深层冲突。
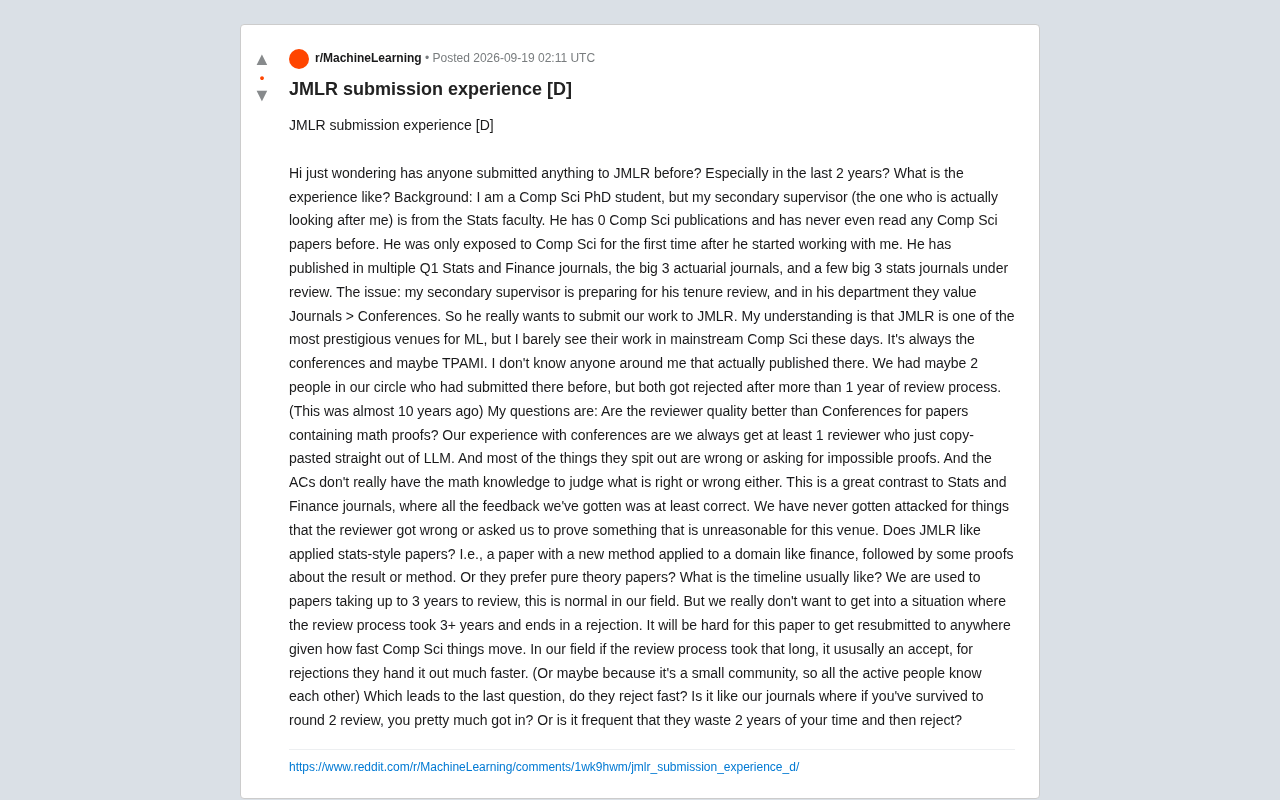
一位CS方向博士生在Reddit发帖,询问向JMLR投稿的真实体验。其统计学导师为应对tenure评审(统计系重期刊而非会议),希望将合作成果投至JMLR。发帖者的核心困惑涵盖四个维度:JMLR对数学证明类论文的审稿质量是否优于频繁出现LLM复制审稿的顶会;JMLR是否接受"新方法+领域应用+理论证明"的跨学科风格;漫长审稿周期(可能长达三年)一旦以拒稿告终对CS成果的致命打击;以及JMLR是否存在"久审即录"的潜规则。这一问题折射出机器学习领域一个长期存在的结构性张力:CS文化以会议为主战场,而与统计、金融等学科交叉的研究者却需要在两套截然不同的发表逻辑中寻找栖身之所。
一个跨学科投稿难题
Reddit机器学习板块上,一位计算机科学(CS)方向的博士生抛出了一个颇具代表性的问题:向JMLR(Journal of Machine Learning Research)投稿到底是怎样的体验?尤其是近两年内投过稿的人,能否分享一些第一手经历?
这位博士生的处境有些特殊。他的第二导师(也是实际带他的导师)来自统计学院,此前几乎没有接触过计算机科学,没读过任何CS论文,直到与他合作后才第一次了解这个领域。这位导师在统计学、精算、金融等领域的Q1期刊上发表颇丰,拥有多篇顶级统计与精算期刊论文。
矛盾点在于:这位统计学导师正在准备终身教职(tenure)评审,而在他所在的院系,期刊(Journals)的分量远高于会议(Conferences)。因此他希望把两人合作的成果投到JMLR——这也引出了CS与统计学两套截然不同的学术评价体系之间的碰撞。
JMLR在CS圈的尴尬地位
发帖者坦言,他理解JMLR是机器学习领域最负盛名的发表场所之一,但在如今主流的计算机科学研究中,却很少见到JMLR的身影。占据视野的几乎总是各类顶级会议(NeurIPS、ICML、ICLR等),偶尔还有TPAMI这样的顶刊。
他身边没有任何人真正在JMLR上发表过论文。圈子里曾有两个人投过稿,但都在超过一年的审稿流程后被拒——而这还是将近十年前的事了。
这种观察其实点出了ML领域一个长期存在的结构性特征:会议才是CS/ML的主战场。由于领域迭代极快,会议凭借相对固定且较短的审稿周期,成为成果首发的首选。期刊虽然声誉高、审稿深入,但周期漫长,与快速演进的研究节奏形成张力。对于一个纯CS背景的研究者而言,把重量级成果压在期刊上确实是反直觉的选择。
JMLR(Journal of Machine Learning Research)创立于2000年,由Leslie Kaelbling等人发起,最初是对当时商业期刊高额版权费和漫长出版流程的抗议——所有内容完全开放获取,不收版面费。在深度学习浪潮兴起之前,JMLR一度是机器学习领域最权威的发表场所,Impact Factor长期居高,SVM、AdaBoost等奠基性算法的重要理论工作均发表于此。然而2012年之后,随着NeurIPS、ICML、ICLR的投稿量和影响力爆炸式增长,JMLR的相对地位在CS/ML社区中逐渐边缘化——不是因为质量下降,而是整个领域的发表文化被会议主导所重塑。值得一提的是,JMLR旗下还有JMLR: MLOSS(机器学习开源软件)和TMLR(Transactions on Machine Learning Research)等子刊,后者于2022年创立,采用OpenReview平台,试图以更快的滚动发表模式弥合期刊与会议之间的速度鸿沟。
审稿质量:会议的痛点与期刊的期待
发帖者提出的第一个核心问题很尖锐:对于包含数学证明的论文,JMLR的审稿人质量是否优于会议?
他描述了在会议投稿中反复遭遇的困境:几乎总会碰到至少一位直接复制粘贴LLM输出的审稿人,而这些内容大多是错误的,或者要求提供不合理、不可能的证明。更糟的是,领域主席(AC)往往也不具备足够的数学功底来判断谁对谁错。
这与他在统计和金融期刊的经历形成鲜明对比——那里收到的所有反馈至少都是正确的,从未因审稿人自身理解错误而被无端攻击,也没有被要求证明超出该场所合理范围的东西。
这一对比揭示了跨学科研究者的真实焦虑:当一篇论文的价值主要体现在数学严谨性上时,审稿人是否有能力、有耐心去真正读懂证明,直接决定了投稿的成败与体验。数学证明密集的工作,在以经验性结果为主、审稿周期紧张的会议体系里,天然处于不利位置。
ML顶会审稿质量下滑已成为社区广泛讨论的结构性问题。NeurIPS 2021的双盲实验曾揭示,同一批论文在两组独立审稿委员会间的接收决定仅有约50%一致性,接近随机。随着投稿量在2020年代急剧膨胀(NeurIPS年投稿量已超过一万篇),会议不得不大规模扩充审稿人库,导致大量缺乏相关专业背景的人承担审稿任务。LLM的普及进一步加剧了这一问题:部分审稿人直接使用语言模型生成审稿意见,而这些意见往往表面流畅却包含事实性错误,对数学证明类工作尤为有害——LLM在形式化推理上的局限性会产生看似合理实则错误的批评,作者难以在rebuttal阶段有效应对,因为AC同样可能缺乏独立判断的能力。这正是数学理论工作者对会议投稿感到沮丧的根本原因。
论文风格与审稿时间线的双重不确定
发帖者的第二个疑问关于JMLR的选稿偏好:它是否欢迎应用统计风格的论文——即提出一个新方法、应用到金融等具体领域、再辅以关于结果或方法的证明?还是更青睐纯理论论文?
这个问题对跨学科作者至关重要。一篇"新方法 + 领域应用 + 理论证明"的论文,恰好处在统计学期刊与ML场所审美的交界处,能否被JMLR接纳,直接关系到投稿策略。
第三和第四个问题则集中在时间成本上。他所在的统计/金融领域,论文审稿长达三年是常态;但他真正担心的是陷入"审了三年最后被拒"的最坏情况。因为CS领域迭代太快,一篇被拖了三年又遭拒的论文,几乎很难再改投他处。
他还提到一个有趣的领域惯例:在统计圈,如果审稿拖得很久,通常意味着接收;拒稿往往会更快地下达(他推测可能因为这是个小圈子,活跃的人彼此都认识)。由此他想知道——JMLR是否会快速拒稿? 是否像统计期刊那样"熬到第二轮基本就稳了",还是常常浪费你两年时间之后再给一个拒信?
跨越两种学术文化的抉择
这个帖子的价值,不在于它给出了答案,而在于它清晰地呈现了一位夹在两种学术文化之间的研究者所面临的现实困境:
- 评价体系冲突:CS重会议、统计重期刊,导师的tenure需求与学生的领域惯例背道而驰。
- 审稿质量顾虑:数学密集型工作在会议体系中容易遭遇不专业审稿,期刊或许更可靠,但缺乏亲身验证。
- 时间风险:漫长审稿周期一旦以拒稿收场,对快速迭代的CS成果几乎是致命打击。
对任何身处交叉学科、需要在不同发表文化间做权衡的年轻研究者来说,这些都是值得提前想清楚的问题。选择投稿场所,本质上是在声誉、审稿质量、时间成本与职业需求之间寻找最优平衡点。
终身教职(tenure)评审制度在不同学科的评价标准差异,是这一困境的制度根源。在北美大多数统计、数学、经济学等量化社科系,tenure评审委员会主要看重同行评审期刊论文的数量与质量,期刊的排名(Q1/Q2)和影响因子是可被外部评审人直接量化的指标。而在CS系,顶会论文(尤其是NeurIPS/ICML/ICLR/CVPR等A*级别会议)被视为等同甚至优于期刊的成果,部分院校甚至在tenure文件中明确列出"顶会论文等同于顶刊"。当一位教师的学术生涯成立于统计系的制度框架下,而研究内容又横跨机器学习领域时,投稿决策便不再只是学术选择,而是直接影响其职业生存的战略考量。对于合作的博士生而言,这种导师驱动的投稿策略可能与自身未来在CS学术市场的竞争力形成错位,值得在合作开始前明确讨论预期。
相关推荐
OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕爆料汇总:神秘全天候智能体"o"曝光,支持63种语言并针对长周期任务设计;超高速API扩容在即;同时Anthropic Sonnet 5.5与MiniMax M3.1 Flash相继发布,AI行业竞争白热化。

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。