Transformer 上下文学习新进展:参数 ODE 估计与预测
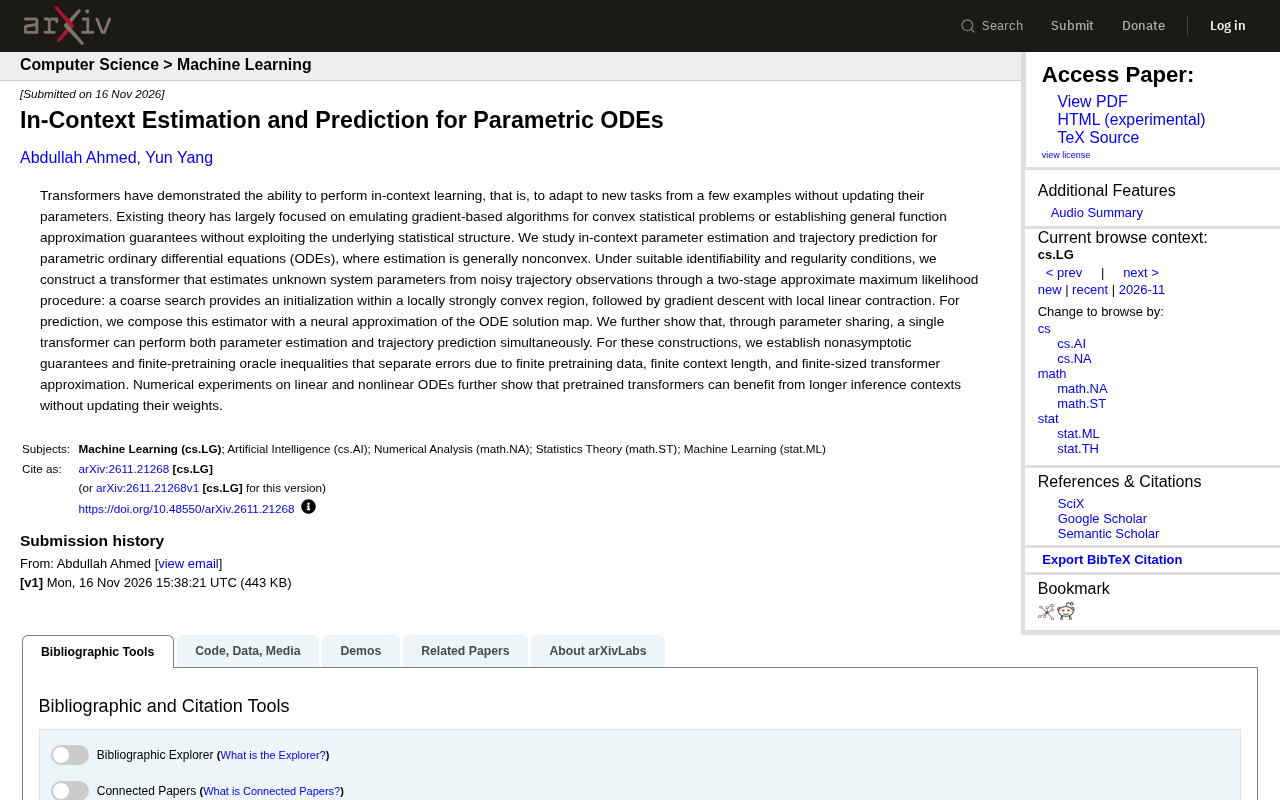
Transformer 通过两阶段近似极大似然,在非凸 ODE 参数估计与轨迹预测中实现有理论保证的上下文学习。
本文填补了 Transformer 上下文学习理论在非凸动力系统参数估计方面的空白。作者研究从含噪轨迹观测中估计参数化 ODE 系统参数并预测轨迹的问题,构造了一个两阶段近似极大似然流程的 Transformer:第一阶段粗搜索将参数定位到局部强凸区域,第二阶段用梯度下降保证收敛。借助可辨识性与正则性条件,理论分析不再依赖全局凸性。参数共享使单个 Transformer 同时完成参数估计与轨迹预测。作者建立了非渐近保证和有限预训练 oracle 不等式,将误差分解为预训练数据、上下文长度和模型规模三部分。实验表明,预训练 Transformer 无需更新权重即可从更长推理上下文中获益。
Transformer 的上下文学习(in-context learning)能力早已被实证研究反复确认——无需更新权重,仅凭少量示例就能适应新任务。但理论层面,现有工作大多集中在两类:要么证明 Transformer 能模拟凸统计问题的梯度算法,要么给出通用函数逼近保证,却很少触及问题本身的统计结构。
最近一篇关于参数化常微分方程(ODE)的研究补上了这块拼图。作者研究了从含噪轨迹观测中估计 ODE 系统参数并预测轨迹的问题,并给出了非渐近的理论保证。
为什么 ODE 参数估计是个难题
参数化 ODE 广泛用于描述动力系统,从物理建模到生物过程都离不开它。给定观测轨迹,反推系统参数是典型逆问题,而且通常是非凸的——这意味着目标函数可能存在多个局部极小,优化过程对初始化敏感。
这与上下文学习理论中常见的凸统计问题设定有本质区别。此前关于 Transformer 模拟梯度下降的分析,大多依赖凸性来保证收敛。一旦问题非凸,这些工具就不够用了。
研究的切入点在于:不要求全局凸性,而是借助可辨识性(identifiability)和正则性条件,把问题局部化处理。
两阶段近似极大似然:先粗搜,再精调
作者构造的 Transformer 采用两阶段近似极大似然流程:
第一阶段是粗搜索,目标是在参数空间中找到落在局部强凸区域内的初始化点。第二阶段从这个初始化出发,执行梯度下降,利用局部线性收缩性质保证收敛。
这个设计的巧妙之处在于把非凸问题拆成了"定位"和"收敛"两件事。粗搜索负责把参数拉到"地形良好"的区域,梯度下降只需在局部强凸的范围内工作,理论分析因此变得可控。
对于预测任务,作者将估计器与 ODE 解映射的神经网络近似组合起来:先估参数,再用参数驱动解映射生成轨迹预测。
局部强凸性是这里的关键技术条件。一个非凸函数在某个局部区域内可能满足强凸性,即该区域内 Hessian 矩阵的特征值有正下界。粗搜索阶段的任务就是把初始点送入这样的区域,一旦进入,梯度下降在强凸性下就能获得线性收缩率,收敛速度有保证。这与全局凸性假设的区别在于:作者不要求整个参数空间都“地形良好”,只要求存在这样一个可被搜索到的局部盆地。可辨识性和正则性条件则保证了真参数附近确实存在这样的强凸区域,且不同参数对应的轨迹可分,从而使估计问题在局部是良定的。
一个 Transformer 同时做两件事
论文还展示了通过参数共享,单个 Transformer 可以同时完成参数估计和轨迹预测。这不是简单的多任务拼接,而是利用了两种任务共享的统计结构。
理论结果方面,作者建立了非渐近保证和有限预训练 oracle 不等式,把误差来源拆解为三部分:有限预训练数据带来的误差、有限上下文长度带来的误差、以及有限规模 Transformer 逼近带来的误差。这种分解方式让每个因素对最终性能的贡献变得清晰。
有限预训练 oracle 不等式是统计学习理论中刻画估计器性能的标准工具。它的含义是:以某个“oracle”估计器(通常是假设拥有无限数据或最优算法时的理想估计器)为基准,给出学习算法相对于该基准的误差上界,且该上界对样本量、模型容量等有限因素显式依赖,而非仅在渐近意义下成立。本文中,这个不等式将 Transformer 的预测误差分解为预训练数据误差、上下文长度误差和网络逼近误差三项。这种非渐近分解的意义在于:它明确告诉我们在有限资源下哪一项是瓶颈,从而指导实践中的资源分配(例如是增加预训练数据还是延长推理上下文)。
实验观察:更长的上下文确实有用
数值实验覆盖了线性和非线性 ODE。一个值得注意的现象是:预训练后的 Transformer 能从更长的推理上下文中获益,而不需要更新任何权重。换句话说,上下文长度本身就是一种"免费"的精度提升手段——至少在这些 ODE 任务上成立。
这与上下文学习的一个核心直觉吻合:模型在预训练中已经学到了某种隐式的算法行为,推理时提供更多观测相当于给这个隐式算法更多信息。
对上下文学习理论的意义
这项工作把上下文学习的理论分析从凸统计问题推进到了非凸动力系统参数估计。它的价值不只在 ODE 本身——非凸性是大量实际逆问题的共性特征,两阶段"粗定位+局部收敛"的构造思路,可能为更广泛的非凸上下文学习任务提供分析模板。
当然,理论保证依赖于可辨识性和正则性条件,这些条件在实际系统中是否普遍满足,仍需具体问题具体分析。实验目前也集中在相对可控的 ODE 场景,向更复杂系统的迁移是后续值得关注的方向。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。