Transformers 5.18.0 发布:四款新模型加持多模态与说话人分离

Hugging Face Transformers 5.18.0 新增四款模型、六项破坏性改动及大量分布式与量化能力升级。
Transformers 5.18.0 是一次功能与稳定性并重的迭代。新模型方面,Nemotron 3 Diarization 带来流式说话人分离能力,NemotronH Omni 实现文本、图像、视频、音频的联合推理,HyperCLOVAX Vision V2 提供带链式推理的视觉语言能力,GTE 则为多语言长文本检索场景提供现代化编码器。基础设施层面,版本统一了 device_mesh 以支持 PP+TP 混合并行,并实现了 FSDP2 与专家并行的结合;GGUF 新增 MoE 支持,FP8 kernel 扩展到 MPS 平台,同时引入 OpenVINO 导出器。与此同时,六项破坏性改动涉及 ROCm 路由、DETR 预处理、DINO 现代化等关键路径,使用相关功能的团队在升级前需进行充分的回归测试。
Hugging Face Transformers 库发布了 5.18.0 版本,本次更新由维护者 vasqu 推送,包含四款全新模型架构、六项破坏性改动以及大量错误修复和性能优化。对于依赖 Transformers 构建生产系统的开发者而言,这是一个功能与稳定性并重的迭代。
四款新模型:覆盖语音、多模态与文本检索
本次版本最大的看点是新增的四款模型,分别瞄准不同的应用场景。
Nemotron 3 Diarization:流式说话人分离
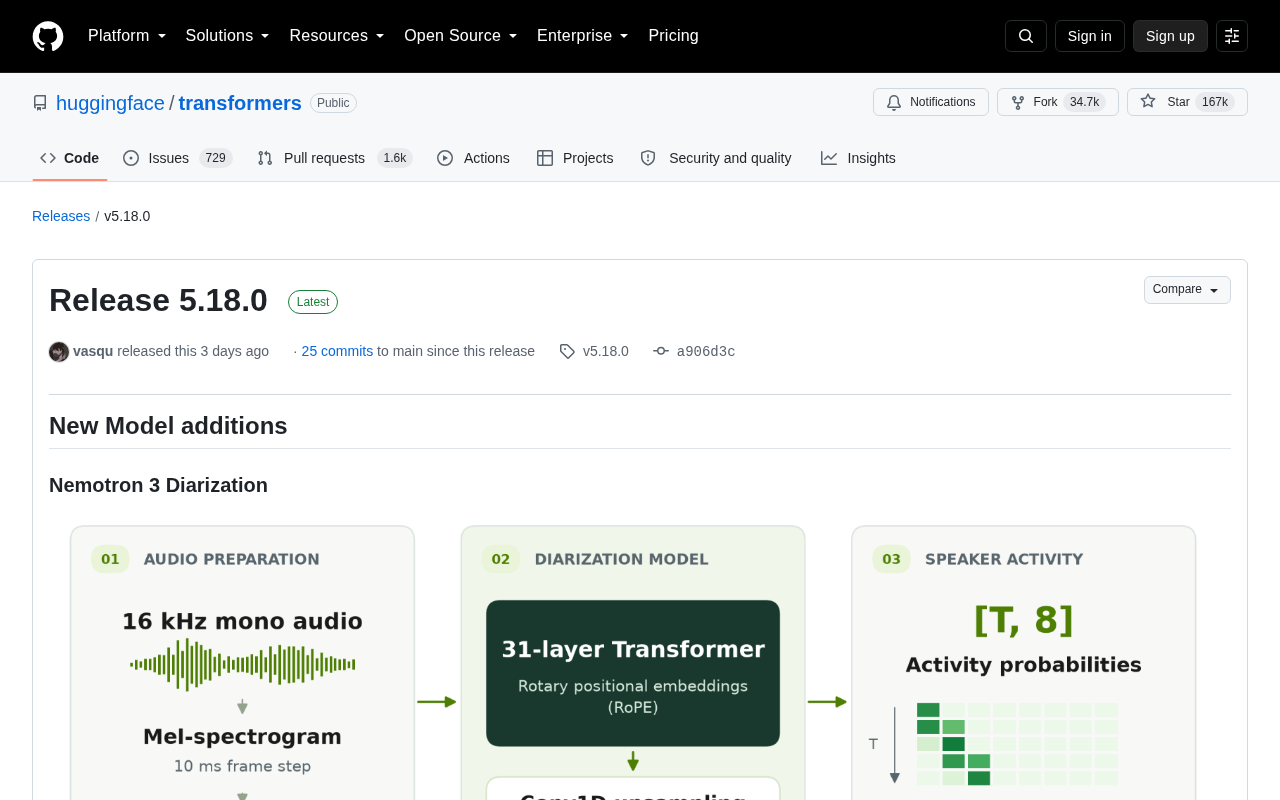
Nemotron 3 Diarization 是一款开放权重的流式说话人分离模型,核心任务是解决「谁在什么时候说话」这一问题。它同时支持流式和离线推理,最多可处理八位说话人,并按照每位说话人在音频中首次出现的顺序排列输出结果。
该模型采用了为 Streaming Sortformer 引入的到达顺序说话人缓存(Arrival-Order Speaker Cache, AOSC)与 FIFO 队列机制。值得关注的是,单个检查点即可支持从 80 毫秒输入缓冲到 30.4 秒离线式缓冲的多种延迟配置,输出帧分辨率也可按 10 毫秒的倍数灵活调整。借助分块推理,音频最大时长不受限制,这让它在实时会议转录、客服录音分析等场景中具备很强的工程实用性。
说话人分离(Speaker Diarization)是语音处理领域的经典难题,目标是在无需预先知道说话人身份的前提下,自动标注「谁在何时说话」。传统方案通常分为三步:先进行语音活动检测(VAD),再提取说话人嵌入向量,最后通过聚类算法合并同一说话人的片段。这种级联流程的缺点是各阶段误差会累积,且难以支持低延迟的流式场景。Sortformer 是 NVIDIA 提出的端到端分离框架,通过引入「到达顺序」约束来解决输出排列不确定性问题——在多说话人场景中,模型输出哪个通道对应哪个人,传统方法往往依赖置换不变训练(PIT),而 AOSC 机制改为按说话人在音频中首次出现的时间顺序固定分配通道,从根本上消除了排列歧义,也使流式输出在时间维度上保持一致性。
NemotronH Omni:联合推理的多模态模型
NemotronH Omni 是 NVIDIA 推出的多模态推理模型,将 NemotronH 的 Mamba-Transformer 混合语言模型与 RADIO 视觉编码器以及可选的 Parakeet 声音编码器结合在一起。图像和视频 patch 通过 RADIO 塔和 pixel-shuffle MLP 投影进语言模型的嵌入空间,占据 <image>/<video> 上下文位置;音频片段则以相同方式投影到 <audio> 位置。
最终形成的是一个能够对文本、图像、视频和声音进行联合自回归推理的单一模型。这种统一的多模态架构正是当前前沿研究的主流方向,Mamba-Transformer 混合骨干也为长序列处理带来了效率优势。
Mamba 是一种基于选择性状态空间模型(Selective SSM)的序列建模架构,其核心优势在于推理时的计算复杂度与序列长度呈线性关系,而标准 Transformer 的自注意力机制则是二次方复杂度。Mamba-Transformer 混合架构将 Mamba 层与标准注意力层交替堆叠,试图兼顾 Mamba 在长序列下的效率优势和 Transformer 在局部精细建模上的能力。RADIO 是 NVIDIA 提出的视觉基础模型,通过蒸馏多个视觉-语言预训练模型(如 CLIP、DINOv2、SAM)的知识,生成兼顾语义对齐与细粒度特征的视觉表征,适合作为通用视觉编码器插入多模态系统。pixel-shuffle MLP 投影则是一种常见的分辨率压缩手段,将空间上相邻的像素 patch 在通道维度重新排列,从而在不丢失信息的情况下降低 token 数量,减轻语言模型的序列长度压力。
HyperCLOVAX Vision V2 与 GTE
HyperCLOVAX Vision V2 是 NAVER 开发的视觉语言模型,采用 HyperClovaX 语言模型骨干搭配 Qwen2.5-VL 视觉编码器,支持文本、图像和视频输入,并通过内置的思考标记(<think>...</think>)实现链式推理能力。
GTE 则来自论文《mGTE: Generalized Long-Context Text Representation and Reranking Models for Multilingual Text Retrieval》。它是一款 BERT 风格的双向编码器,用 RoPE 替代绝对位置嵌入,采用门控 MLP,并在每个残差连接后应用层归一化。同一架构支撑了阿里巴巴的 gte--v1.5、gte-multilingual- 系列以及 Snowflake 的 snowflake-arctic-embed-m-v2.0 等检查点,对做文本检索和重排的团队非常友好。
RoPE(Rotary Position Embedding,旋转位置嵌入)是一种相对位置编码方案,通过在注意力计算中对查询和键向量施加与位置相关的旋转变换,使模型能够天然感知 token 之间的相对距离,同时对绝对位置保持一定的外推能力。与传统绝对位置嵌入相比,RoPE 在长文本场景下的泛化性更好,因此被越来越多的编码器模型所采用。门控 MLP(Gated MLP,也称 SwiGLU 或 GeGLU)则是在标准前馈层中引入一个门控分支,输出为两条并行线性变换的逐元素乘积,实践中通常能在相同参数量下带来更好的表达能力。GTE 将这两项技术引入 BERT 风格的双向编码器,使其在长文本检索和多语言场景下的表现显著优于原始 BERT 架构。
破坏性改动:升级前务必检查
5.18.0 引入了六项标记为「🚨」的破坏性改动,升级时需要特别留意:
- ROCm 平台的 gpt-oss 将 FA3 路由到 aiter-flash-attn,并生成 ROCm fixtures;
- DETR 图像处理加速,可能影响依赖旧预处理行为的流水线;
- 重映射 indexers 的 layer_type;
- 修复 Transformers 后端视频输入的 token 计数(针对 vLLM);
- DINO 系列模型现代化改造,使其符合当前标准;
- Kernels 版本升级。
这些改动意味着部分已有代码在直接升级后可能出现行为变化,尤其是使用 ROCm 推理、DETR 目标检测或 vLLM 后端的用户,建议在升级前充分测试。
大规模修复与并行能力增强
除了新模型,本次版本还包含海量的 bug 修复和改进,其中几个方向值得单独点评。
分布式与并行推理
版本统一了 device_mesh 的初始化,以支持流水线并行(PP)+ 张量并行(TP)推理;同时通过二维(fsdp, tp)device mesh 实现了 FSDP2 与专家并行(Expert Parallelism)的结合。配合 PEFT × DTensor 的 TP 集成,这些改动显著提升了大模型在多卡环境下的训练与推理灵活性。
现代大模型训练与推理通常需要组合多种并行策略:张量并行(TP)将单层的权重矩阵拆分到多张卡上同步计算;流水线并行(PP)将模型按层切分,不同设备处理不同深度的层,形成流水线;而全分片数据并行(FSDP)则将模型参数、梯度和优化器状态分散存储到多个 rank 上,按需聚合。PyTorch 的 device_mesh 是一个逻辑设备网格抽象,允许开发者用二维甚至多维网格来描述 TP × PP × DP 的组合关系,从而统一调度通信原语。专家并行(Expert Parallelism)是混合专家模型(MoE)特有的并行维度,将不同专家子网络分配到不同设备,与 FSDP 结合时需要额外处理路由 token 的跨设备通信,本次对 FSDP2 + EP 的支持是在这一方向上的重要工程进展。
缓存与生成逻辑
持续批处理(CB)的缓存被升级以支持不同的注意力类型,并新增了暂停机制。生成相关逻辑也得到简化,包括让所有方法和 logits 处理器对 lm_head 输出尺寸保持无关、修复辅助解码(assisted decoding)在丢弃 attention mask 后的问题,以及正确约束辅助解码的最大长度和 EOS token。
量化与硬件适配
GGUF 集成新增了对 MoE 的支持,并更新了 tokenizer 与 kernels 路径;compressed-tensors 的 FP8 kernel 现可在 MPS(torch ≥ 2.15)上运行;此外版本还引入了 OpenVINO HF 导出器,为在 Intel 硬件上部署模型提供了新路径。XPU 和 MUSA 平台的 Flash Attention 支持也得到补充。
对开发者的实际意义
从整体上看,5.18.0 延续了 Transformers 一贯的节奏:一边吸纳社区和厂商提交的新模型,一边打磨分布式、量化和生成等核心能力。四款新模型分别覆盖流式语音、多模态推理和文本检索,几乎对应了当前 AI 应用的主要赛道。
对于生产团队,升级决策的关键在于权衡新特性收益与破坏性改动的迁移成本。如果你正好需要说话人分离或多模态联合推理能力,这个版本非常值得尝试;如果仅依赖稳定的既有流水线,则应重点评估那六项 🚨 改动是否影响现有代码。无论哪种情况,在升级到生产环境前进行充分的回归测试都是必要的。
相关推荐

离子推进器:赢得太空竞赛的慢速火箭
离子推进器以极低推力、极高效率成为太空深空探测与货运物流的关键技术。本文解析离子引擎的工作原理、氙气推进剂的选择、太阳能与核电推进的权衡,以及它为何可能成为建造星际文明的"慢速火箭"。

人类造过最快的东西:帕克太阳探测器的43万英里时速
人类建造过最快的物体不是旅行者号或火箭,而是NASA帕克太阳探测器,时速约43万英里。本文解析它如何借助金星引力辅助与太阳引力井加速,以及为何以光速衡量人类仍刚刚起步。

美光CEO警告:内存供应将在未来两年持续趋紧
美光CEO表示存储芯片供应将在未来两年比当前更为紧张,AI需求激增与产能扩张滞后是主因。本文分析内存供应趋紧的原因及其对市场和消费者的影响。