TS2Vec变身基础模型:1.6M参数冻结编码器接近SOTA

TS2Vec经三项改造变为1.6M参数基础模型,冻结编码器接近SOTA。
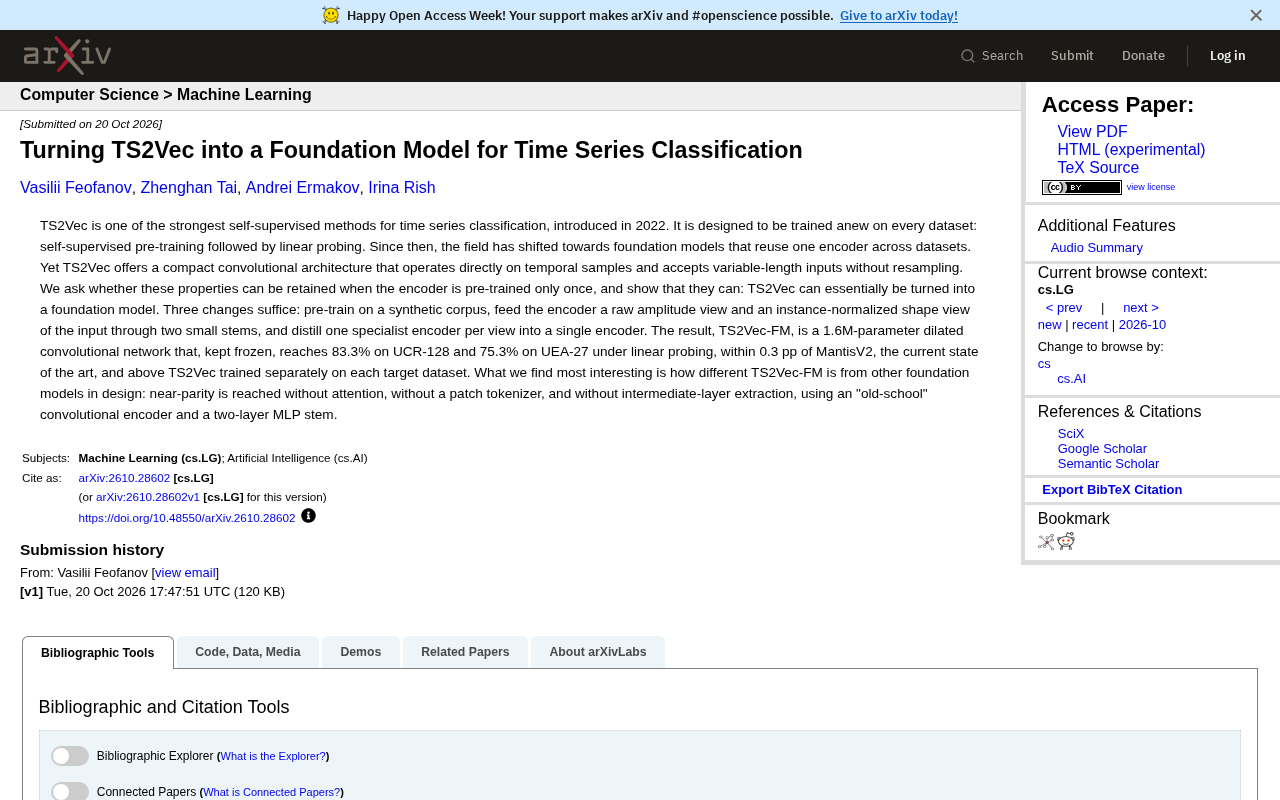
本文介绍了一项将经典时间序列自监督方法TS2Vec转变为基础模型的研究。TS2Vec原本需在每个数据集上单独预训练,无法复用。研究者通过三项关键改造——在合成语料上一次性预训练、双视角输入设计(原始振幅视图和实例归一化形状视图)、以及通过蒸馏将两个专家编码器融合为单一编码器——构建了TS2Vec-FM。该模型是一个参数量仅1.6M的膨胀卷积网络,在冻结编码器、仅线性探测的设置下,于UCR-128和UEA-27基准上分别达到83.3%和75.3%的准确率,与当前最优的MantisV2仅差0.3个百分点,且超过了在每个目标数据集上单独训练的原始TS2Vec。研究强调,不使用注意力机制、patch tokenizer或中间层特征提取,仅靠卷积编码器和两层MLP stem就能实现接近最优的性能,为时间序列基础模型的设计提供了紧凑高效的新思路。
时间序列分类领域正经历从「每个数据集单独训练」到「一个编码器复用所有数据集」的范式转变。然而,基础模型往往依赖注意力机制和复杂的tokenizer设计。一项新研究证明,经典的TS2Vec自监督方法经过三项关键改造,就能蜕变为紧凑高效的基础模型,并在多个基准上接近当前最优水平。
为什么需要把TS2Vec变成基础模型?
TS2Vec是2022年提出的时间序列自监督方法,在每个数据集上独立进行自监督预训练再加线性探测,性能强劲。但它有一个根本局限:每换一个数据集就要重新训练,无法复用。
另一边,领域风向已转向基础模型——在一个大规模语料上预训练一次,然后冻结编码器适配下游任务。那么问题来了:TS2Vec那些吸引人的特性——紧凑的卷积架构、直接处理原始时序样本、无需重采样即可接受变长输入——能否在「只预训练一次」的前提下保留?
据该研究的实验,答案是肯定的。作者通过三项改动,将TS2Vec实质性地转变为基础模型,命名为TS2Vec-FM。
时间序列基础模型(TSFM) 是近年来时间序列分析领域的新兴范式。传统方法通常为每个数据集单独训练模型,而TSFM借鉴了自然语言处理和计算机视觉中基础模型的思路:在大规模、多样化的语料上预训练一个通用编码器,然后通过冻结编码器加轻量级下游适配(如线性探测)的方式,将预训练模型迁移到各种下游任务。这种范式的优势在于显著降低下游任务的训练成本,同时提升泛化能力。时间序列基础模型面临的独特挑战包括:时间序列的长度可变、采样频率不一、缺乏统一的预训练语料,以及如何设计无需重采样的编码器架构。当前主流TSFM多基于Transformer架构,依赖注意力机制和patch tokenizer,但这也带来了较高的计算复杂度和参数量。TS2Vec-FM的研究正是在这一背景下,探索用更紧凑的卷积架构实现类似甚至更优的性能。
三项关键改造:从专用模型到通用基础模型
TS2Vec-FM的设计极为克制,仅需三处调整:
第一,在合成语料上预训练。 不再依赖目标数据集,而是使用合成生成的时间序列语料进行一次性自监督预训练,从而获得可迁移的通用表征。
第二,双视角输入设计。 编码器同时接收原始振幅视图和实例归一化后的形状视图,两者分别通过小型stem网络注入。这样模型既能捕捉绝对幅度信息,又能聚焦于形态模式,避免归一化带来的信息损失。
第三,蒸馏融合单编码器。 为每个视图训练一个专家编码器,再通过蒸馏将它们的能力合并到一个编码器中。推理时只需单编码器前向,保持部署简洁。
最终得到的TS2Vec-FM是一个参数量仅1.6M的膨胀卷积网络。
实例归一化(Instance Normalization) 是一种常见的特征归一化技术,在时间序列分析中常用于消除不同样本之间的幅度和偏移差异。具体而言,对于每个时间序列样本,实例归一化会减去该样本的均值并除以标准差,使得每个样本的分布被标准化到零均值和单位方差。这样做的好处是让模型能够专注于时间序列的形态模式(如趋势、周期、突变),而不受绝对幅度的影响。然而,实例归一化也会丢失幅度信息,而幅度在某些分类任务中可能是关键判别特征。TS2Vec-FM的双视角设计正是为了解决这一矛盾:原始振幅视图保留绝对幅度信息,实例归一化后的形状视图则聚焦于形态模式,两个视图通过不同的stem网络注入编码器,从而让模型同时获得两种信息。这种设计在时间序列基础模型中较为新颖,平衡了归一化的利弊。
知识蒸馏(Knowledge Distillation) 是一种模型压缩与知识迁移技术,最初由Hinton等人提出。其核心思想是让一个学生模型(Student)学习一个或多个教师模型(Teacher)的输出,从而将教师模型的知识迁移到学生模型中。在TS2Vec-FM中,作者为每个视图(原始振幅视图和实例归一化形状视图)分别训练一个专家编码器作为教师,然后通过蒸馏将这些专家编码器的能力融合到一个单一的学生编码器中。这样,在推理阶段只需运行一个编码器,既保持了部署的简洁性,又获得了多视图融合的优势。蒸馏通常通过最小化学生模型与教师模型输出之间的差异(如KL散度或均方误差)来实现。这种专家蒸馏策略在时间序列基础模型中尚不多见,它有效地将多视角学习与模型压缩结合在一起,为紧凑型基础模型的设计提供了新思路。
性能表现:冻结编码器接近SOTA
在冻结编码器、仅做线性探测的设置下,TS2Vec-FM在UCR-128上达到83.3%的准确率,在UEA-27上达到75.3%。与当前最优的MantisV2相比,差距仅0.3个百分点。更重要的是,它超过了在每个目标数据集上单独训练的TS2Vec。
这意味着一个预训练一次、参数量极小的卷积模型,在泛化能力上已经追平了精心设计的注意力基础模型。
线性探测(Linear Probing) 是评估预训练模型表征质量的一种标准协议。在预训练完成后,冻结编码器的所有参数,仅在其输出特征上训练一个简单的线性分类器(通常是一个线性层或逻辑回归),然后在下游任务上评估性能。线性探测的优势在于它能够直接衡量预训练编码器提取的特征的通用性和可迁移性,而不受复杂下游微调策略的影响。如果一个编码器在线性探测下就能取得接近甚至超越全监督训练的 performance,说明它学到的表征已经非常强大。在TS2Vec-FM的实验中,作者采用线性探测协议,在UCR-128和UEA-27基准上评估冻结编码器的性能,并与当前最优的注意力基础模型MantisV2进行对比,结果显示仅相差0.3个百分点,且超过了在每个数据集上单独训练的原始TS2Vec。这充分证明了TS2Vec-FM预训练表征的有效性。
设计哲学:没有注意力也能接近最优
作者在原文中特别强调,TS2Vec-FM与其他基础模型在设计上的差异才是最有趣的部分:它不使用注意力机制,不使用patch tokenizer,也不依赖中间层特征提取。仅靠「老派」的卷积编码器和两层MLP stem就实现了接近最优的性能。
这给时间序列基础模型的研究提供了一个重要提醒:架构的复杂度并非性能的必要条件。紧凑卷积网络在变长时序输入上的天然适配性,加上合理的预训练策略,足以支撑一个高效的基础模型。对于资源受限或需要低延迟推理的场景,TS2Vec-FM的设计思路尤其值得借鉴。
相关推荐

前端转AI Agent开发:一线架构师解析职业路径与红利
一线AI架构师解析前端转AI Agent开发的行业变化与落地路径:纯前端岗位为何消失、Agent+全栈为何成为招聘主流,以及Agent开发工程师、FDE、远程接单三条转型路线和对应学习策略。

AI Agent开发课程怎么选?五条避坑指南
机械转行开发者踩坑两年总结的AI Agent开发课程筛选清单:完整交付链路、可写进简历的项目、真实开发视角、更新频率、陪跑反馈五个维度,附具体判断方法和避坑要点。

扣子(Coze)智能体搭建入门:零代码开发AI Agent实战指南
扣子(Coze)是字节跳动推出的一站式AI应用开发平台,支持零代码拖拽搭建AI智能体。本文基于B站教程梳理扣子的核心概念、三大优势、国内版与国际版差异,以及智能体与应用的区别,帮助初学者快速入门AI Agent开发。