突破显存瓶颈:ZeRO-3+LoRA实现大规模自蒸馏

用LoRA共享骨干加双适配器,让自蒸馏EMA教师在大模型上省显存跑得动。
文章介绍了一个开源项目,用LoRA微调解决自蒸馏中EMA教师带来的显存困境。传统自蒸馏需同时驻留教师和学生两份完整模型,导致前向延迟增加、ZeRO-3通信开销加剧。该方案冻结并共享骨干网络,仅维护学生和教师两个轻量适配器,将显存占用从两份完整模型降为一份骨干加两份小适配器。工程上,项目修复了ZeRO-3下的适配器切换、EMA教师检查点保存恢复以及DeepSpeed内存尖峰等问题,已在Qwen3.5和ToolAlpaca上测试验证。文章认为这为资源有限团队提供了可复用的大模型自蒸馏工程范式。
自蒸馏的显存困境与LoRA解法
自蒸馏(Self-distillation)是一种让模型自我提升的训练范式,其核心是使用一个指数移动平均(EMA)教师来提供稳定、同步的监督信号。然而,当模型规模扩大时,这一方法面临严峻的工程挑战:教师和学生两个完整模型副本需要同时驻留在GPU上,不仅增加了前向传播的延迟,还加剧了ZeRO-3的通信开销。对于显存本就紧张的大模型训练场景,这几乎是不可承受之重。
Reddit社区近期分享的一个开源项目给出了巧妙的解法:利用LoRA(低秩适应)微调,将骨干网络共享并冻结,仅维护两个轻量级适配器——一个用于学生(持续训练),另一个作为教师的EMA副本。这样一来,显存占用从“两份完整模型”降为“一份骨干+两份小适配器”,大幅降低了显存压力和通信负担。
EMA教师:指数移动平均(Exponential Moving Average)教师是自蒸馏中的常见设计。它不参与梯度更新,而是将学生模型的权重按 (\theta_t = \alpha \theta_t + (1-\alpha)\theta_s) 的方式缓慢滑动平均((\alpha) 通常接近 0.99 以上)。这样得到的教师权重变化平滑,能为学生提供比瞬时权重更稳定、噪声更小的软标签监督信号,避免学生追逐自身快速波动的输出而发散。代价是必须额外保存一份教师参数,这正是文章所述显存困境的根源之一。
ZeRO-3:ZeRO(Zero Redundancy Optimizer)是 DeepSpeed 提出的显存优化技术,分三个 Stage 逐级切分优化器状态、梯度和参数。ZeRO-3 更进一步,把模型参数本身也按层切分到各张 GPU 上,前向/反向时再通过 all-gather 临时拼接。它让超大模型能在有限显存下训练,但代价是引入了频繁的集合通信,因此文章强调教师前向会“加剧 ZeRO-3 的通信开销”。
LoRA(低秩适应):LoRA 冻结预训练权重,在特定线性层旁注入一对低秩矩阵 (A)、(B) 作为可训练适配器,将权重更新表示为 (\Delta W = BA)。由于秩 (r) 远小于原维度,新增参数量通常只有原模型的千分之几。适配器可以独立加载、卸载、合并或切换,这一特性正是本文“共享骨干+双适配器”方案成立的技术前提。
工程实现:在TRL与ZeRO-3下跑通SDFT
将上述思路落地并不简单。项目作者指出,要在TRL(Transformer Reinforcement Learning)框架和ZeRO-3分布式策略下干净地运行自蒸馏,需要一系列修复。最终打包成的即插即用仓库支持以下关键特性:
- 鲁棒的SDFT实现:能够在ZeRO-3环境下稳定运行自蒸馏训练。
- ZeRO-3 + LoRA集成:通过适配器切换机制,在教师前向和学生前向之间无缝切换,避免额外模型副本。
- EMA教师检查点保存与恢复:支持训练中断后恢复EMA教师状态,保证长周期训练的可靠性。
- 可用的DeepSpeed配置:针对GPU显存紧张场景修复了内存尖峰问题,使训练过程更加平稳。
这些修复看似琐碎,却直接决定了大模型自蒸馏能否在有限硬件上跑起来。据作者透露,该方案已在Qwen3.5和ToolAlpaca上完成测试,验证了其可行性。
适配器切换的关键细节
教师和学生共享同一骨干网络,意味着每次前向传播前需要动态切换LoRA适配器。这要求框架能够高效地加载和卸载适配器权重,同时保证EMA更新只作用于教师适配器。项目通过封装适配器切换逻辑,将这一过程对训练循环透明化,降低了使用者的集成成本。
TRL(Transformer Reinforcement Learning):TRL 是 Hugging Face 维护的开源库,封装了 SFT、DPO、PPO、GRPO 等后训练流程,并原生支持 PEFT 适配器与 DeepSpeed 集成。本文所指的“干净地运行”难点在于:TRL 的训练器默认假设只有一个活动模型,而自蒸馏需要在同一骨干上交替切换学生与教师适配器,且 EMA 更新必须绕过优化器和梯度累积逻辑,因此需要打补丁式的修复。
SDFT:此处 SDFT 指 Self-Distillation Fine-Tuning,即在微调阶段引入自蒸馏目标,让学生模型同时拟合任务数据和教师软标签。它不同于传统离线蒸馏(教师固定、学生单向学习),教师与学生同步演化,属于在线自蒸馏范畴。
适配器切换的实现机制:在 PEFT 中,不同适配器以命名空间(如 "default"、"teacher")挂载在同一层上,可通过 set_adapter() 激活其中之一。教师前向时激活教师适配器并置于 eval 模式、禁用梯度;学生前向时切回学生适配器。关键约束有两点:一是 EMA 更新必须在 torch.no_grad() 下直接对教师适配器参数做原地滑动平均,不能经过优化器;二是切换本身不能触发参数重分配或缓存失效,否则会在 ZeRO-3 下产生显存尖峰。封装这层逻辑后,训练循环只需声明“当前阶段”,无需关心底层切换细节。
实测验证与社区反馈
作者在Reddit帖子中明确提到,该仓库已在Qwen3.5和ToolAlpaca上进行了测试。虽然原文未披露具体的性能指标或显存节省比例,但从“修复内存尖峰”这一描述可以推断,原始方案在显存紧张时会出现明显波动,而调整后的DeepSpeed配置缓解了这一问题。
项目以开源形式发布在GitHub(ifiaposto/sdft_zero3),作者公开征集反馈、更多示例和issue。对于从事大模型蒸馏、强化学习微调的研究者和工程师而言,这是一个值得关注的轻量级工具——它没有重新发明轮子,而是把已有的LoRA和ZeRO-3能力组合起来,解决了自蒸馏规模化落地的最后一公里问题。
对大模型训练实践的启示
这项工作反映了一个更广泛的趋势:随着模型规模增长,训练方法的创新越来越依赖于工程层面的精细优化。自蒸馏本身并非新概念,但要让它在ZeRO-3和PEFT生态中稳定运行,需要对内存管理、通信调度和检查点机制进行系统性打磨。
对于资源有限的团队,LoRA共享骨干+双适配器的思路提供了一种可复用的范式:在不牺牲教师稳定性的前提下,将显存开销控制在可接受范围内。未来,如果社区能补充更多模型规模下的基准数据,这一方案的影响力有望进一步扩大。
相关推荐
64麦克风声学相机实测:800美元看见声音
实测Amazon售价800美元的TD2E声学成像相机:64个麦克风阵列实时定位声源,频响覆盖2000至100000赫兹,可探测超声波。本文分析其工作原理、实际定位精度、工业巡检适用场景及接口缺失等细节问题。
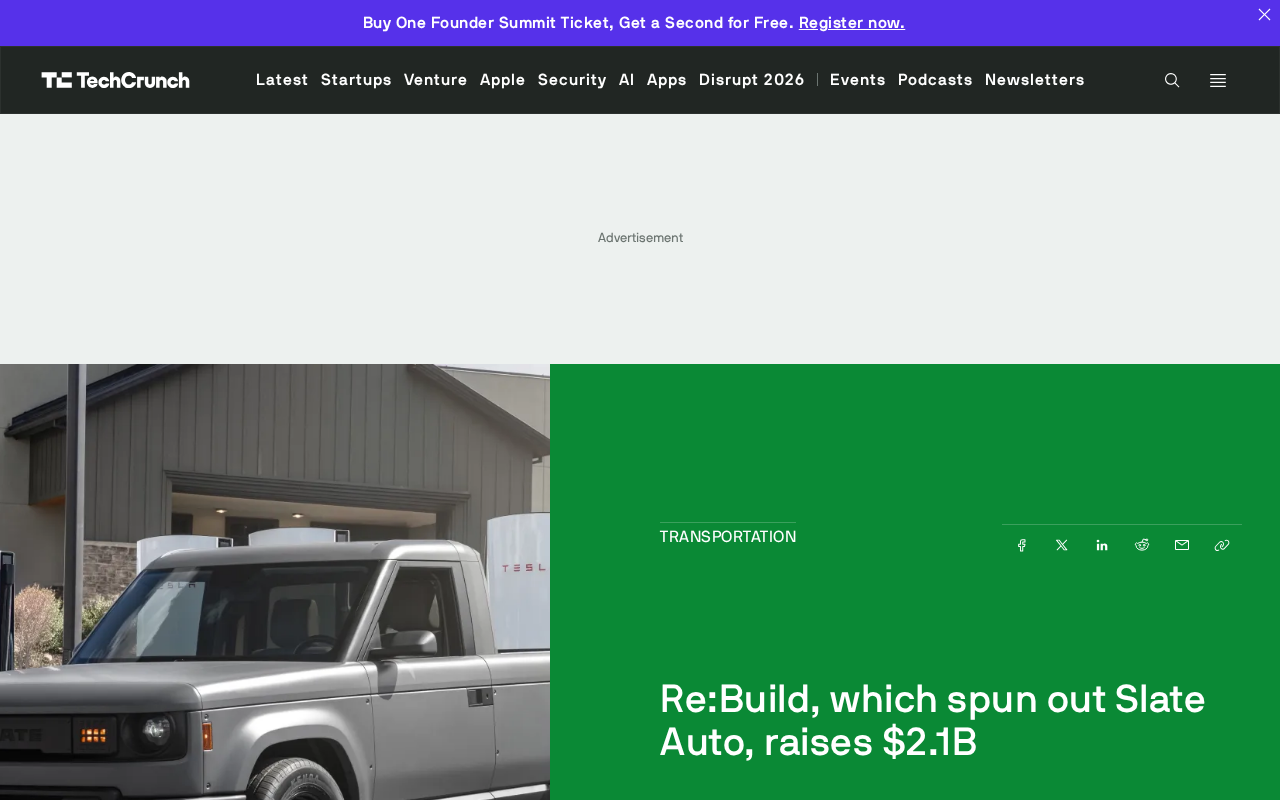
制造加速器Re:Build融资21亿美元,分拆Slate Auto
制造加速器Re:Build完成21亿美元融资,自称“美国对深圳的回应”,并分拆出Slate Auto。本文梳理已知事实、定位含义与信息缺口。
OpenAI公开突破却遭学界诟病:科研透明度成焦点
OpenAI公布数学、计算机科学和物理学突破并声称改进沟通方式,但研究人员向The Verge表示不满加剧,批评其选择性公开、缺乏可复现细节,企业研究与开放科学之间的张力再度凸显。