#大模型训练
共 18 篇相关文章

重新审视LLM扩展定律:如何选对Token/参数比
深入解析LLM扩展定律中的Token-per-Parameter Coverage概念,探讨如何在训练算力、推理成本与数据质量之间选对参数与数据的最优配比,为大模型训练决策提供实用参考。

DeepSpeed不止ZeRO:张量、序列与专家并行的易用化演进
DeepSpeed不再只是ZeRO。最新更新带来高度优化的张量并行、序列并行和专家并行能力,在训练MoE大模型上匹敌主流框架,同时保持ZeRO级别的易用性。

从零构建GLM-5.3-Flash:CPU上训练2500万参数模型实战
本教程讲解如何用普通CPU从零构建并训练一个2500万参数的GLM-5.3-Flash模型,涵盖字符级词表、稀疏注意力、混合专家、超连接等架构,以及预训练与RLOO强化学习全流程,并分享AI研究实验设计方法论。
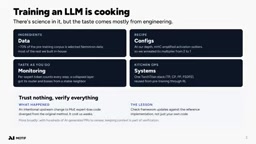
30人韩国小队的突围:Motif如何用千卡GPU闯进开源模型前五
韩国初创公司Motif用30人团队和不到千卡GPU,训练出跻身开源模型前五的大模型。本文解析其渐进式训练策略、「验证一切」的工程哲学、失败驱动的后训练方法,以及韩国KAI举国AI计划的生态背景。
UpGuard:逐位比对破解生产级LLM训练调试难题
字节跳动Seed团队推出调试工具UpGuard,通过逐位比对两次LLM训练运行,精确定位首个出现差异的操作,将生产级大模型训练调试从五天缩短到五分钟。本文解析位级对齐方法如何破解损失曲线滞后难题。

格式感知融合:让FP4预训练提速两倍的工程实践
新论文提出格式感知融合方法,在Llama-3 8B预训练中让FP4吞吐量从18.8K翻倍至37.9K tokens/s/GPU,MFU达86.3%,揭示FP4效果由缩放契约、操作数与执行路径共同决定。

从细节看Anthropic:训练阶段的严谨到底体现在哪
一条Reddit讨论帖引发对Anthropic训练细节的关注。本文从数据质量、对齐方法、产品哲学等角度,解析大模型训练阶段重视细节的行业意义及对开发者用户的启示。

1000+ TPU上跑通310B全参数RL:小米MiMo-V2.6的工程突破
Peano AI团队在1000+块TPU上为小米310B MiMo-V2.6模型运行全参数强化学习,vLLM驱动rollout并实现与训练器的比特级对齐,310B参数在ICI网络上2秒内完成同步。解析这一大模型RL工程突破的技术看点。
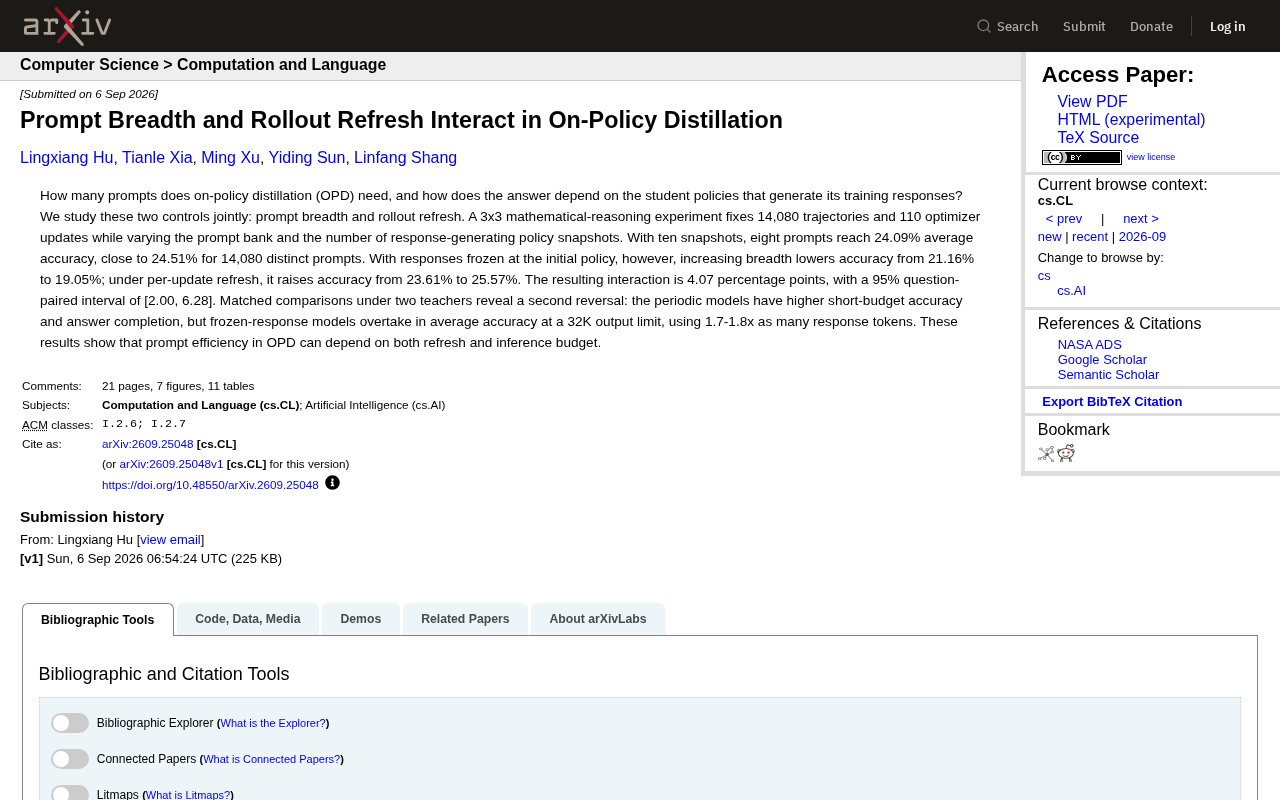
在线策略蒸馏中的提示广度与响应刷新交互效应研究
arXiv 新论文研究在线策略蒸馏(OPD)中提示广度与响应刷新的交互效应,通过 3×3 数学推理实验揭示提示效率同时取决于响应刷新策略与推理预算,交互效应达 4.07 个百分点。
深入解析大模型后训练:NVIDIA Nemotron专家揭秘Post-Training全流程
NVIDIA Nemotron后训练团队专家深度解析大模型Post-Training全流程:从预训练到后训练的演进、结构化数据、多教师在线蒸馏、数据偏差治理、工具调用优化及新手入门建议。
JAX中加速Dropless MoE训练:NVIDIA Transformer Engine解析
本文解析如何在 JAX 框架中借助 NVIDIA Transformer Engine 加速 Dropless MoE 训练,涵盖 MoE 架构原理、token 丢弃问题、FP8 低精度与分组 GEMM 优化等关键技术。

长程强化学习的隐性杀手:训练与评分引擎的数值漂移
长程强化学习(Long-horizon RL)中最难的 bug 往往是数值型的:当采样引擎与评分引擎对同一 token 分配的概率不一致时,训练会悄然漂移。本文解析问题成因与对齐 tokenization 的解决思路。
 产品体验
Cube Studio深度解析:腾讯开源一站式MLOps平台
深度解析腾讯音乐开源的Cube Studio一站式AI平台,涵盖架构设计、分布式训练、大模型微调推理、国产化适配等核心能力,帮助企业高效落地MLOps全流程。
 产品体验
Cube Studio:腾讯开源云原生AI平台全面解析
深度解析腾讯音乐开源的Cube Studio云原生AI平台,涵盖分布式训练、大模型微调推理、Pipeline编排、国产化适配等核心能力,助力企业快速构建一站式MLOps基础设施。
 产品体验
Cube Studio深度解析:腾讯开源一站式MLOps平台实战指南
深度解析腾讯开源AI平台Cube Studio的架构设计与核心能力,涵盖大模型训练微调、vLLM推理部署、分布式训练框架生态、昇腾国产化适配及VGPU算力管理,帮助企业快速构建私有化MLOps全流程。
 产品体验
Unsloth:本地训练开源大模型的高效工具,6万星标的秘密
深入解析Unsloth这款GitHub 6万+星标的开源大模型训练工具,支持Gemma 4、Qwen3、DeepSeek等主流模型的本地微调与推理,通过LoRA/QLoRA技术大幅降低显存需求,助力开发者在消费级显卡上高效训练大模型。
 产品体验
Cube Studio:腾讯开源一站式云原生AI平台深度解析
深度解析腾讯音乐开源的Cube Studio云原生AI平台,涵盖MLOps全流程、大模型训练推理、分布式训练框架支持、VGPU虚拟化及国产化适配等核心能力,帮助企业高效构建AI基础设施。
 产品体验
Cube Studio:腾讯开源一站式AI平台,大模型训练到推理全覆盖
深度解析腾讯音乐开源的Cube Studio云原生AI平台,涵盖分布式训练、DeepSeek大模型微调、vLLM推理部署、VGPU算力管理等核心功能,支持华为昇腾国产化生态,助力企业构建私有AI基础设施。