图神经网络入门:从学生成绩预测理解GNN核心原理
以学生成绩预测为例,讲清GNN如何利用邻居与多跳信息超越普通神经网络。
文章用“根据期中成绩预测期末成绩”这一贯穿案例,拆解图神经网络的核心机制。基础神经网络只看单个学生,忽略了学习小组带来的信息,误差很高;单层 GNN 引入邻居平均成绩后误差接近零。随机边基线实验进一步表明,性能提升主要来自真实的学习伙伴关系,而非仅仅多引入了他人信息。两层 GNN 让信息跨越两跳传播,层数需通过验证集调优,通常存在误差平台期。文章还说明了 GNN 在训练与验证上的特殊性——必须严格区分可用信息以避免标签泄漏,并介绍了节点嵌入与学习小组推荐等应用,最后展望了带权边与注意力机制的扩展方向。
图神经网络(GNN)正处在图论与神经网络的交叉点上,是当下数据科学中极具实用价值的方向。本文用一个贯穿始终的例子——根据期中成绩预测学生期末成绩——把 GNN 的核心机制拆解清楚,并解释它为何比普通神经网络更强。
从一个失败的预测说起
假设你是一位数学教授,想用学生的期中成绩预测期末成绩。最直接的做法是套一个基础神经网络:把期中成绩 M 通过权重和激活函数映射到隐藏状态 H,再从隐藏状态映射到预测值。整个模型的参数在训练中学习,数学上就是“激活函数作用于输入的线性组合”。
然而训练之后你会发现误差高得离谱。原因藏在课堂本身:学生并不是孤立存在的,他们组成学习小组,组内共享知识与信息,组间则基本不交流。只看单个学生的成绩,等于丢掉了这部分关键信息。
这正是 GNN 要解决的问题——不只用“你是谁”,还用“你和谁一起学习”来做预测。
单层GNN:把邻居信息纳入进来
从数学上看,单隐藏层 GNN 与基础网络差别并不大。我们仍然使用学生自己的期中成绩,只是额外引入其学习伙伴(邻居)的平均期中成绩 M_N。两部分信息通过一个熟悉的公式转换为隐藏状态,唯一的改动是多了邻居平均成绩的线性组合项,也就是在训练中多了一个参数。
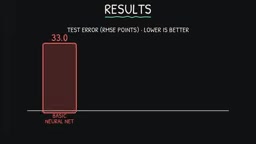
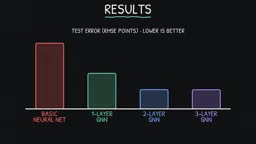
结果差距相当明显:基础神经网络误差很高,而单层 GNN 的误差被压低到接近零。
一个必须做的对照实验:随机边基线
在公布结果之前,有一个关键对照值得关注:如果同样训练 GNN,但把学生 study graph 中的所有边随机打乱,会发生什么?这个基线的作用是排除一种可能的解释——模型变好只是因为引入了其他学生的期中成绩,而非真正利用了学生之间的实际连接关系。
实验结果是:随机边基线的表现确实优于基础神经网络,说明“引入他人信息”本身有价值;但它的表现明显不如保留真实连接关系的 GNN。学生真实的学习伙伴关系,才是性能提升的主要来源。
随机边基线(random-edge baseline) 是图机器学习中常用的消融实验:保持节点特征与模型超参数不变,仅将图的边随机重连(通常保持度分布或边数不变),再按相同流程训练评估。它的作用是把“图结构本身的信息”与“引入额外特征或更多参数带来的增益”分离开。若随机边模型与真实图模型表现相当,说明性能提升并非来自真实的连接关系;若真实图明显更优,则说明边确实携带了任务相关的信号。这一基线在节点分类、链接预测等任务中也被广泛采用,是判断 GNN 是否真正“用上了图”的最低门槛。
两层GNN:信息沿图传播
到这里一个合理的质疑是:上述做法除了构造了一个新特征,其余部分不过是普通神经网络,凭什么单独称为一个领域?要回答这个问题,需要从单隐藏层扩展到双隐藏层。
单层 GNN 让信息从你的一跳邻居(直接学习伙伴)流向你。两层 GNN 则进一步纳入“你学习伙伴的学习伙伴”——也就是图中距离你两跳的节点。其假设很直观:日常一起学习的伙伴对你影响最大,而这些伙伴本身也在从他们的伙伴那里学习,这些信息可以间接帮助你。
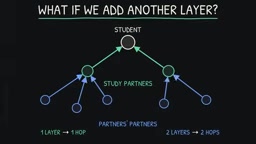
数学上的操作是:对每个邻居的第一层隐藏向量取平均,分别经过各自学习的线性组合,得到来自自身和邻居的贡献,相加后经激活函数得到第二层隐藏向量。关键在于,邻居第一层向量的均值本身又是其邻居的函数——多加一层,信息就能跨越两跳到达你这里。出于简化,图中省略了偏置等常数项,它们同样在训练中学习。
层数怎么选
层数(即考虑几跳邻居)本身就是一个需要调的超参数,用训练集和验证集来确定。实践中通常会出现误差平台期:一层优于基础网络,两层进一步改善,再加第三层却没有明显收益,这时两层就是合理选择。
GNN的训练与验证有何不同
普通神经网络只需在部分数据点上训练、留出另一部分验证即可。但 GNN 的数据通过边高度互联,必须非常明确地界定哪些信息可用、哪些不可用。
以连续三届学生为例:第一年拥有全部信息——学习关系、期中成绩、期末成绩,用于训练模型;第二年的学生只提供学习关系和期中成绩,期末成绩被隐藏,用来检验模型能否预测准确并计算验证误差。验证满意后,模型才可以投入实际使用。
标签泄漏(label leakage) 指训练或验证过程中,目标变量通过特征、边或数据划分方式间接进入了模型可见的信息。在图数据上它格外隐蔽:由于节点通过边互连,若验证节点的邻居中包含训练节点,而训练节点的标签又被用于构造特征或消息传递,验证指标就会被高估。常见防护手段包括按时间或按连通分量划分训练/验证集、在训练时屏蔽验证节点的标签、以及使用转导式(transductive)与归纳式(inductive)设置分别评估。文中“隐藏第二年期末成绩”的做法,本质上就是在切断标签沿边传播的路径。
训练好之后能做什么
最直接的用途当然是预测期末成绩。但还有两个容易被忽视的应用。
其一是嵌入(embedding):训练完成后,每位学生都获得一个学到的向量表示,可以作为其他相关任务的起点。
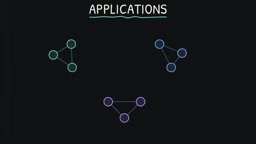
其二是帮助没有学习小组的学生选择伙伴。把一个孤立学生的期中成绩和假设建立的连接输入训练好的 GNN,就能当场生成“如果加入绿组、蓝组或紫组,期末成绩会是多少”的预测。若目标只是最大化成绩,选择使预测值最高的那组连接即可。
节点嵌入(node embedding) 是把每个节点映射为低维稠密向量的表示学习结果,向量中编码了节点的特征与局部图结构信息。训练好的 GNN 隐层输出天然可作为嵌入使用:结构相近或邻居相似的节点,其向量在空间中往往也更接近。嵌入的用途不限于原任务,可作为下游任务的输入特征,也可用于聚类、相似度检索与可视化。与 DeepWalk、node2vec 等只利用结构的嵌入方法不同,GNN 产出的嵌入同时融合了节点自身特征,因此在特征丰富的场景中通常更具表达力。
还可以走多远
上述模型做了一个简化假设:所有边权重相同。现实中你和某些人一起学习的时间远多于其他人,这类信息完全可以编码进边中,从而提升预测效果,也能为边本身学到表示,而不只是节点表示。另一个自然的扩展是引入注意力层,让模型自己学习哪些学习伙伴更重要——目前只是对所有伙伴取平均,但不同学术性格的人带来的价值显然不同。
无论是数学课上的学生、城市间的航班,还是读书会里的朋友关系,现实世界中的大量对象都适合建模为节点与边的集合。把图结构信息纳入模型,往往能打开原本封闭的问题空间。
相关推荐
Dioxus 全栈生产环境一年实践:收获与痛点
一位开发者分享 Dioxus 全栈框架在生产环境运行一年的真实体验,涵盖全栈 Rust 的类型安全收益、编译时间与生态成熟度等痛点,为技术选型提供参考。
AGI领袖的隐秘信仰:人类没有特殊之处?
Vergecast播客揭示AGI领袖圈内的隐秘信念:人类没有特殊之处,意识只是计算。探讨计算功能主义如何影响技术精英的世界观与AI未来。
通用汽车转向混动:从纯电押注到务实并行的战略调整
通用汽车此前跳过混动直接押注纯电,如今计划为SUV产品线推出混合动力版本,本文解析这一战略调整的原因、对SUV品类的意义以及对消费者的实际影响。