推测扩散双权衡框架:解锁大模型推理帕累托最优
论文提出联合优化扩散努力K与接受宽容度λ的框架,显著扩展推测解码的速度-质量帕累托前沿。
该论文将扩散语言模型与推测解码结合,提出双重权衡优化框架。理论证明在总变差距离约束下线性接受策略最优,且多步扩散可直接用最后一步输出概率作为拒绝采样的Proposal。实验表明,帕累托前沿由多个扩散努力K值共同构成,单独调宽容度λ无法获得完整前沿;联合调参能显著扩展速度-质量前沿,且框架在不同接受策略、块大小和草稿模型上均具普适性。工程上建议联合搜索K与λ,按业务需求选择配置。
大语言模型推理加速领域迎来新突破:一篇名为《Speculative Diffusion is a Tale of Two Trade-offs》的论文,将扩散语言模型与推测解码结合,提出双重权衡优化框架。该研究不仅给出理论证明,还通过实验验证了联合调参能显著扩展速度-质量的帕累托前沿。本文深度拆解其核心思想与工程启示。
自回归瓶颈与推测解码的局限
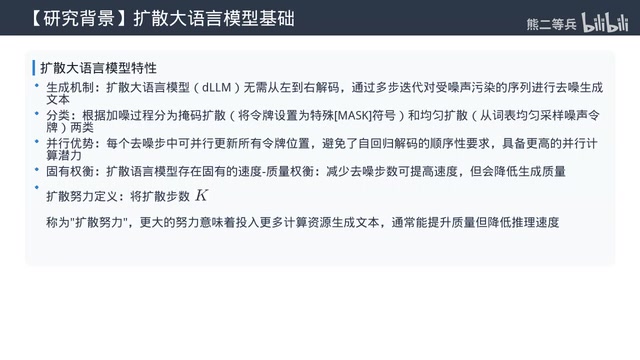
自回归模型逐Token生成,必须等待前一步完成,且每一步都要读取全部参数和不断增长的KV缓存。硬件显存带宽提升缓慢,导致算力大量闲置。推测解码通过小模型草稿+大模型并行验证来减少调用次数,且保持无损。接受率由草稿与验证模型分布的总变差距离决定,天花板受限于两模型匹配度。有损方法如宽容度参数或Cactus(控制KL散度上限)可主动放松分布一致性换取速度,但单独调节仍难突破帕累托前沿。
总变差距离(Total Variation Distance, TV) 是衡量两个概率分布差异的常用指标,定义为两个分布在各事件上概率差绝对值之和的一半,取值在0到1之间。在推测解码中,草稿模型分布Q与验证模型分布P的TV距离直接决定了理论接受率的上限:TV越小,两模型越接近,验证器接受草稿Token的概率越高。因此,接受率的天花板可近似表示为1 - TV(P, Q)。这一度量也为后续引入宽容度参数ε提供了几何解释——允许的分布偏移量正是以TV距离来约束的。
扩散语言模型:并行生成的天然优势
扩散语言模型(DLLM)通过多步去噪并行更新所有位置,规避了串行依赖。主要分两类:掩码扩散(替换为Mask符号)和均匀扩散(随机采样Token替换)。去噪步数(扩散努力K)越大,草稿质量越高但耗时越长。扩散模型一步即可并行生成整块Token,天然适合作为推测解码的草稿模型。此前研究多限于单步扩散,该论文则系统探索了多步扩散草稿的理论与优化空间。
掩码扩散与均匀扩散的区别:掩码扩散在每一步将部分Token替换为特殊的[MASK]符号,再通过模型预测被掩码位置的原Token,类似于BERT的掩码语言建模,但以多步迭代去噪。均匀扩散则不对位置做特殊标记,而是在每一步随机采样一个Token替换当前位置,通过多步迭代逐渐逼近目标分布。两者都支持并行更新所有位置,但掩码扩散的每步更新更结构化,通常去噪效率更高;均匀扩散的理论分析更简洁,但实际生成质量可能略低。论文中讨论的多步扩散草稿主要基于掩码扩散框架,因其更贴近实际可用的扩散语言模型。
核心理论:线性接受最优性与多步扩散Proposal
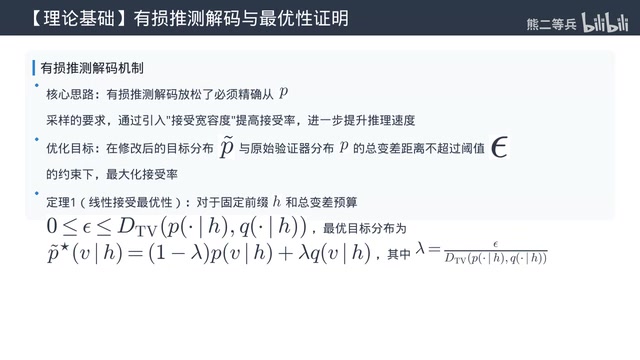
定理1(线性接受最优性):当允许修改后的验证分布与原分布的总变差距离不超过ε时,最大化接受率的最优修改是线性插值:P' = (1-λ)P + λQ,其中λ = ε / TV(P,Q)。该策略在采样前确定分布,与Cactus的采样后修改不同。总变差距离是度量空间中的距离,线性插值是两分布间的最短路径,因此结论严格成立。
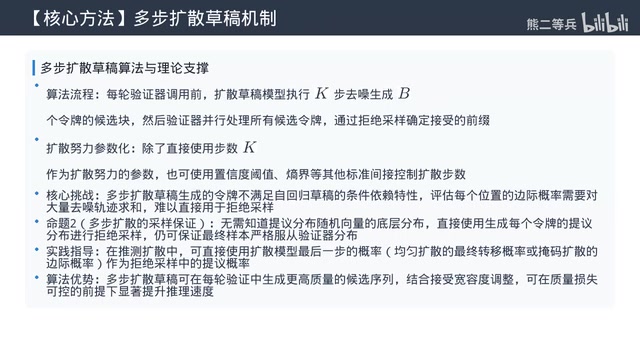
命题2(多步扩散Proposal):多步扩散生成过程随机,直接计算编辑概率需对所有去噪轨迹求和,不可行。命题2证明:直接用扩散最后一步输出的概率作为拒绝采样的Proposal概率,仍能保证采样结果符合验证器分布。这为多步扩散草稿奠定了理论基础。
联合优化空间与吞吐量模型
扩散努力K控制草稿速度与质量,接受宽容度λ控制验证阶段的速度与质量损失。两者共同决定整体性能,需联合调参才能逼近帕累托前沿。论文的激励例子表明:单独调自回归草稿的宽容度,速度上限远低于扩散模型调小K;单独用扩散模型调大K,质量天花板仍受限于验证器。扩散负责拉高速度上限,推测解码拉高质量上限,二者互补。
吞吐量理论模型将平均接受率表示为1-(1-λ)·D(K),其中D(K)是K步扩散时草稿与验证模型的平均总变差距离;质量代理为1-λ-K;草稿耗时≈a+bK(与K近似线性),验证耗时固定。模型预测与实测趋势一致,虽假设各位置接受率相同,但已能捕捉核心影响。
拒绝采样(Rejection Sampling) 是推测解码中保证无损性的关键机制。具体而言,验证器对草稿模型生成的每个Token,以概率min(1, P(x)/Q(x))接受,否则从修正分布max(0, P(x)-Q(x))归一化后重新采样。这一过程确保最终输出严格服从验证器分布P。当引入宽容度λ时,修正分布变为P' = (1-λ)P + λQ,接受概率相应调整,从而在允许一定分布偏差的前提下提升接受率。论文中的线性接受最优性定理正是针对这一修正形式给出了最优λ的解析解。
实验设计与核心发现
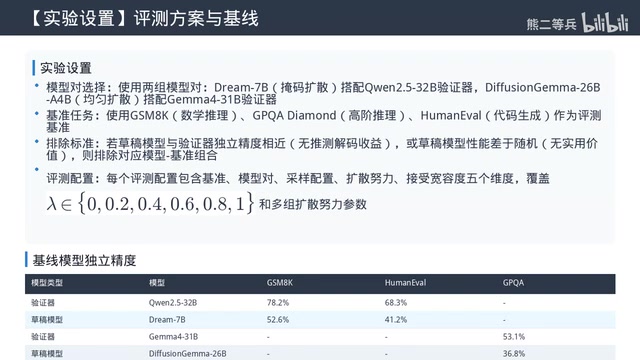
实验采用两组模型队:Dream 7B(草稿)+ Qwen 2.5-32B(验证器)、Diffusion Gemma 26B(草稿)+ Gemma 4-31B(验证器),并加入Qwen 3-8B统一验证器对比Uno、D-Flash、D-Spark等专用扩散草稿模型。数据集覆盖GSM8K(数学)、GPQA Diamond(推理)、HumanEval(代码)。排除标准:若草稿与验证器standalone准确率相近或草稿差于随机,则不测试。
核心结论:帕累托前沿由多个不同K值共同构成,固定单一K值仅调宽容度无法获得完整前沿。低K配严格接受策略对应高准确率区域,高K配高宽容度对应高速度区域。该趋势在线性接受和Cactus接受下均成立,且不同块大小也一致。对于支持多步扩散的草稿模型,联合调参显著扩展帕累托前沿;甚至未专门训练的SDR模型通过联合调参也能获得有竞争力的结果,体现框架的普适性。
帕累托前沿(Pareto Frontier) 在多目标优化中指代一组非支配解:在不牺牲其他目标的前提下,无法进一步改进任一目标。在推理加速场景中,两个目标通常是生成速度(吞吐量)和输出质量(准确率)。固定单一扩散努力K时,仅调节宽容度λ只能沿一条曲线移动,无法覆盖前沿的全部区域;而联合调整K与λ可以生成多条曲线,它们的上包络构成更完整的帕累托前沿。论文实验通过绘制不同K值下的速度-质量曲线,直观展示了联合调参如何将前沿向外扩展,从而为工程部署提供更丰富的配置选择。
工程启示与未来方向
实际部署中,若用扩散模型做推测解码草稿,不应固定单步扩散或仅调宽容度,而应联合搜索K与λ,根据业务延迟和质量要求选择帕累托前沿上的配置。例如实时聊天可选高K高λ,高质量代码生成可选低K低λ。未来研究方向包括动态调整K与λ(根据生成内容难度自适应),以及训练专门适配推测扩散的草稿模型以提升分布对齐度。
该论文将两个独立优化维度统一到一个框架,既提供理论支撑又有实验验证,为推理加速提供了清晰的新思路。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。