推理服务商数据事件频发,AI基础设施信任危机浮现
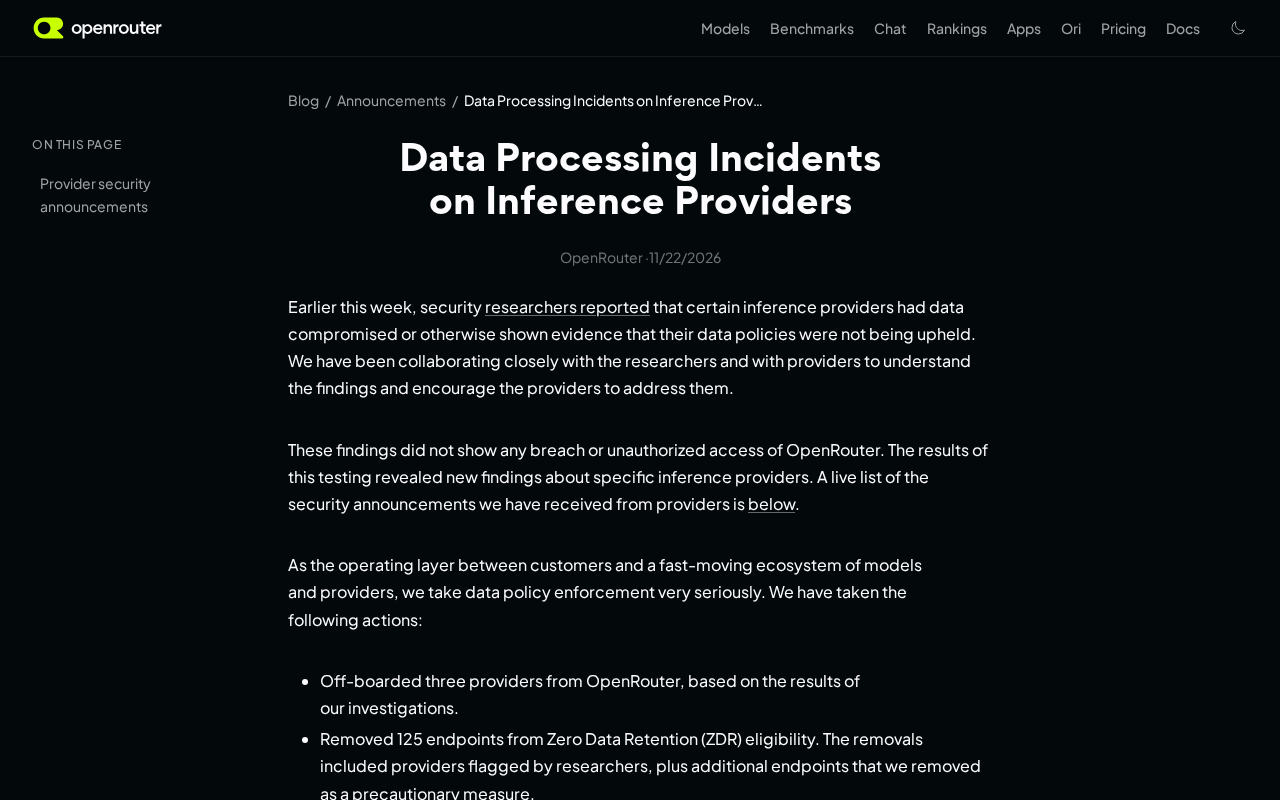
推理服务商数据处理事故暴露AI基础设施在数据治理透明度上的缺口。
文章从Hacker News上一则关于推理服务商数据处理事件的讨论帖出发,指出尽管原帖信息稀薄、讨论冷淡,但其指向的问题值得重视:推理是提示词、上下文与生成结果真正被处理的环节,一旦缺乏可审计边界,上游数据策略便会被削弱。文章分析了推理层事件易被忽视的原因,包括服务形态碎片化、责任归属模糊、托管默认设置不可见等,并说明此类事件会同时冲击合规与工程层面。最后提出三条可行路径:优先选择策略透明、支持审计的服务商,架构上保留可替换性,以及对提示词与上下文做前置脱敏。
推理服务商数据事件频发,AI基础设施信任危机浮现
Hacker News 上一条题为“Data Processing Incidents on Inference Providers”的帖子引发了小范围讨论。帖子本身信息量有限,讨论热度也不算高,但它触及了一个被高速迭代掩盖的问题:当模型推理越来越依赖第三方托管服务,数据在推理环节的处理是否可控?
事件本身:信息稀薄,但指向明确
原帖没有披露具体的事件细节、涉及厂商或影响范围,讨论区也仅有 7 条评论。这种“低信息密度”本身或许说明了两件事:一是围绕推理服务商数据处理事故的公开披露机制仍不成熟;二是开发者的注意力仍集中在模型能力与成本上,对推理层的数据治理关注不足。
但这并不意味着问题不重要。恰恰相反,推理是用户数据真正“落地”的环节——提示词、上下文、检索内容、生成结果都在这里被处理。一旦这一层缺乏可审计的边界,上游再严密的数据策略也会被削弱。
为什么推理层的数据事件容易被忽视
传统云服务的数据处理边界相对清晰:存储、计算、网络各司其职,合规审计也有成熟模板。而推理服务的形态更碎片化,很多平台同时承担路由、缓存、日志、安全过滤等职责,数据处理链路被拉长,责任归属也变得模糊。
参与者往往默认“托管即安全”,但托管服务商可能在日志留存、请求重放、多租户隔离等环节存在差异化的默认设置。这些设置平时不可见,出问题时才暴露,这也是此类事件难以被提前发现的原因。
多租户隔离指云服务商在同一套物理或虚拟基础设施上同时承载多个客户的工作负载时,通过命名空间、虚拟化、内存隔离、网络策略等手段确保一方数据不被另一方访问的机制。推理服务通常以高密度批处理方式运行,GPU共享、KV Cache复用、请求队列混排都会扩大租户间的接触面。若隔离策略在性能优化中被弱化,例如缓存未按租户分区、日志聚合未做归属过滤,就可能出现跨租户的数据残留或泄露。这类问题往往不体现在SLA指标上,只能通过独立审计或渗透测试发现。
请求重放(request replay) 在推理服务语境下有两层含义。其一是运维层面的合法重放:平台为排障或质量评估保存请求样本并重新执行,这会带来提示词与上下文被二次留存的风险。其二是安全层面的重放攻击:攻击者截获并重复发送有效请求以绕过鉴权或触发非预期计算。对使用方而言,关键问题是服务商是否默认开启请求样本留存、留存多久、谁能访问。这些设置通常不出现在对外文档中,却是数据治理审计的核心检查项。
对开发者的实际影响
对企业开发者而言,推理服务商的数据处理事件会直接传导到合规与工程两个层面。合规上,数据出境、敏感信息留存、审计留痕都可能因服务商策略变化而出现缺口;工程上,事故往往意味着需要重新评估请求链路、补充脱敏逻辑,甚至迁移服务。
更现实的问题是,多数团队缺乏对推理服务商数据处理行为的独立验证手段。可观测性工具通常只覆盖延迟与错误率,很少触及“数据被如何处理”这一维度。
可观测性(observability) 在AI基础设施中通常指对延迟、吞吐、错误率、token消耗等运行指标的采集与分析,其数据模型围绕“系统是否健康”设计,而非“数据流向何处”。因此传统APM与日志工具难以回答推理服务商是否记录了完整提示词、是否将上下文写入第三方存储、是否在安全过滤环节做了二次转发。要覆盖数据治理维度,需要补充数据血缘追踪、出口流量审计与配置基线比对等手段,这也解释了为何多数团队在该维度上处于盲区。
选型与治理上的可行路径
在信息不充分的情况下,团队可以把握几条相对可靠的原则。一是优先选择对数据处理策略有公开文档、且愿意提供审计接口的服务商;二是在架构上保留可替换性,避免把敏感数据处理完全绑定在单一推理平台上;三是对提示词与上下文做前置脱敏,降低单点事故的影响面。
这些做法不能消除风险,但能把不可见的风险转化为可管理的工程约束。推理服务的数据治理,短期内更可能依靠使用方的自我保护,而非行业统一标准。
前置脱敏指在请求进入推理服务之前,于客户端或网关层对提示词、上下文与检索内容中的敏感字段进行识别与替换,例如将身份证号、手机号、内部项目代号替换为占位符,待模型输出后再按需还原。其价值在于把数据保护责任前移到使用方可控的边界内,即使服务商侧出现日志留存或隔离失效,泄露的也只是脱敏后的内容。实施难点在于识别准确率与语义保真之间的平衡——过度脱敏会损害模型效果,脱敏不足则形同虚设,通常需要结合规则引擎与轻量分类模型分层处理。
结语
这条帖子本身不足以构成一次行业级事件的完整叙事,但它像是一个提醒:AI 基础设施的信任,不只建立在模型分数上,也建立在数据处理链路的透明度上。当推理服务成为默认选项,这部分透明度值得被更认真地对待。
相关推荐
前罪犯揭秘监狱心理变态比例:每880人约200个
前罪犯Larry Lawton在Lex Fridman播客中分享监狱观察:880名终身监禁犯中约200人是心理变态,比例高达23%。他探讨了善恶界限、监狱中的社交与情感,以及黑暗经历带来的智慧。

本地AI入门:Inkling、Qwen与Unsloth实战指南
面向初学者的本地AI实践指南,解析Inkling、Qwen与Unsloth在本地大模型部署与微调中的角色,涵盖模型选型、量化推理、轻量微调流程,以及本地与云端方案的取舍建议。

开放社交网络联盟成立:去中心化社交的新起点
Open Social Web Alliance 开放社交网络联盟亮相,引发 Hacker News 热议。本文梳理联盟的定位、社区讨论中的核心分歧,以及开放社交网络在互操作、内容治理和身份迁移上面临的现实挑战。