#模型推理
共 10 篇相关文章
Sarvam Token Factory上线:印度托管推理接入8款开放模型
Sarvam Token Factory正式开放,在印度本土GPU集群上托管Sarvam 105B、GLM 5.3、DeepSeek V4.1 Flash、Kimi K3.1 Pro、Gemma 4 31B等8款开放模型,通过OpenAI兼容API统一调用,主打数据主权与低延迟。
微调能让推理确定吗?批处理Token翻转的边界正则化实验
零温度贪婪解码并非完全确定:批处理会导致token翻转。研究测量了扰动与数值精度的关系,并提出边界正则化微调方法,在GSM8K上减少35%翻转,但代价是1.3-2.9个准确率点。
MLX 新版本为 Flint 模型提供原生支持,推理引擎能力升级
MLX 新版本为 Flint 模型提供原生支持,推理引擎能力升级
MLX v0.40.8-rc0 新增 Flint 模型支持,涉及提示词 JSON 保真、safetensors 导入期组装 ModelOpt 专家库、可选学习型 sink 与设备端因果掩码三项改动,现有 API 行为保持不变。

全球金融科技如何用专属模型推理扩展编码智能体
一家全球金融科技企业通过 Together 的专属模型推理(DMI)扩展编码智能体流量,让工程团队直接掌控推理扩展、模型选型与测试验证。本文解析其转型动因与企业 AI 落地启示。

Qwen Flash Next 恢复 MTP 支持:llama.cpp 本地部署再进一步
Qwen Flash Next 的 MTP(多 token 预测)支持在 llama.cpp 中重新启动,提供 GGUF 量化模型与对应 PR。本文解读 MTP 技术价值、使用方法及注意事项。

vLLM v0.31.0rc3发布:Model Runner V2引入随机化虚拟输入
vLLM 发布 v0.31.0rc3 候选版本,核心更新为 Model Runner V2 支持随机化虚拟输入,提升显存剖析与推理预热精度。本文解析该特性原理及对部署者的实际影响。
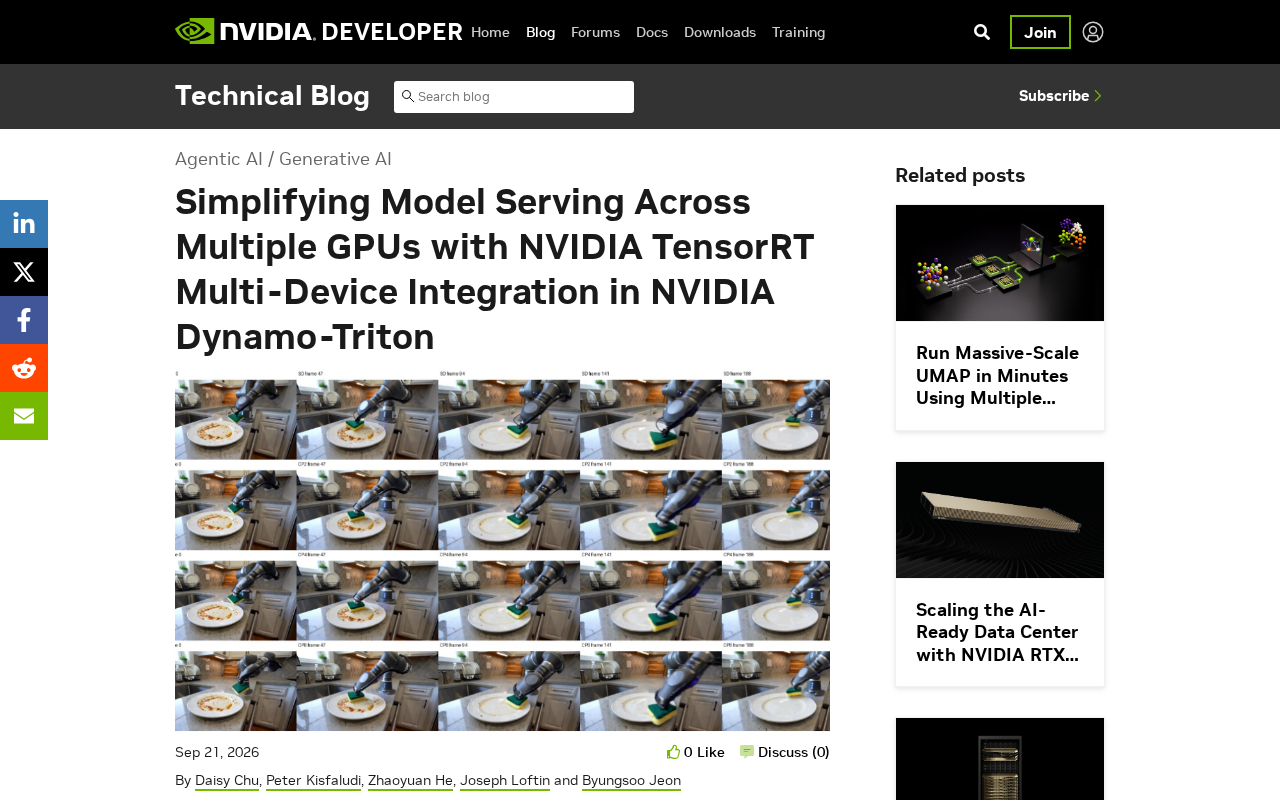
TensorRT多设备推理:简化Dynamo-Triton的多GPU模型部署
NVIDIA在Dynamo-Triton中引入TensorRT多设备推理能力,简化跨多GPU的大模型部署,解决单卡显存与算力不足问题,为生成式AI生产环境提供更高效的推理服务方案。
 教程攻略
Ollama教程:本地运行大模型的完整指南(2025最新)
详解Ollama本地部署大语言模型的完整教程,支持DeepSeek、Qwen、Kimi-K2.5等主流模型。17万Star开源项目,一键安装即可在本地运行LLM,保护数据隐私,零API成本。
 教程攻略
Ollama教程:本地运行DeepSeek等大模型的最简方案
详解Ollama本地部署大模型的完整指南,支持DeepSeek、Qwen、Kimi-K2.5等主流模型。了解这款17万Star开源工具如何实现一键安装、离线推理,以及适用场景与生态集成方案。
 教程攻略
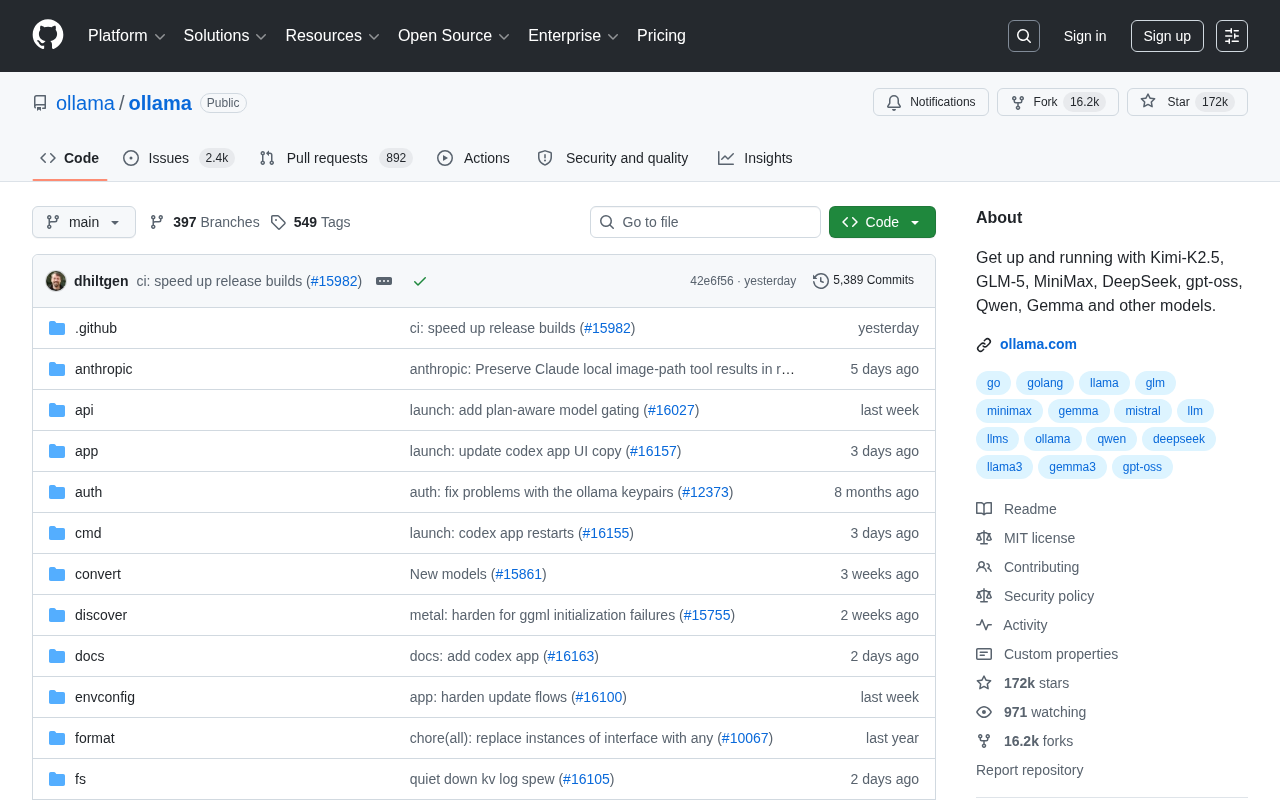
Ollama教程:17万Star的本地大模型运行框架深度解析
深度解析Ollama开源项目,一行命令本地运行DeepSeek、Qwen、Kimi-K2.5等主流大模型。详解安装使用、模型生态、技术架构及适用场景,助你快速上手本地LLM部署。