推理工程实战指南:开放资源与核心洞察

梳理推理工程的核心知识框架与开放指南的实践价值。
文章以 Hacker News 上一篇「An Open Field Guide to Inference Engineering」为线索,指出推理工程正成为 AI 应用落地的关键瓶颈,其复杂度不亚于训练。文章将推理工程拆解为延迟与吞吐的权衡、内存管理与量化、硬件选型与服务框架三个核心维度,强调动态批处理、KV Cache 管理、量化精度评估以及 vLLM、TensorRT-LLM 等框架的横向对比。在实践层面,建议团队先建立评估基线、对照指南排查瓶颈、小步迭代验证并参与社区共建。文章同时指出开放指南存在时效性与覆盖面局限,宜将其视为地图而非固定路线图,需与社区实践结合持续更新。
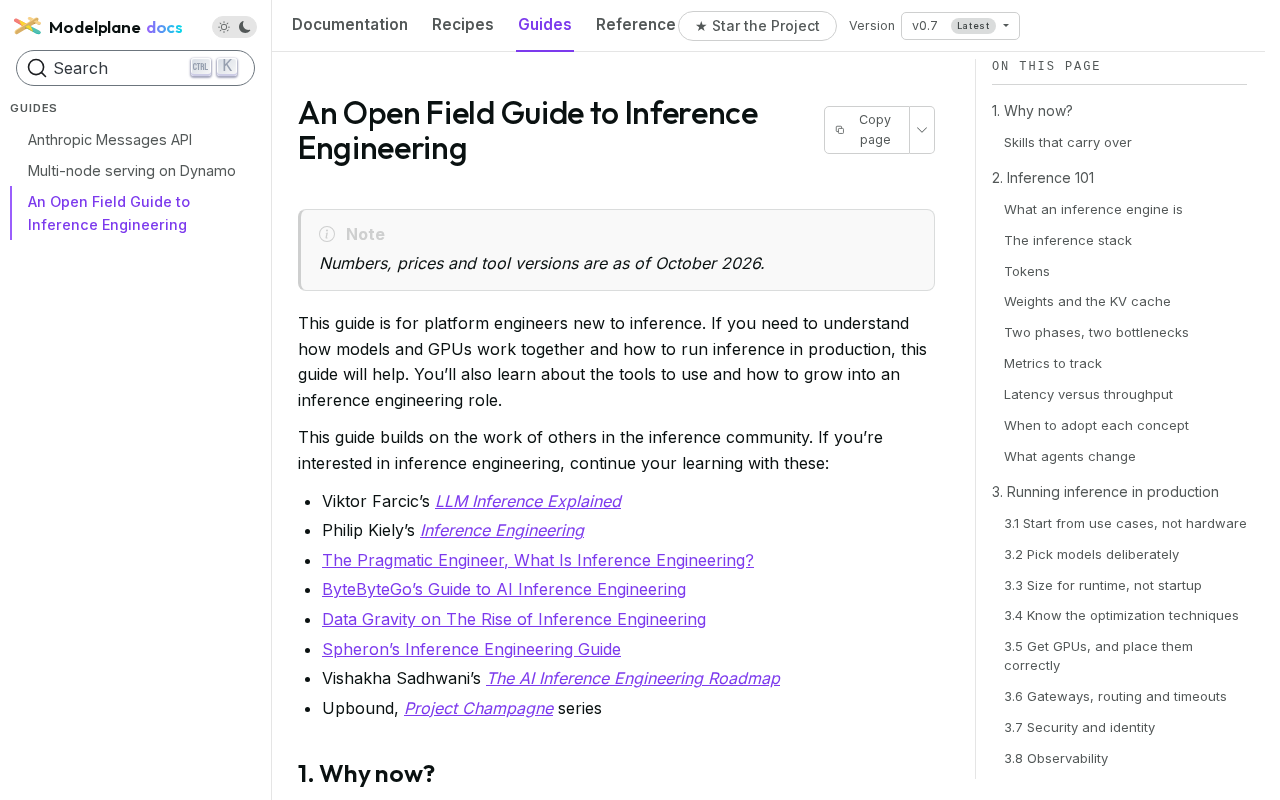
推理工程正成为AI应用落地的关键瓶颈。Hacker News 上近期出现了一篇题为「An Open Field Guide to Inference Engineering」的开放指南,引发了社区讨论。尽管帖子热度不高(3 分,1 条评论),但其主题直指工程团队在模型部署与优化中的真实痛点。本文基于该指南的线索和社区反馈,梳理推理工程的核心知识框架,并给出可操作的资源清单。
为什么推理工程值得单独关注
训练大模型固然引人注目,但将模型高效、稳定地运行在生产环境中,才是大多数团队日常面对的现实。推理工程涉及延迟优化、吞吐量提升、内存管理、硬件选型与成本控制等一系列问题,其复杂度不亚于训练。
一篇开放的领域指南之所以有价值,在于它试图把散落在博客、论文和工程实践中的经验系统化。Hacker News 的讨论虽然简短,却暗示了社区对这类结构化知识的渴求——尤其是当模型规模越来越大、部署场景越来越碎片化时。
据原帖标题和社区反馈,该指南强调「开放」属性,意味着它可能汇总了开源工具、公开基准测试和可复现的配置方案,而非某家公司的私有方案。这种定位对中小团队尤其友好。
推理工程的核心维度
根据该指南的框架和社区讨论,推理工程可拆解为以下几个关键层面:
1. 延迟与吞吐的权衡
推理系统的两大核心指标——单次请求延迟(Latency)和系统整体吞吐量(Throughput)——往往相互制约。批处理(Batching)能提升吞吐,但可能增加尾延迟;而过低的延迟目标又可能限制硬件利用率。指南中很可能讨论了动态批处理、连续批处理(Continuous Batching)等策略,以及如何根据业务场景设定合理的 SLA。
社区中常见的经验是:面向交互式应用(如聊天机器人)时,尾延迟优先;面向离线批处理(如内容审核)时,吞吐优先。这种场景化思维是推理工程与纯学术优化的区别所在。
连续批处理(Continuous Batching) 是相对传统静态批处理的一种调度策略。静态批处理需等待一批请求全部到达后一起送入模型,并等整批完成后才释放资源,导致短请求被长请求拖累。连续批处理则在每个解码步(decode step)动态移除已完成的序列、插入新到达的请求,使 GPU 始终处于高利用率状态。vLLM 的 PagedAttention 与 Orca 的迭代级调度是该策略的代表实现。工程上需关注其与调度器公平性、显存碎片以及请求超时机制的配合,否则可能在高并发下出现长尾放大。
2. 内存管理与量化
显存是推理部署中最稀缺的资源之一。KV Cache 的管理、模型权重的量化(从 FP16 到 INT8 甚至更低精度)、以及张量并行策略,都直接影响单卡能承载的并发数。开放指南通常会列出量化对精度的影响评估方法,以及不同硬件(NVIDIA GPU、AMD GPU、专用加速器)上的实测数据。
需要注意的是,量化并非万能药。极端量化可能导致输出质量显著下降,尤其是在长上下文或复杂推理任务中。指南中若包含精度-效率的权衡曲线,对工程决策会很有帮助。
KV Cache 是自回归推理中为避免重复计算历史 token 的键值对而缓存的中间张量,其大小随批次大小、序列长度、层数与注意力头维度线性增长,往往是显存占用的主要部分。PagedAttention 借鉴操作系统分页思想,将 KV Cache 切分为固定大小的块并按需分配,显著降低碎片与浪费;vLLM 即基于此实现高并发。工程上还需考虑前缀缓存(Prefix Caching)复用系统提示词的 KV、以及驱逐策略对长上下文场景的影响,这些直接决定单卡可承载的并发上限。
3. 硬件选型与服务框架
推理服务框架的选择(如 vLLM、TensorRT-LLM、TGI 等)与硬件选型紧密相关。开源框架在功能覆盖和性能上各有侧重,而云厂商的托管推理服务则提供了不同的抽象层级。开放指南的价值在于横向对比这些方案,并指出各自的适用边界。
从 Hacker News 的讨论氛围来看,社区更倾向于可自托管的开源方案,但也不排斥在特定场景下使用云服务。关键是要有透明的基准测试和可复现的配置。
vLLM、TensorRT-LLM 与 TGI 是当前主流的开源推理服务框架,定位各有差异:vLLM 以 PagedAttention 和易用性见长,生态活跃、支持模型广;TensorRT-LLM 依托 NVIDIA 的编译优化与内核融合,在特定 GPU 上可取得更低延迟,但需离线编译且与硬件绑定较强;TGI 由 Hugging Face 维护,集成度高、部署门槛低。选型时应结合模型结构、目标硬件、是否需要多卡张量并行以及团队维护能力综合判断,并用真实负载做基准测试而非只看厂商数据。
如何利用这份开放指南
对于想要深入推理工程的团队,建议采取以下步骤:
- 先建立评估基线:在目标硬件上,用代表性负载测试现有框架的延迟和吞吐,形成基线数据。
- 对照指南排查瓶颈:根据指南中的维度(批处理策略、量化、并行方式)逐一检查,定位主要瓶颈。
- 小步迭代验证:每次只调整一个变量,记录精度与性能变化,避免同时改动多个配置导致无法归因。
- 参与社区共建:开放指南的生命力在于持续更新,遇到文档缺失或过时的部分,可以向社区反馈或提交补充。
Hacker News 上的原帖虽然互动量不大,但这类开放协作的文档正是工程社区需要的公共品。它的价值会随着使用者的贡献而增长。
开放指南的局限与未来
任何开放指南都面临时效性和覆盖面的挑战。推理工程领域迭代迅速,新的硬件、框架和算法层出不穷,文档很容易过时。此外,不同团队的约束条件差异巨大(预算、团队规模、合规要求),一份通用指南难以覆盖所有边缘情况。
因此,更合理的期待是把这类指南当作「地图」而非「路线图」——它告诉你有哪些地形和工具,但具体路径仍需结合自身情况探索。社区讨论中若有人分享实际踩坑经验,其价值往往不亚于指南本身。
对于关注推理工程的从业者,建议持续跟踪 Hacker News 上相关帖子的讨论,并关注开源框架的发布说明和基准更新。开放指南与社区实践的结合,才是应对快速变化的最佳策略。
相关推荐
AI替你写代码,还要学Git吗?五个理由
AI编程代理能自动处理Git操作,还有必要学Git吗?本文提炼五个理由:与团队沟通、审阅代理提交的PR、监督代码改动、在AI宕机时兜底,以及学习本身的乐趣,并分析代理时代Git学习重心的转移。

Anthropic据报以每股83美元定价IPO,估值达1.5万亿美元
Anthropic据报以每股83美元定价IPO,高于预期发行区间,完全稀释估值达1.5万亿美元。本文分析此次定价的信号意义及其对AI行业融资环境的影响。

纳德拉预言:AI代理将重塑网络经济规则
微软CEO纳德拉预测AI代理将重新洗牌网络经济,冲击广告驱动模式,并迫使亚马逊等平台重新思考客户争夺方式。本文解析代理经济对广告、电商与平台竞争逻辑的影响。