推理强度拉满值不值?1800次实测4款模型给出答案

1800次调用测4款模型:推理强度旋钮只修好了一件事,却让所有任务都更贵。
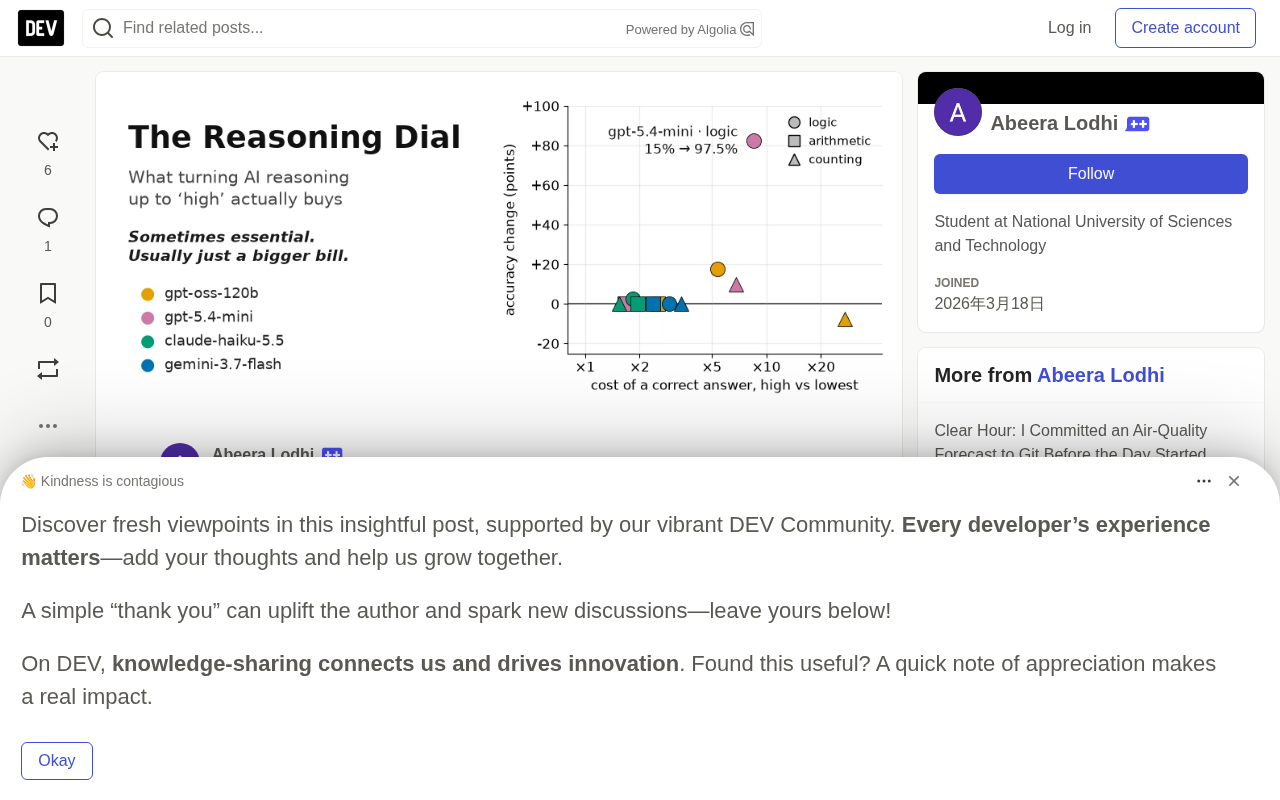
一位开发者在 Kaggle Benchmarks 上构建 Reasoning Dial 基准,固定题目、prompt 和评分器,只改变 reasoning_effort 取值,对 4 款模型完成 1800 次评分调用。结果显示:12 个模型×任务组合中,只有 gpt-5.4-mini 在逻辑推理上出现显著提升(15%→97.5%),其余无统计显著效果;7/12 组合准确率不变但每个正确答案成本上升 1.5–3.4 倍。同一参数在不同厂商行为差异巨大:gpt-5.4-mini 的 token 消耗放大 14 倍,gpt-oss-120b 拒绝 none 并返回 HTTP 400,Gemini 在 none 下就消耗 453 个隐形推理 token。干扰计数任务中所有错误都是高估,且错误答案的 token 消耗显著高于正确答案。结论是:推理强度对准确率的边际贡献接近于零,对成本的边际贡献始终为正。
几乎每个主流模型 API 都有一个叫 reasoning_effort、thinking 或 reasoning 的参数。开发者每天在设它,但几乎没人测量过它的真实效果。一位开发者在 Kaggle Benchmarks 上构建了一个名为 Reasoning Dial 的基准测试,唯一变量就是这个旋钮,跑完 1800 次评分调用、4 款模型后,得出的结论并不好听:它只修好了一件事,却对所有任务都提高了账单。
基准测试怎么设计的?
Reasoning Dial 的核心思路是只改一个变量:同一个 60 道代码生成的题目集、同一份 prompt、同一个确定性评分器,唯一变化的就是 reasoning_effort 的取值(none / low / medium / high)。
测试包含三种任务类型,故意设计得互相矛盾:
- Deduce(逻辑推理):7 人 7 天排班谜题,6-12 条线索,暴力枚举确认唯一解。这是推理应该帮上忙的场景。
- Arith(算术):六步应用计算题,含百分比和整除步骤。这是对照组——校准阶段所有模型在
none下就已经 100% 正确。 - Distract(干扰计数):"你有一把凿子和一把电钻",后面跟 1-3 个无关数字,要求计算工具数量。这是推理可能反而帮倒忙的场景。
所有假设、prompt 和解析器都在正式运行前写入预注册文件,60 道测试题通过 SHA-256 哈希锁定。分析脚本在哈希不匹配时拒绝运行。
四个旋钮位置,四种截然不同的行为
第一个重要发现:同一个参数名,在不同厂商那里根本不是一个东西。
页面中位数输出 token 展示了四种完全不同的行为模式:
| 模型 | none → low → medium → high | high ÷ 最低 |
|---|---|---|
| gpt-5.4-mini | 18 → 168 → 195 → 254 | ×14.1 |
| gpt-oss-120b | 拒绝 → 292 → 446 → 1,340 | ×4.6 |
| claude-haiku-5.5 | 150 → 162 → 171 → 298 | ×2.0 |
| gemini-3.7-flash | 453 → 446 → 566 → 1,013 | ×2.2 |
gpt-5.4-mini 的 token 消耗从 18 飙升到 254,放大了 14 倍。而 gemini-3.7-flash 在 none 下就已经消耗了 453 个中位 token——比 gpt-5.4-mini 在 high 下的 254 还多。Gemini 在 none 和 low 下不返回推理轨迹,看起来和一秒出答案的模型没区别,但你在为那些看不见的思考付费。
gpt-oss-120b 则直接拒绝 none,返回 HTTP 400。如果你把 reasoning_effort="none" 写进多厂商配置,这四款模型里有一款会直接报错。
推理轨迹(reasoning trace)与隐形思考:很多推理模型在返回最终答案前,会先生成一段“思考过程”文本,通常以独立字段或特殊分隔符返回,这段内容就是推理轨迹。它是模型内部链式思考的外显化,但并非所有厂商都会把它暴露给调用方。Gemini 在 none 和 low 档位下不返回推理轨迹,用户只看到一个快速给出的答案,然而计费仍按实际生成的 token 计算——也就是说,那些被隐藏的思考 token 照样计入账单。判断一个模型是否在“隐形思考”,不能只看响应里有没有推理文本,还要对比 usage 字段中的输出 token 数与可见答案的长度。
HTTP 400 与参数取值域:不同厂商对 reasoning_effort 的合法取值定义不同。OpenAI 系列通常接受 none/low/medium/high,而 gpt-oss-120b 这类模型把 none 视为非法输入,直接返回 HTTP 400 Bad Request。这意味着,如果代码里写死了 reasoning_effort="none",在多厂商路由场景下会有一款模型直接调用失败。生产环境需要为每个模型维护独立的参数取值白名单,或在网关层做参数映射与降级。
唯一一次真实的准确率提升
在 12 个模型 × 任务组合中,只有 gpt-5.4-mini 在逻辑推理任务上出现了统计显著的准确率提升:从 15% 跃升到 97.5%,霍姆校正后 p = 0.00056。
但在 none 下,它的 15% 正确率几乎等同于随机猜名。主要增益来自第一步:none 到 low 加了 60 个百分点,后续每一步增加更少、花费更多。
另外两款模型的逻辑推理表现值得注意:Claude Haiku 5.5 在 none 下就得了 97.5%,Gemini 是 100%。对它们来说,旋钮往上拧只是在一个已经解决的问题上多花钱。
干扰计数:错的都是"算多了"
预注册假设 H2 认为更多思考会在干扰计数任务上帮倒忙。显著性检验没有支持这个假设——没有模型在 high 下显著变差。
但错误的方向很有意思:**所有错误的干扰计数答案,无一例外都是高估了。**没有任何模型给出低于正确答案的数字。模型不是分不清自己有什么工具,而是把干扰数字加了进去。
而且回复越长,答案越可能出错。gpt-5.4-mini 在 high 下的错误答案中位 token 数是 412,正确答案是 91.5。gpt-oss-120b 更夸张:错误答案用了 5,776 token,正确答案只用 747。最极端的一次,gpt-oss-120b 花了 21,875 token 和将近四分钟,回答"6",而正确答案是"5"。
研究者对此的表述是:更多努力给了模型更大的高估空间,而不是简单地"让结果变差"。
预注册与显著性检验:预注册指在研究开始前,把假设、实验设计、prompt、评分器和分析脚本全部固定并公开(或锁定哈希),防止事后根据数据挑选有利结论。本文用 SHA-256 锁定 60 道题,分析脚本在哈希不匹配时拒绝运行,正是为了保证结论不是“看着数据编故事”。显著性检验则用来判断观察到的差异是否可能由随机波动造成。文中提到的霍姆校正(Holm correction)是一种多重比较校正方法:当同时检验多个模型×任务组合时,假阳性概率会累积,霍姆校正通过逐步调整 p 值阈值来控制整体错误率。因此,“p = 0.00056”是在校正之后仍然显著的结果,可信度更高;而“不显著”并不等于“没有效果”,只是样本量不足以排除随机性。
账单从不缺席
这是最值得展示给生产环境决策者看的数据:
**12 个组合中有 7 个,high 只改变了价格。**准确率不变,但每个正确答案的成本上升了 1.5 到 3.4 倍。
在对照组算术任务上,所有模型准确率不变,但每个正确答案的成本上升了 1.65 到 2.5 倍。在已经解决的问题上花更多推理预算,买不到任何东西。
gpt-oss-120b 在干扰计数上每个正确答案花了约 25 倍的成本,准确率反而低了 7.5 个百分点(不显著)。
唯一的大赢家也很贵:gpt-5.4-mini 的逻辑推理修复,每个正确答案的成本上升了 8.5 倍。
每个正确答案的成本:衡量推理强度性价比时,单看总花费或单看 token 单价都不够,更直观的指标是“每个正确答案的成本”,即总花费除以答对题数。它同时反映了准确率和 token 消耗:准确率不变而成本上升,说明多出来的推理预算没有换来任何正确率提升;准确率提升但成本上升更快,则要判断提升幅度是否值得。本文提到的 1.5–3.4 倍、1.65–2.5 倍、8.5 倍、25 倍,都是这个口径下的倍数变化。在对照组的算术任务上,所有模型准确率已经 100%,因此成本上升完全来自多余的思考 token,属于纯粹的浪费。
对整个项目的总结
整个主实验花费 4.20 美元,包含预实验和校准轮次约 6.38 美元。以下是四个预注册假设的最终结果:
- H1(旋钮不是同一种工具):支持。token 缩放从 ×2 到 ×14,gpt-oss-120b 拒绝
none,Gemini 的none≈low且隐形思考。 - H2(更多思考在干扰计数上有害):不支持。没有显著下降,但所有错误都是高估,错误答案更长。
- H3(更多思考有助于演绎推理):仅 gpt-5.4-mini 支持。15% → 97.5%。
- H4(准确率不涨时账单照涨):支持(描述性)。7/12 组合不变,成本上升 1.5-3.4 倍。
实际建议
基于 20 题/任务族、2 次重复、4 款模型的规模,这些是起点而非定论:
- 先测
none。 四款模型中有两款在最低设置下就已经接近满分。 - 如果
none不行,先试low再试high。 对于唯一需要旋钮的模型,none到low贡献了 82.5 分中的 60 分。 - 不要假设同一档位在不同厂商那里效果一样。
none在一个模型上报错,在另一个模型上是隐形思考,在第三个模型上才是真正的关闭。 - 警惕简单问题得到长回答。 在干扰计数任务上,长回答就是错误回答。
这项研究的最大贡献不在于告诉你要把旋钮设成什么,而在于揭示了一个被忽视的事实:**在大多数场景下,推理强度这个参数对准确率的边际贡献接近于零,但对成本的边际贡献始终为正。**在把它拧到 high 之前,先看看 none 能给你什么。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。