托管大模型行为评估的可复现性危机:测量方法比模型更影响结论

同一模型同一评测方法在不同时间可能得出相反结论,论文将验证问题拆解为复现、测量敏感性与持续性三个独立维度。
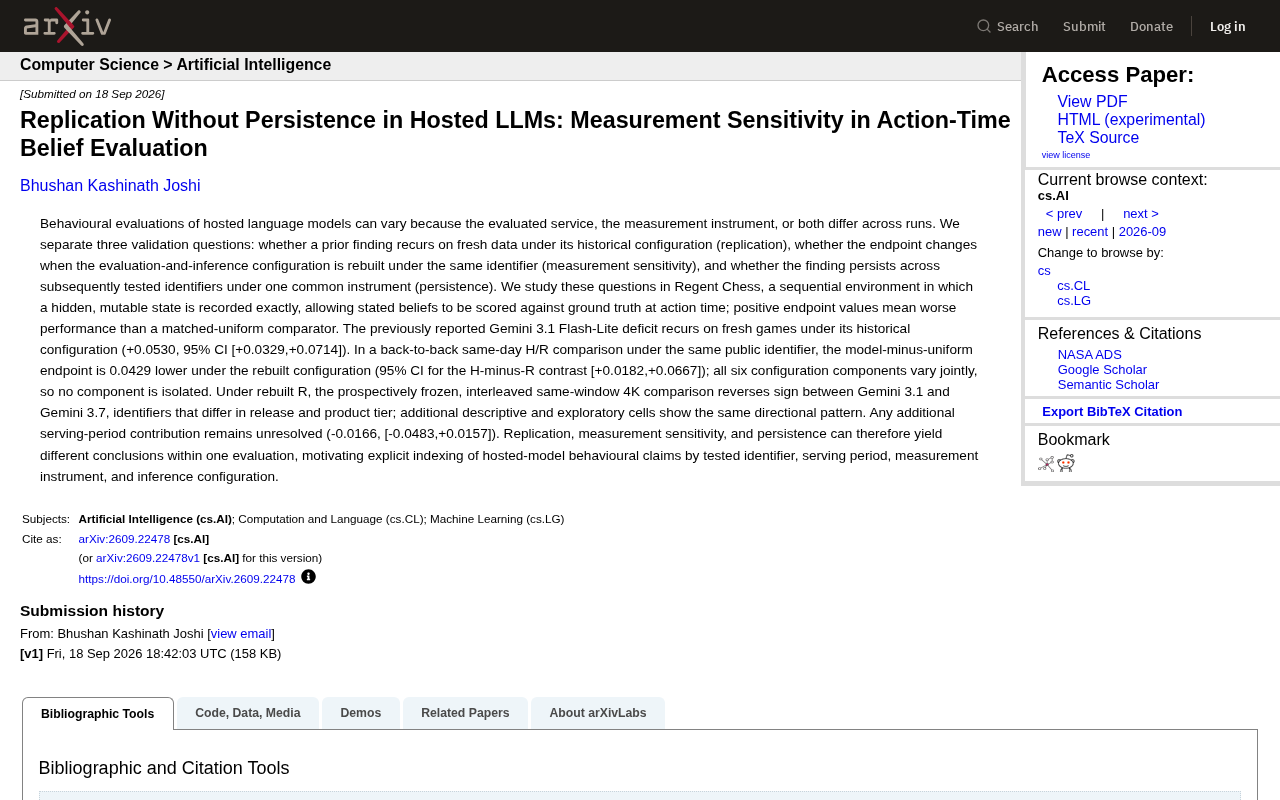
arXiv论文《Replication Without Persistence in Hosted LLMs》指出,对托管大语言模型的行为评估面临一个根本性困境:当两次评估结果不同时,无法判断是模型服务变了还是测量工具变了。论文将"验证"拆分为复现、测量敏感性、持续性三个独立问题,并以Regent Chess序贯决策环境为实验平台——该环境通过精确记录隐藏状态,使模型声称的信念可与真值量化比对。以Gemini 3.1 Flash-Lite为案例,论文发现:历史缺陷可复现(端点值+0.0530),但仅重建评测配置就使端点值显著下降(-0.0429),且重建配置下Gemini 3.1与3.7的对比符号发生反转,持续性失效。三个维度在同一次评估中给出了相互矛盾的结论,这要求行业对任何托管模型的性能声明都必须显式标注模型标识符、服务周期、测量工具与推理配置四个维度。
为什么同一个模型两次评估结果不一样
托管型大语言模型(Hosted LLM)的行为评估正面临一个棘手问题:同一个模型、同一套评测方法,在不同时间运行时可能得出截然不同的结论。arXiv 上一篇新论文《Replication Without Persistence in Hosted LLMs》直指这一痛点——当评估结果发生变化时,我们往往无法判断到底是被测服务变了,还是测量工具变了,抑或两者同时改变。
这个问题对整个行业的可信度评估都构成挑战。厂商持续更新线上模型,同一个公开标识符(如 gemini-3.1-flash-lite)背后的实际服务可能已经悄然改变;同时,研究者的评测脚本、推理配置也在迭代。当两个变量纠缠在一起时,任何"某模型表现更差"的结论都可能站不住脚。
三个必须分开的验证问题
论文的核心贡献是把"验证"这件事拆解成三个独立的问题,避免混为一谈:
复现(Replication)
在历史配置不变的前提下,用全新数据重跑,看之前的发现是否重现。这是最经典的科学复现概念。
测量敏感性(Measurement Sensitivity)
保持同一个模型标识符,但把"评估+推理"的配置整体重建后,端点指标是否发生变化。换句话说,测量工具本身的变化会带来多大影响。
持续性(Persistence)
在同一套统一工具下,某个发现是否能延续到后续测试的其他模型标识符上。这检验的是结论的普适性。
作者强调,这三个问题在一次评估中完全可能得出不同答案——这正是当前评估实践容易翻车的地方。
这三个概念的区分根植于科学哲学中的可重复性危机(Replication Crisis)讨论。传统科学领域的"复现"通常假设被研究对象是稳定的——一种化合物、一种动物行为。但托管LLM打破了这一前提:模型服务是持续更新的软件系统,厂商可能在不更换公开标识符的情况下悄然替换底层权重、调整采样策略或修改系统提示模板。这使得"测量工具变化"与"被测对象变化"在时间轴上几乎不可能完全隔离,除非研究者拥有对服务端的精确控制权。正因如此,论文将"测量敏感性"单独剥离出来,专门度量评估框架自身带来的噪声。
Regent Chess:一个能对齐真值的测试环境
研究选用了名为 Regent Chess 的序贯决策环境。它的巧妙之处在于:环境中存在一个隐藏且可变的状态,但这个状态被精确记录下来。这意味着模型在行动时所"声称的信念"(stated beliefs)可以与真实状态(ground truth)逐一比对打分。
评估采用的端点指标是"模型减去匀称对照组"(model-minus-uniform)的差值,正值代表比对照更差。这种设计让抽象的"信念准确性"变得可量化、可审计,为区分上述三个验证问题提供了干净的实验平台。
序贯决策环境(Sequential Decision Environment)是评估LLM推理能力的一类常见实验设置,模型需要在多步交互中基于当前观测状态做出行动选择。多数此类环境的难点在于"信念"难以量化——模型生成的自然语言推理过程无法与客观状态精确比对。Regent Chess通过设计一个对模型不可见但被评估者精确追踪的隐藏变量,解决了这一问题。"模型减匀称对照组"(model-minus-uniform)指标的设计思路类似于对照实验中的基线校正:匀称对照组(uniform baseline)代表一个对隐藏状态完全无知、均匀猜测的下界,正差值意味着模型表现甚至不如随机猜测,是一种直观的性能退化信号。
关键实验发现:三种结论各不相同
论文以 Gemini 3.1 Flash-Lite 之前报告的性能缺陷为切入点,逐一检验:
复现成立:在历史配置下用全新对局重跑,之前报告的缺陷确实重现,端点值为 +0.0530(95% 置信区间 [+0.0329, +0.0714])。发现是真实存在的。
测量敏感性显著:在同一天、同一个公开标识符下做背靠背的 H/R 对比,重建配置后模型减匀称的端点值降低了 0.0429(H-minus-R 对比的 95% CI 为 [+0.0182, +0.0667])。问题在于——六个配置组件是同时变化的,因此无法孤立出是哪一个组件造成了差异。仅仅重建评测配置,就足以改变结论。
持续性失效:在重建的 R 配置下,预先冻结、交错进行的同窗口 4K 对比中,Gemini 3.1 与 Gemini 3.7(发布时间与产品层级都不同的两个标识符)之间的符号发生了反转。额外的描述性与探索性单元也显示出相同的方向性模式。至于服务周期(serving period)本身的额外贡献,则始终未能厘清(-0.0166,[-0.0483, +0.0157])。
对行业评估实践的启示
这项研究传递的核心信息是:复现、测量敏感性和持续性可以在同一次评估中给出彼此矛盾的结论。这意味着,任何关于托管模型行为的断言,都不能只说"某模型好或差",而必须显式标注四个维度:
- 被测试的模型标识符(tested identifier)
- 服务周期(serving period)
- 测量工具(measurement instrument)
- 推理配置(inference configuration)
对于依赖第三方评测榜单做决策的开发者和企业,这是一个重要提醒:线上模型不是静止的靶子,一次评测的结论有明确的"保质期"和适用边界。缺少这些索引维度的性能声明,可能在下一次运行时就不再成立。
这也为评测方法学社区提出了更高要求——只有把服务侧变化与测量侧变化解耦,行为评估才能真正具备可信度和可比性。
论文提出的四维标注框架与机器学习可重复性领域近年倡导的"模型卡片"(Model Card)和"数据表"(Datasheet)理念相呼应,但更侧重评估行为而非模型本身的静态描述。服务周期(serving period)这一维度尤为关键却常被忽略——它要求研究者记录评估运行的时间窗口,以便他人判断所引用结论是否仍适用于当前服务版本。对于依赖API的基准测试(如LMSYS Chatbot Arena等在线榜单),这意味着历史排名条目在严格意义上只对特定时间窗口内的服务状态有效,跨时间的横向比较需要额外的方法论保障才能支撑强结论。
相关推荐

Jev判断模型实战:6类高频应用场景全解析
Jev是全新的AI判断模型,擅长大规模、高速、低成本的瞬间判断。本文梳理Choice、Score、Null三种提问方式,解析数据分析、语义搜索、输入分流、规则检查、加速智能体、即时响应六大真实应用场景,并给出适用判断标准与风险提示。

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。