TutlAit v1:摩洛哥塔马齐格特语语音数据集的众包实践

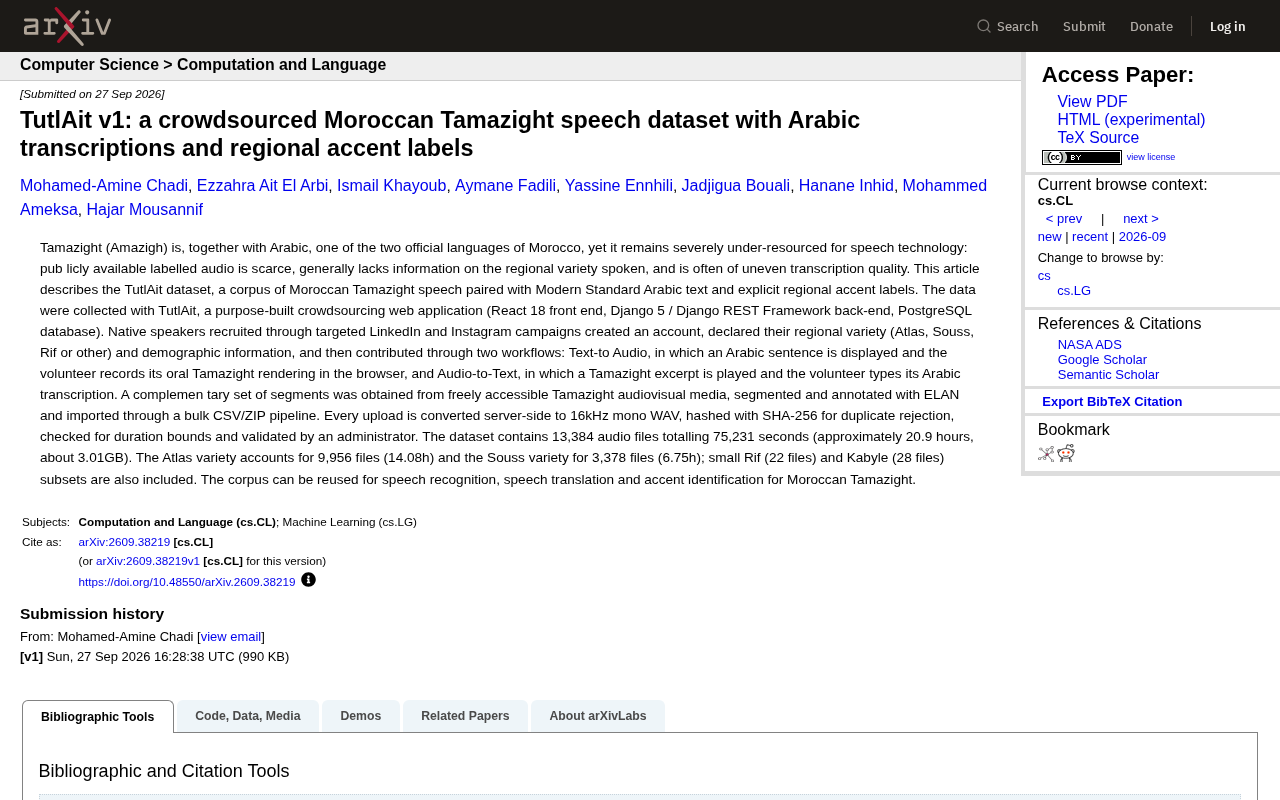
TutlAit:首个带地区口音标签的摩洛哥塔马齐格特语众包语音数据集,含约21小时标注音频。
TutlAit 是为填补塔马齐格特语(摩洛哥官方语言之一)在语音技术领域数据严重匮乏而构建的众包语料库。该数据集将塔马齐格特语语音与现代标准阿拉伯语文本配对,并附有阿特拉斯、苏斯、里夫等地区口音标签,采集平台基于 React 18 + Django 5 + PostgreSQL 技术栈,支持"文本转音频"与"音频转文本"双向工作流。最终版本包含13,384个音频文件、约20.9小时语音,服务端统一转为16kHz单声道WAV并通过SHA-256哈希去重与人工审核保障质量。数据以阿特拉斯和苏斯变体为主,里夫和卡比尔变体仅各有数十条,存在明显不均衡。该数据集可用于语音识别、语音翻译和口音识别任务,其社区驱动、低成本的众包方法论对全球其他低资源语言的数据建设具有参考价值。
一个被技术遗忘的官方语言
塔马齐格特语(Tamazight,也称阿马齐格语/Amazigh)与阿拉伯语并列为摩洛哥的两种官方语言,但在语音技术领域,它长期处于严重的资源匮乏状态。公开可用的标注音频数据稀少,往往缺乏说话者所属地区变体的信息,转写质量也参差不齐。这种困境让塔马齐格特语在自动语音识别、语音翻译等现代AI应用中几乎无从立足。
TutlAit 数据集的出现,正是为填补这一空白而来。它是一个将摩洛哥塔马齐格特语语音与现代标准阿拉伯语文本配对、并带有明确地区口音标签的语料库,为低资源语言的语音技术研究提供了一份难得的基础素材。
塔马齐格特语属于亚非语系柏柏尔语族,是北非原住民柏柏尔人(自称 Imazighen,意为"自由之人")的母语。它在摩洛哥、阿尔及利亚、突尼斯等地均有分布,内部又分化为多个地区变体,彼此在语音、词汇、语法上差异显著,因此常被视为一个方言连续体而非单一语言。摩洛哥于2011年将其写入宪法,确立官方语言地位,但教育、政务与媒体中实际使用仍以阿拉伯语和法语为主。在自然语言处理领域,"低资源语言"特指缺乏大规模标注语料的语言——训练现代神经网络语音模型通常需要数百甚至数千小时的高质量标注音频,而塔马齐格特语公开可用的数据远不及此门槛,导致商业语音助手与自动转写工具对其几乎全面缺席。
众包平台的技术架构
该数据集通过一个专门构建的众包网页应用采集完成。这套系统采用了相当标准的现代Web技术栈:前端使用 React 18,后端基于 Django 5 与 Django REST Framework,数据存储则采用 PostgreSQL 数据库。
研究团队通过 LinkedIn 和 Instagram 上的定向推广活动招募母语使用者。志愿者注册账号后,需要声明自己所属的地区变体(阿特拉斯 Atlas、苏斯 Souss、里夫 Rif 或其他)以及人口统计信息,再通过两种工作流进行贡献。
两种互补的采集工作流
第一种是「文本转音频」(Text-to-Audio):系统展示一句阿拉伯语句子,志愿者在浏览器中录制其对应的塔马齐格特语口语表达。第二种是「音频转文本」(Audio-to-Text):系统播放一段塔马齐格特语音频,志愿者输入其阿拉伯语转写。这两种双向工作流相互补充,既能从文本生成语音,也能为既有语音补充转写。
除了众包采集,团队还从可自由获取的塔马齐格特语视听媒体中提取了一批补充片段,使用 ELAN 工具进行切分和标注,并通过批量 CSV/ZIP 管道导入系统。
ELAN(EUDICO Linguistic Annotator)是由荷兰马普心理语言学研究所开发的多媒体语言标注工具,广泛用于田野语言学与语料库建设。它支持在音视频时间轴上创建多层级的分层标注轨道,研究者可精确标记每段话语的起止时间戳、说话人身份、转写文本及语言学注释,并能将结果导出为多种通用格式。在 TutlAit 的补充片段处理流程中,ELAN 承担了将连续媒体素材切分为短句级别片段并附加文本标注的工作,这一步骤是将原始广播或网络视频转化为可训练语音样本的必经环节。
严格的数据质量把控
数据质量的管理是语音语料库可用性的关键。TutlAit 在服务器端对每一次上传都做了统一处理:音频被转换为 16kHz 单声道 WAV 格式,并使用 SHA-256 哈希进行去重,拒绝重复文件。系统还会检查音频时长是否在合理范围内,最终由管理员进行人工验证。
这套流程在众包场景下尤为重要——众包数据天然存在质量不均、重复提交等问题,而哈希去重加上时长边界检查与人工审核的组合,能在一定程度上保证入库数据的基本可靠性。
SHA-256 是一种密码学哈希函数,能将任意长度的文件内容映射为固定的256位摘要字符串。只要文件内容有任何一比特的差异,生成的哈希值便完全不同;反之,两个文件哈希值相同则可以极高置信度判定内容完全一致。在众包音频场景中,同一志愿者反复上传相同录音,或不同志愿者碰巧提交同一段音频片段,均会产生完全相同的哈希值,系统据此可自动拒绝重复入库,而无需对音频内容做任何解码或人工比对,兼顾了效率与准确性。16kHz 单声道 WAV 的格式统一化则确保所有音频具备相同的采样率与声道数,避免后续模型训练时因格式不一致引入噪声。
数据集规模与地区分布
最终的 TutlAit v1 数据集包含 13,384 个音频文件,总时长 75,231 秒(约 20.9 小时,约 3.01GB)。从地区变体分布来看,数据呈现明显的不均衡:
- 阿特拉斯(Atlas)变体:9,956 个文件,约 14.08 小时,占据主体
- 苏斯(Souss)变体:3,378 个文件,约 6.75 小时
- 里夫(Rif)变体:仅 22 个文件
- 卡比尔(Kabyle)变体:仅 28 个文件
阿特拉斯与苏斯两种变体合计占了绝大部分数据,而里夫和卡比尔子集则规模极小。这种分布反映了众包招募的实际局限——不同地区母语者的参与度差异会直接体现在数据量上。对于后续想要训练覆盖全部变体的模型而言,里夫和卡比尔的小样本仍是明显短板。
应用价值与意义
按照论文的定位,TutlAit 语料库可以复用于摩洛哥塔马齐格特语的语音识别、语音翻译以及口音识别三类任务。带有地区口音标签这一设计,让它在口音识别和方言研究上具备独特价值——大多数低资源语音数据集并不区分地区变体。
从更宏观的角度看,TutlAit 是一个典型的「社区驱动 + 工程化流程」解决低资源语言数据问题的范例。它没有依赖昂贵的专业录音,而是用社交媒体招募、浏览器录音、自动化去重与人工审核相结合的轻量方案,在有限投入下积累了约 21 小时的标注语音。对于全球众多同样缺乏技术资源的语言而言,这种可复制的众包方法论或许比数据集本身更有参考意义。
相关推荐

支撑阻力七步法:一套可复制的交易策略拆解
一位七年经验操盘手公开其支撑阻力七步交易法:从4小时图标注高低点、设置提醒,到1分钟图寻找突破入场,固定2:1盈亏比。本文完整拆解策略流程并还原55%胜率、2.4盈亏比的真实数据,并理性分析其适用边界。

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。