TwinCheck:用「负孪生」反事实验证修复工具智能体的错误调用

TwinCheck 通过证据驱动的「负孪生」验证机制,将 LLM 工具调用智能体的任务成功率提升13个百分点且零回退。
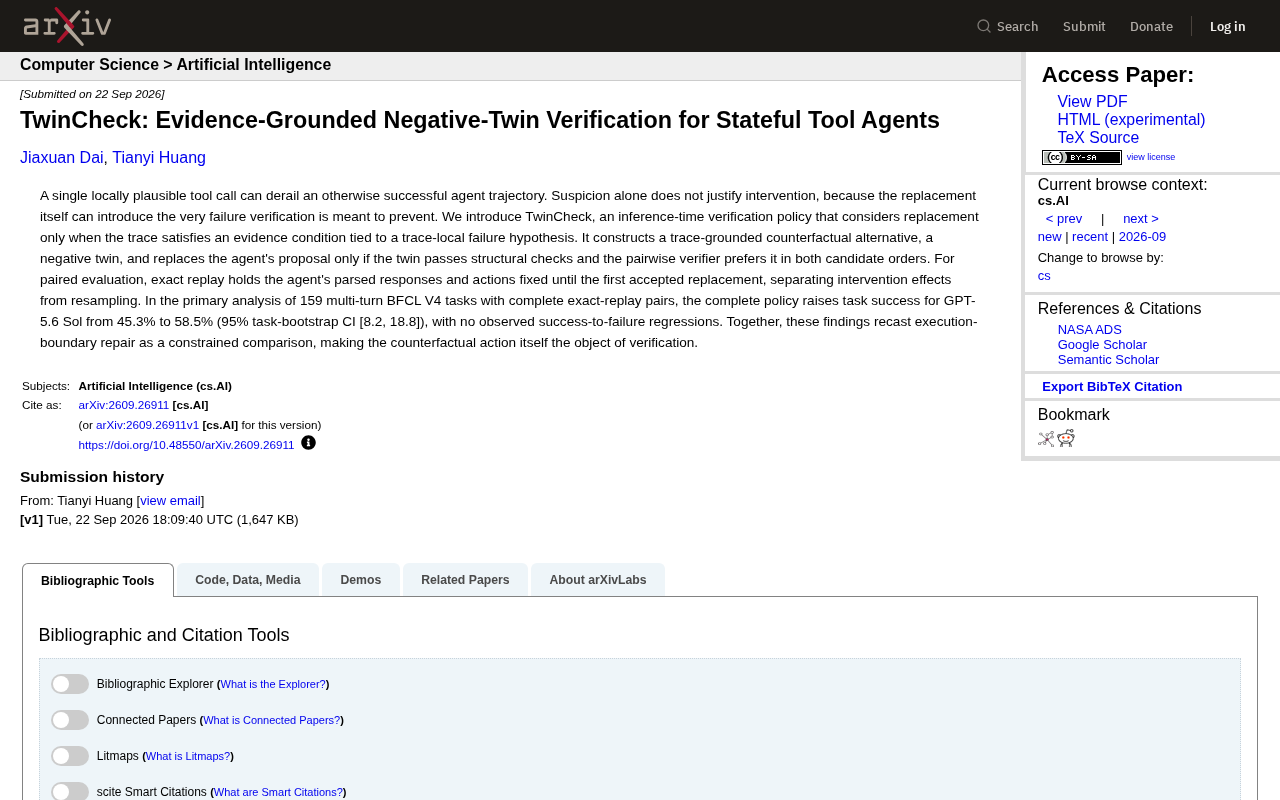
TwinCheck 是一种针对有状态工具调用智能体的推理阶段验证策略,旨在解决「错误修复本身也可能引入新错误」的两难困境。其核心思路是将干预门槛提高:只有当执行轨迹满足特定证据条件时,系统才会构造一个「负孪生」反事实候选动作;该候选必须通过结构性检查,且在双向排序下均被成对验证器偏好,才会真正替换原提议。为避免评估时将干预效果与重采样随机性混淆,TwinCheck 引入「精确重放」成对评估方法,冻结非干预步骤以实现干净的因果对照。在 159 个 BFCL V4 多轮任务上,该策略将 GPT-5.6 Sol 的成功率从 45.3% 提升至 58.5%,且无任何成功转失败的回退,为构建可靠的生产级智能体提供了实用方法论。
一个错误的工具调用如何毁掉整条智能体轨迹
在构建基于大语言模型的工具调用智能体(tool agent)时,一个看似合理、局部可信的工具调用(tool call),足以让原本能够成功完成任务的执行轨迹彻底偏离正轨。这是当前有状态智能体(stateful tool agents)面临的核心可靠性难题。
更棘手的是,仅凭「怀疑」并不足以支撑干预决策。因为替换动作本身也可能引入它原本要预防的那种失败——你以为在纠错,结果制造了新的错误。这种「修复反而破坏」的两难,正是 arXiv 最新论文《TwinCheck: Evidence-Grounded Negative-Twin Verification for Stateful Tool Agents》试图解决的问题。
TwinCheck 的核心机制:证据驱动的负孪生验证
TwinCheck 是一种在推理阶段(inference-time)运行的验证策略,它的设计哲学与传统的「一有疑虑就替换」截然不同——它把干预的门槛提得更高、更有据可依。
只在满足证据条件时才考虑替换
TwinCheck 并不会对每一个可疑动作都出手。只有当执行轨迹(trace)满足与某个「轨迹局部失败假设」(trace-local failure hypothesis)绑定的证据条件时,系统才会进入替换考量流程。换句话说,怀疑必须落地为有证据支撑的失败假设,才有资格触发后续动作。
构造「负孪生」反事实候选
一旦证据条件满足,TwinCheck 会构造一个基于轨迹的反事实替代方案,作者称之为「负孪生」(negative twin)。这个负孪生是与当前轨迹紧密绑定的对照候选动作。
关键在于替换的判定条件极为严格:只有当负孪生同时通过结构性检查(structural checks),并且成对验证器(pairwise verifier)在两种候选排序下都偏好它时,系统才会真正替换掉智能体原本的提议。这种「双向排序都需胜出」的设计,有效抑制了验证器自身偏差带来的误判。
「有状态智能体」(stateful tool agents)是指在多轮交互过程中维护持久状态的 LLM 智能体——每一步工具调用的结果都会写入执行轨迹,并影响后续决策。与无状态的单次问答不同,有状态智能体的错误具有级联效应:一个错误的 API 调用可能修改数据库记录、触发外部服务,或导致后续所有步骤都在错误前提下推进。这也是为什么「是否替换可疑动作」的决策成本如此之高——轨迹一旦分叉,很难无损回滚到原始状态。
「成对验证器」(pairwise verifier)是一种比较式评判机制,它不直接给单个候选打分,而是将两个候选(此处为原始提议与负孪生)并排呈现,判断哪一个更优。这种方式比绝对评分更稳健,因为 LLM 在相对比较中的偏差更易被察觉和控制。TwinCheck 要求在「A vs B」和「B vs A」两种呈现顺序下验证器均偏好负孪生,这一「双向排序一致性」设计专门针对 LLM 验证器已知存在的位置偏差(position bias)问题——即模型倾向于偏好先出现的选项,通过两次排序交叉验证可有效过滤此类系统性误判。
精确重放:把干预效果和重采样噪声分离开
评估智能体干预效果时,一个常被忽视的陷阱是:你无法确定性能提升究竟来自「有效的干预」,还是来自「重新采样恰好碰运气」。
TwinCheck 引入了「精确重放」(exact replay)的成对评估方法来解决这一问题。它会保持智能体已解析的响应和动作固定不变,直到出现第一个被接受的替换为止。这样一来,干预带来的效果就能与重采样的随机波动清晰地分离开,让评估结果更具因果说服力。
这一点对于智能体研究的方法论意义不小——它把「修复到底有没有用」这个模糊问题,转化成了一个可控、可复现的对照实验。
实验结果:任务成功率从 45.3% 提升到 58.5%
在论文的主要分析中,研究者选取了 159 个多轮 BFCL V4 任务,且这些任务都具备完整的精确重放配对数据。
结果相当亮眼:完整策略将 GPT-5.6 Sol 模型的任务成功率从 45.3% 提升到 58.5%,95% 任务自助法置信区间(task-bootstrap CI)为 [8.2, 18.8]。更值得关注的是,实验中没有观察到任何「成功变失败」的回退(regression)。
这意味着 TwinCheck 的干预是「只增不减」的——它在提升成功率的同时,没有牺牲原本已经能完成的任务。对于追求稳定性的生产级智能体系统而言,这种「无负面回退」的特性可能比单纯的平均性能提升更有价值。
BFCL(Berkeley Function Calling Leaderboard)是由加州大学伯克利分校发布的工具调用能力评测基准,专门测量 LLM 在真实 API 调用场景下的准确性。V4 版本是其多轮对话扩展版,要求模型在多步骤交互中持续正确地调用工具、处理返回结果并规划后续动作,比单轮调用评测更贴近生产环境。「任务自助法置信区间」(task-bootstrap CI)是一种基于自举重采样的统计方法,通过对任务集合反复随机重采样来估计性能指标的波动范围,置信区间 [8.2, 18.8] 表明 13.2 个百分点的提升在统计上具有显著性,并非偶然波动。
方法论意义:把执行边界修复重塑为受约束的比较
TwinCheck 最深层的贡献,或许在于它对「执行边界修复」(execution-boundary repair)这一问题的重新定义。
传统思路往往把修复看作「检测异常 → 直接替换」的单向流程。而 TwinCheck 将其重塑为一个受约束的比较问题(constrained comparison):验证的对象不再是模糊的「这个动作是不是错了」,而是明确的反事实动作本身——负孪生候选究竟是否优于原提议。
通过让反事实动作成为验证的直接对象,TwinCheck 把智能体的自我纠错从「凭直觉干预」推向了「有证据、有对照、有结构约束」的严谨决策框架。这为构建更可靠的有状态工具智能体提供了一条值得关注的技术路径。
小结
对于正在开发 LLM 智能体、Agent 框架或工具调用系统的研究者和工程师来说,TwinCheck 提供了几个可借鉴的思路:干预需要证据门槛而非单纯怀疑、反事实候选应作为验证核心对象、以及用精确重放来干净地评估干预效果。这些原则共同构成了一套抑制智能体轨迹脱轨的实用方法论。
相关推荐

一场与Grok的对话能否影响重大决策?素材不足的警示
一则关于美国因与Grok对话影响委内瑞拉决策的Hacker News标题引发关注,但缺乏正文与信源。本文探讨此类耸动标题的识别方法与AI在决策中的真实边界。

AI编程为何离不开Git?从版本回退到AI辅助命令全解析
Git是AI编程的必备工具。本文解析Git分布式版本控制在AI编程中的价值,包括应对AI幻觉的版本回退、分支管理等核心操作,以及如何用豆包、AI输入法等工具快速生成Git命令,帮助新手零基础入门。

拒绝AI胡编:一款"说不了谎"的求职信生成器是如何炼成的
一位开发者因AI求职信工具凭空捏造其Kubernetes经验和管理经历而屡遭拒信,于是打造了CoverCraft——通过代码计算评分、GitHub提交记录背书、对抗性审查与人工审批四重机制,构建一款"无法说谎"的AI求职信生成器。本文解析其对抗AI幻觉的工程设计。