TypeSafe发布Jev:面向代码决策的毫秒级AI模型
Jev是专为机器决策设计的非生成式AI模型,毫秒级响应、成本低20-200倍,填补确定性软件与AI智能体之间的鸿沟。
TypeSafe推出的Jev模型彻底颠覆了主流大模型的设计逻辑:它不生成任何文本,而是并行接收结构化输入,返回带置信度的类型化决策(选择、评分、布尔判断)。得益于摒弃自回归循环的架构,Jev响应时间仅需毫秒级,成本比同类模型低20至200倍。Vercel实测验证了这一优势,分类任务速度提升约6倍且准确率"基本饱和"。其命名源自卡尼曼双系统理论,定位为"系统1"式的快速直觉判断,核心价值在于嵌入确定性软件架构,承接那些传统if/else逻辑无法处理、又不值得动用全能LLM的高频决策节点,典型场景包括模型路由、护栏替代和工具调用决策。
一个不写文本的AI模型
我们熟悉的绝大多数前沿模型——从ChatGPT到Gemini——本质上都在做同一件事:一个Token接一个Token地生成供人类阅读的文本。而由TypeSafe(视频中亦称TypeSpace,母公司为System 1)推出的新模型Jev,走的是完全不同的路线。
据视频介绍,Jev由前ChatGPT联合创始人之一Diego Almeida参与的团队发布。它的定位很明确:不是让你聊天的模型,而是为代码执行产生「决策」的模型。它无法解释自己,甚至写不出一句完整的话,但在特定任务上表现出了非同寻常的效率。
核心痛点在于:现有大模型是为人类偏好训练的,这让它们在机器使用场景中并不理想——容易出现模式崩塌、过度自信以及缺乏可靠性。TypeSafe团队花了两年时间重新设计训练流程,提出了所谓「校准决策的强化学习」(calibrated decision RL)。
速度与成本的量级差异
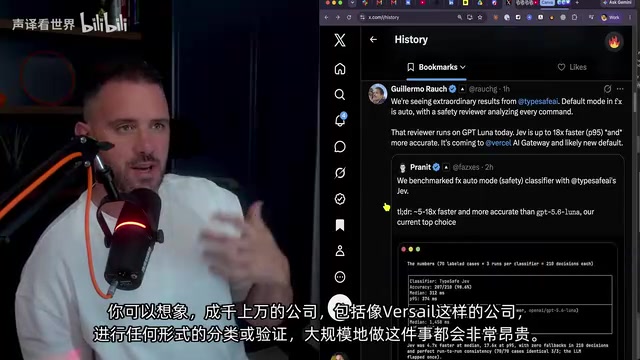
Jev最抢眼的卖点是速度和成本。视频给出的数据是:在分类、真伪判断等任务上,它仅需几毫秒响应,成本比现有可用于同类任务的模型便宜20到200倍。
这不是渐进式改进,而是量级差异。生产级公司Vercel(视频中读作Versil)此前使用Gemini 2.5 Flash Lite这类廉价模型做分类工作,换成Jev后速度快了约6倍,并且「基本饱和了评估」——意味着准确率远超预期。
对于需要大规模执行分类或验证的公司,这一点尤为关键。传统LLM是非确定性的,容易偏离轨道或产生幻觉,一旦规模上去,成本和不可靠性都会成为负担。Jev把这类高频、低复杂度的决策任务用极低成本承接下来。
Vercel是面向前端开发者的云部署平台,以Next.js的官方托管商身份广为人知,其业务涉及大量边缘计算和实时请求处理。在AI功能集成中,分类与路由任务(如判断用户请求类型、决定调用哪个下游服务)是高频且对延迟敏感的环节。Gemini 2.5 Flash Lite是Google专为低成本、高吞吐场景设计的精简模型,已属于市场上较快较便宜的选项。Vercel在此基础上仍能通过替换Jev获得6倍速度提升,侧面说明即便是「精简LLM」,其自回归生成架构在纯分类任务上仍存在结构性浪费——它为了兼容文本生成能力而付出了不必要的计算开销。
它到底怎么工作
Jev的名字与工作方式都藏着彩蛋。母公司System 1的命名源自丹尼尔·卡尼曼《思考,快与慢》中的双系统理论:系统1是快速直觉的判断,系统2是缓慢深思的推理。
我们一直在用的LLM都在努力成为「系统2」——逐字写出、慢慢推理。而Jev是彻头彻尾的「系统1」:它不生成Token,没有自回归循环。你向它发送一个状态(一段文本、一个JSON对象)和一组类型化问题,它会并行评估这些问题。
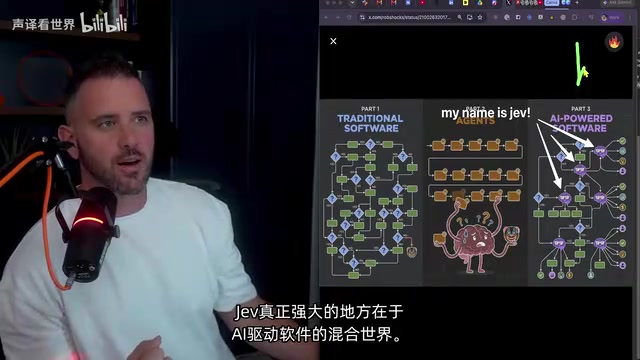
并行是它快的关键——请求不是阻塞式地一个个发,而是同时处理。提交问题时,你有三种类型可选:
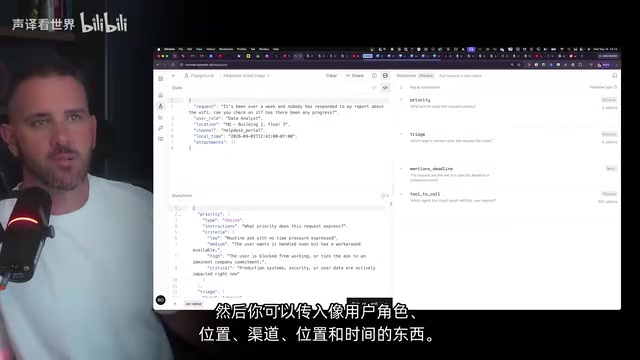
- 选择(Select):给出选项列表(如账单、技术、销售),模型基于概率选一个,并返回置信度
- 评分(Score):比如根据用户情绪打分——平静、礼貌还是愤怒
- 空值/布尔(Null/Bool):返回某事为真的概率数字
每个返回都带有置信度值,这让下游代码可以据此做进一步的确定性处理。
卡尼曼双系统理论(Dual-Process Theory)是认知心理学的重要框架:系统1(快思考)依赖直觉、自动化运作,几乎不消耗认知资源,负责瞬间的模式识别与判断;系统2(慢思考)则需要主动调用注意力,逐步推理,适合处理复杂、陌生的问题。传统自回归语言模型的生成过程在结构上与系统2高度类似——每一步都依赖前一步的输出,需要顺序完成,无法真正并行。Jev绕开了这一结构:它不产生中间Token序列,而是直接对输入状态做一次性的并行概率评估,这在计算图上更接近一个分类器或判别模型,而非生成模型。这也是为什么它在延迟和成本上能获得数量级优势,但代价是完全丧失了生成连贯语言的能力。
真正的价值:AI软件的混合架构
Jev最有说服力的定位,是填补确定性软件与非确定性智能体之间的鸿沟。
传统软件是确定性的——全是if/then/else的门控逻辑。智能体则高度灵活但非确定性,不保证每次都做对、都遵循计划。Jev的强大之处,在于它服务于「AI驱动软件的混合世界」:在确定性框架中嵌入像Jev这样的模型,来处理那些无法用纯确定性方法管理的决策点。
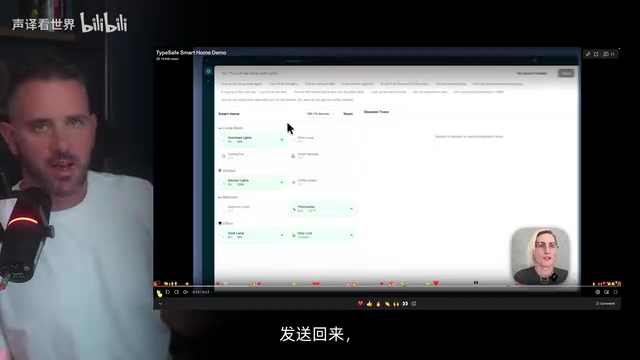
视频演示了几个典型场景:
- 模型路由器:分类一个任务,判断该用哪个模型
- 护栏替代:与其用子智能体做安全审查,不如让Jev闪电般完成
- 工具调用决策:智能体该用哪个工具、以什么置信度调用——这对MCP和CLI使用意义重大
在帮助台分单的例子里,输入一条「一周多没人回应我的WiFi报告」的工单,配合用户角色、位置、渠道等上下文,模型会返回优先级判断(中等优先级)、归属部门,以及「是否提到截止日期」这类控制问题的概率(5%为真)。
「校准决策的强化学习」(calibrated decision RL)针对的是现有LLM的一个核心缺陷:过度自信(overconfidence)。通用大模型经过RLHF(基于人类反馈的强化学习)训练后,倾向于给出听起来流畅、确定的答案,即便内部不确定性很高,置信度输出也会偏高,造成「模式崩塌」——模型在多样化输入下总是输出少数几种固定答案。TypeSafe重新设计训练目标,使模型输出的概率值与实际正确率之间保持校准(calibration),即预测70%置信度的答案,真实准确率也应接近70%。这样的校准概率对下游确定性代码意义重大——开发者可以设置阈值(如置信度低于60%则转交人工审核),让整个系统在不确定时优雅降级,而非静默犯错。
实测与应用场景
视频中展示了多个实测案例。智能家居演示里,输入「关掉所有的灯」「打开客厅的灯」「把咖啡煮上」等自然语言命令,Jev以约185毫秒的速度完成分类并返回结构化指令,灯光和设备实时响应。
更极端的例子:Jev被接入《毁灭战士》(Doom)实时运行了一个小时,调用次数惊人,总成本仅约7美元。System 1(快速直觉)实时获取游戏状态的结构化描述,模型以结构化格式反馈指令。此外还有接入《星际争霸》完成任务、OpenCode团队用它测试浏览器操作等案例。
社区应用同样活跃:YouTuber Vogel用它在几秒内对几百封邮件完成分类和优先级标记——若走常规LLM,耗时会长得多。另有「六度分隔」测试,让模型在维基页面间跳转寻找链接,TypeSafe在1.7秒内完成。
给开发者的启示
Jev没有把自己包装成全能模型,而是选择了一条极窄但极深的赛道。它可能不是最聪明的模型,但在「每个工作流的成本」这个维度上做到了极致,从而让大规模使用成为可能,并解锁全新类型的公司和工作流。
如果你正在构建AI驱动的软件,值得问自己一个问题:系统中哪些高频决策流正在耗费大量时间和真金白银?把这些「是否」判断替换成一种更快、更便宜、结构化输入输出的方式,可能会带来意想不到的差异。
获取访问也不算难——视频作者称在等待名单上只等了几个小时就拿到了访问权限,进入后可使用playground、API密钥,也能直接装进Claude Code。随着这类「超快超便宜」的决策模型陆续出现,AI软件的架构范式或许正在被重新定义。
相关推荐
NVIDIA TensorRT Model Connect:两行命令部署开源模型
NVIDIA TensorRT Model Connect 让开源模型部署仅需两条命令,无需 ONNX 转换。支持 LLM、扩散、视频生成等多类模型,兼容 RTX 消费级 GPU,并新增双 DGX Spark 多设备推理能力。
NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
NVIDIA cuML 让 Scikit-Learn 谱聚类无需重写代码即可在 GPU 上运行,大规模数据下提速超 200 倍。本文解析其原理、接入方式及在金融期权数据中的实测表现。
谷歌DeepMind成立新机构:把AGI大辩论摆上台面
Google DeepMind成立新机构,旨在把通用人工智能(AGI)的重大问题带入公共辩论。本文分析这一举措背后的行业信号,以及从技术竞赛走向公共治理的转向意义。