Ultrafast 上线:GPT-6 Astra 推理速度提升 7 倍

OpenAI 为 GPT-6 Astra 推出 Ultrafast 推理层级,速度达标准层 7 倍,主打速度与智能兼得。
OpenAI 为 GPT-6 Astra 推出名为 Ultrafast 的新推理层级,在 API、ChatGPT Work 与 Codex 三条产品线同步上线。官方数据显示,其 token 生成速度是标准层的 7 倍以上、快速层的 4 倍以上,且强调在保留 GPT-6 Astra 完整智能的前提下实现提速,而非通过缩减模型能力换取速度。官方以赛车游戏实时生成精灵图为例,展示了低延迟推理在游戏、实时内容创作等场景的实用价值。文章同时指出,定价策略、全场景加速一致性及"智能无损"的独立基准验证尚未公开,建议将当前演示理解为能力展示而非最终承诺。
OpenAI 为 GPT-6 Astra 推出了名为 Ultrafast 的全新推理层级,正式在 API、ChatGPT Work 以及 Codex 中开放使用。这一更新的核心卖点只有一个字——快,但它试图解决的却是大模型应用长期以来的一个核心矛盾:速度与智能之间的取舍。
Ultrafast 到底有多快
根据官方演示,在 API 场景下,Ultrafast 的 token 生成速度是 Standard Tier(标准层级)的 7 倍以上,是 Fast Tier(快速层级)的 4 倍以上。这意味着开发者在调用同一模型时,可以根据延迟需求选择不同的推理层级,而 Ultrafast 处于这条速度梯队的顶端。
对于依赖流式输出、实时交互或高并发请求的应用来说,7 倍的吞吐提升不只是数字上的改善,而是可能改变产品形态的关键变量。过去许多场景因为响应延迟被迫做妥协——要么牺牲模型能力换取速度,要么忍受较慢的生成体验以保留智能。Ultrafast 想做的,就是打破这种非此即彼的选择。
大模型推理性能通常用两个指标衡量:**TTFT(Time To First Token,首 token 延迟)**和 TPS(Tokens Per Second,每秒生成 token 数)。TTFT 决定用户感知到的"响应快不快",TPS 决定长文本生成的总耗时。官方宣传的"7 倍以上"加速主要指向 TPS,也就是生成阶段的吞吐提升,而非必然意味着 TTFT 同等幅度降低。对实时交互场景而言,两个指标同样重要:如果首 token 延迟较高,即便后续生成飞快,用户仍会感受到明显的"等待感"。开发者在评估 Ultrafast 是否适合自己的应用时,需要区分这两个维度,而不仅仅依据总吞吐倍数做决策。
实时生成的演示:一边跑一边出图
官方用一个赛车游戏的案例来展示 Ultrafast 的价值:开发者希望在游戏运行过程中动态生成精灵图(sprites),比如"生成一只骑自行车的鹈鹕"这样的即兴需求。
演示中最能说明问题的一幕是:在常规生成任务还在后台运行时,使用 Ultrafast 的那一路请求已经"抢先冲过终点线"完成了输出。这种"边跑边出"的能力,正是低延迟推理在实际工程中的直观体现——生成内容不再是需要等待的阻塞步骤,而是可以嵌入实时循环的一环。
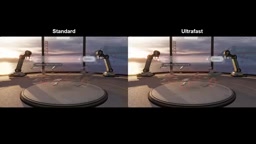
对游戏开发、实时内容创作、交互式应用等对延迟极度敏感的场景,这种即时生成能力有明显的想象空间。开发者可以把模型调用放进游戏主循环、用户交互流程或需要快速反馈的管线中,而不必担心生成过程拖慢整体体验。
速度与智能不再是单选题
Ultrafast 的定位很清晰:它不是一个更小、更笨但更快的模型,而是同一个 GPT-6 Astra 在推理层面的加速方案。官方明确指出,过去开发者往往需要在速度和智能之间做权衡,而现在"两者可以兼得"。
这一点如果成立,意义不小。传统上,加速大模型的常见手段包括使用蒸馏后的小模型、降低精度或裁剪上下文,这些方法几乎都会以能力下降为代价。而 Ultrafast 强调在保持 GPT-6 Astra 完整智能的前提下大幅提升速度,说明其背后更可能是推理架构、硬件调度或服务层优化的成果,而非模型能力的缩水。
传统大模型推理加速技术主要分为几类:模型蒸馏(用大模型训练小模型,以参数量换速度)、量化(将模型权重从 FP32 降至 INT8 甚至更低精度)、推测性解码(Speculative Decoding,用小草稿模型预测 token 序列再由大模型批量验证)以及硬件级算子融合(在 GPU/TPU 上合并计算图中的冗余操作)。前两种方法几乎必然带来模型能力的一定损失,而推测性解码和算子融合理论上可以在不改变模型权重的情况下提升吞吐。OpenAI 虽未公开 Ultrafast 的具体技术路线,但"不牺牲智能"的定位与推测性解码或服务层调度优化的特征更为吻合——这类方法本质上是让相同的模型权重"跑得更有效率",而非以能力换速度。理解这一背景,有助于评估 Ultrafast 声称"智能不打折"的技术可信度。
三大产品线同步覆盖
Ultrafast 首发即覆盖三条重要产品线:API、ChatGPT Work 和 Codex。这种同步铺开的策略表明它并非小范围实验功能,而是面向不同用户群的通用能力升级。
- API:面向开发者,速度层级的选择直接影响应用架构与成本结构。
- ChatGPT Work:面向企业协作场景,更快的响应能提升日常办公与知识处理的效率。
- Codex:面向代码生成,低延迟对编程助手的交互体验尤为关键,等待时间越短,开发心流越顺畅。
值得关注的问题
提一嘴,目前公开信息主要聚焦于速度指标和演示效果,仍有几个关键问题未被明确说明:Ultrafast 的定价相比其他层级如何?7 倍加速是否在所有任务类型和上下文长度下都能保持?以及"智能不打折"这一说法是否有独立的基准测试佐证。
对于打算把 Ultrafast 引入生产环境的团队而言,速度只是决策因素之一,成本、稳定性与实际质量表现同样需要在真实负载下验证。在这些数据补齐之前,官方演示更适合被理解为能力展示,而非最终的性能承诺。
即便如此,Ultrafast 传递出的方向仍然值得肯定:让顶级模型的响应速度追上其智能水平,正在成为大模型服务竞争的下一个焦点。
相关推荐

MCP协议入门:从概念到天气服务实战开发全解析
本文系统讲解MCP(模型上下文协议)的核心概念、三层架构与两种通信机制,并手把手演示用Python和UV开发天气查询MCP Server、在Claude Desktop中配置调用,以及用MCP Client编码方式连接的完整实战流程。

大模型RAG企业实战:从零搭建问答系统架构
大模型RAG企业项目实战课第一周详解:基于FastAPI构建RESTful API,统一调度本地开源模型与在线API,用PyCharm远程连接Linux服务器完成部署,并用Postman验证前后端问答链路,还原企业级大模型系统的真实开发流程。
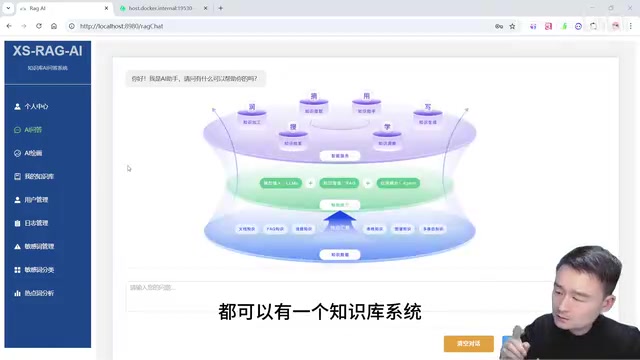
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。