Unsloth教程:本地微调大模型省显存加速训练指南
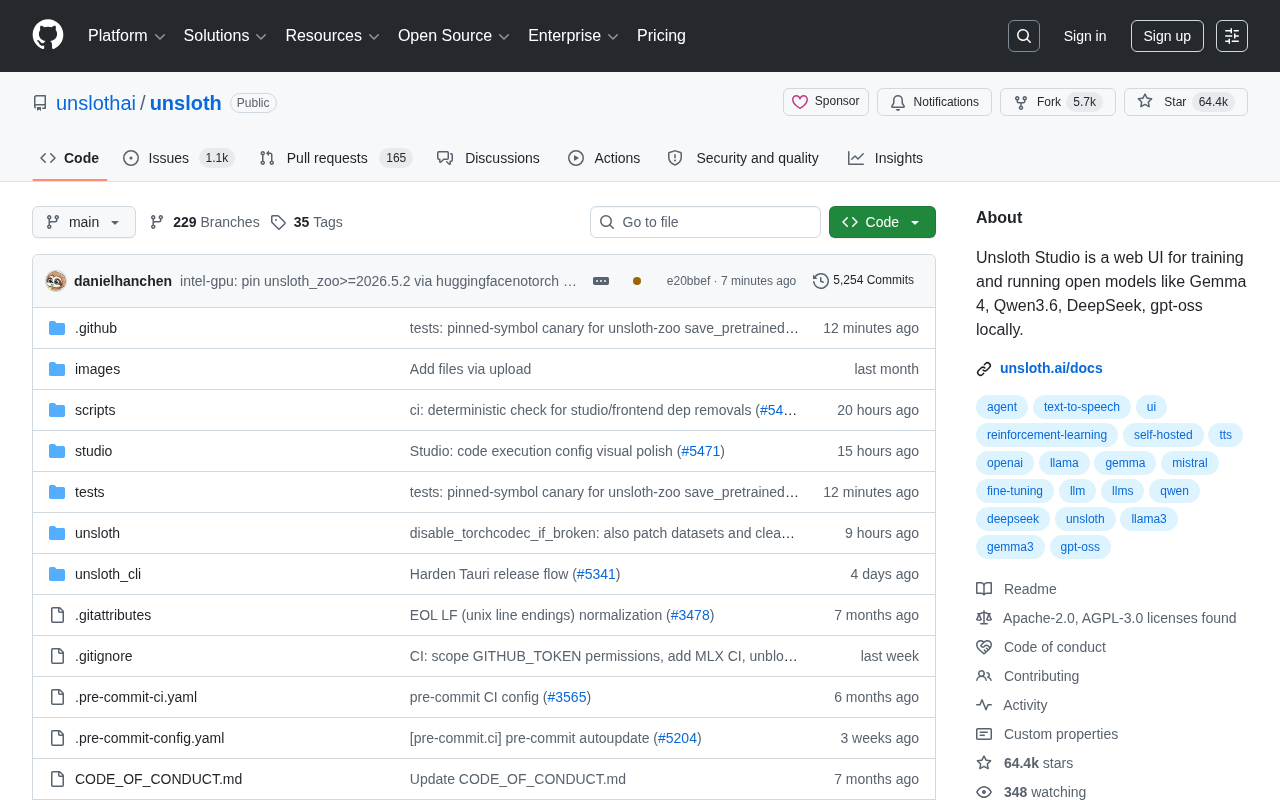
Unsloth是一款高效的开源本地大模型微调工具,大幅降低硬件和使用门槛。
Unsloth是GitHub上超过63,500 Star的开源大模型微调框架,支持Gemma 4、Qwen3、DeepSeek等主流模型。它通过手写Triton内核深度优化LoRA/QLoRA训练,实现2-5倍加速和50%显存节省,使消费级24GB显卡即可微调7B-13B模型。配合直观的Web UI界面,让个人开发者也能在本地高效完成大模型微调,同时保障数据安全。
Unsloth 是什么
Unsloth 是一款专注于本地大模型微调的开源工具,在 GitHub 上已斩获超过 63,500 颗星标,Fork 数达 5,575,是目前社区热度最高的大模型训练框架之一。
项目基于 Python 开发,提供了完整的 Web UI 界面,支持 Gemma 4、Qwen3、DeepSeek广告、gpt-oss 等主流开源模型的本地训练与推理。无论你是想用 LoRA 微调一个聊天机器人,还是为特定业务场景定制模型,Unsloth 都能帮你在消费级显卡上完成这些工作。
核心特性与支持模型
支持的主流模型
Unsloth 紧跟开源大模型的更新节奏,目前已兼容多个热门模型系列:
- Gemma 4:Google DeepMind 于 2025 年发布的开源模型系列,基于与 Gemini 相同的技术架构。其多模态能力意味着模型不仅能处理文本,还能理解图像、视频等多种输入形式。Gemma 4 采用了混合专家(MoE)架构,总参数量虽大但每次推理只激活部分参数,兼顾了模型能力和推理效率。对于本地微调场景,多模态模型的训练复杂度更高,需要处理不同模态的编码器对齐和跨模态注意力机制,Unsloth 对此提供了开箱即用的支持。
- Qwen3:阿里通义千问广告系列第三代大语言模型,提供从 0.6B 到 235B 的多种规格,中文任务表现优异。其优势源于训练数据中包含了大量高质量中文语料,以及针对中文分词特点优化的 tokenizer 设计。Qwen3 还引入了混合思维模式(Hybrid Thinking),模型可以在快速响应和深度推理之间动态切换,这对于需要复杂逻辑推理的中文应用场景尤为重要。在本地微调时,Qwen3 的 7B 版本是性价比最高的起点,它在多数中文基准测试中的表现已接近早期的 70B 级别模型。
- DeepSeek:深度求索的高性能推理模型
- gpt-oss:开源社区的 GPT 替代方案
在同一个平台上切换不同模型架构,快速对比效果,这在实际项目选型中非常实用。
Web UI 降低使用门槛
Unsloth 的图形化界面让模型训练不再是命令行专属。通过 Web UI,你可以直接完成:
- 模型选择与下载
- 训练数据集上传和格式配置
- LoRA rank、学习率等超参数调整
- 训练过程实时监控
Web UI 背后封装了完整的训练编排逻辑。当用户在界面上配置好参数并启动训练时,系统会自动完成:模型权重的量化加载、LoRA 适配器的初始化与注入、数据集的 tokenization 和动态 padding、梯度累积策略的设置、以及训练过程中的 checkpoint 保存。这种设计借鉴了 MLOps 平台的理念,将原本需要数百行代码才能完成的训练流水线,抽象为可视化的配置项,同时保留了高级用户通过 Python API 进行深度定制的能力。
对于不想折腾 Python 脚本的研究人员和 AI 应用开发者来说,这个设计省去了大量配置时间。
本地部署保障数据安全
与调用云端 API 不同,Unsloth 的所有计算都在本地完成:
- 数据不出本机:训练数据无需上传第三方服务器,医疗、金融等敏感场景可放心使用
- 长期成本更低:一张消费级 GPU 即可开始微调,省去持续的云端算力开支
- 完全可控:训练流程、模型权重、推理部署全部掌握在自己手中
技术优势:为什么选择 Unsloth
LoRA/QLoRA 底层优化
Unsloth 能获得如此高的社区关注,关键在于它对训练效率做了深度优化。要理解这一点,需要先了解 LoRA 和 QLoRA 的技术背景。
LoRA(Low-Rank Adaptation) 是微软研究院在 2021 年提出的参数高效微调方法。其核心思想是:大模型的权重矩阵在微调过程中的变化量具有低秩特性,因此可以将权重更新分解为两个小矩阵的乘积,而非更新整个权重矩阵。这样做的好处是,一个 7B 参数的模型,实际需要训练的参数量可能只有原来的 0.1%-1%,极大降低了显存需求和计算开销。
QLoRA 则是在 LoRA 基础上的进一步优化,由华盛顿大学团队在 2023 年提出,它将基础模型权重量化为 4-bit 精度存储,同时在 LoRA 适配器部分保持较高精度进行训练,从而在几乎不损失模型质量的前提下,将显存占用再降低约 50%。
Unsloth 项目团队在此基础上重写了 LoRA 和 QLoRA 的核心计算逻辑,实际效果包括:
- 显存占用相比 Hugging Face 原生实现减少约 50%
- 训练速度提升 2-5 倍(视模型和硬件配置而定)
- 支持更长的上下文窗口训练
这些性能提升很大程度上来自于使用 OpenAI 的 Triton 语言手写 GPU 内核。Triton 是一种介于 CUDA 和 PyTorch 之间的中间层编程语言,它允许开发者以接近 Python 的语法编写高性能 GPU 代码,同时由编译器自动处理内存合并、线程调度等底层优化。Unsloth 团队针对 Transformer 中的注意力计算、RoPE 位置编码、交叉熵损失等关键算子编写了定制的 Triton 内核,避免了 PyTorch 默认实现中的冗余内存分配和不必要的数据搬运,这是其能实现 2-5 倍加速的核心技术基础。
消费级 GPU 微调的可行性
传统的大模型全参数微调需要的显存大约是模型参数量的 4-8 倍(考虑梯度、优化器状态等),一个 7B 模型全量微调可能需要 56-112GB 显存,远超消费级显卡的容量。而 LoRA + 4-bit 量化的组合将显存需求压缩到模型参数量的 1-2 倍左右,使得 24GB 显存的 RTX 3090/4090 就能处理 7B-13B 规模的模型。Unsloth 在此基础上进一步优化了内存分配和计算图,通过手写 Triton 内核替代 PyTorch 的自动微分,减少了中间激活值的存储开销。
这意味着一张 RTX 3090(24GB 显存)就能微调 7B 甚至 13B 参数的模型,大幅降低了硬件门槛。
活跃的开源社区
63,000+ Star 和 5,500+ Fork 背后是一个持续贡献的开发者社区:
- 新模型发布后通常几天内就能获得支持
- GitHub Issues 响应速度快,Bug 修复及时
- 社区贡献了大量微调教程、Notebook 示例和最佳实践
适用场景与实践建议
Unsloth 在以下场景中表现尤为突出:
- 个人开发者:用一张消费级 GPU 微调大模型,构建个性化 AI 助手或垂直领域应用
- 学术研究:快速实验不同模型架构和训练策略,对比 LoRA rank、数据配比等变量的影响
- 中小企业:在有限预算内训练领域专用模型,比如客服问答、文档摘要、代码生成等
- 隐私合规场景:医疗病历分析、金融风控建模等对数据安全有严格要求的项目
入门建议:如果你刚接触大模型微调,可以从 Qwen3 的 7B 版本 + LoRA 开始,配合 Unsloth 的 Web UI 走通完整流程,再逐步尝试更大的模型和更复杂的训练配置。建议初始 LoRA rank 设为 16-32,学习率设为 2e-4,使用 cosine 学习率调度器,训练 3-5 个 epoch 后观察验证集损失的收敛情况。
总结
Unsloth 解决了一个实际痛点:让普通开发者也能在本地高效微调大模型。通过底层的显存优化和直观的 Web UI,它把原本需要专业 MLOps 团队才能完成的工作,变成了个人开发者也能上手的事情。
随着 Gemma 4、Qwen3、DeepSeek 等新一代开源模型持续迭代,本地微调的需求只会越来越大。如果你正在寻找一款省显存、易上手、社区活跃的大模型训练工具,Unsloth 值得作为首选方案来尝试。
核心要点
- Unsloth 是一个 GitHub 上超过 63,500 Star 的开源项目,提供本地训练和运行大模型的 Web UI 界面
- 支持 Gemma 4、Qwen3、DeepSeek、gpt-oss 等主流开源模型的本地训练与推理
- 通过图形化 Web 界面降低模型训练门槛,无需编写复杂训练脚本
- 强调本地化部署,保障数据隐私的同时降低计算成本
- 针对 LoRA/QLoRA 等微调方法进行了底层优化,使用 Triton 手写内核实现 2-5 倍训练加速
- 消费级 24GB 显存 GPU 即可微调 7B-13B 参数模型,大幅降低硬件门槛
相关推荐
 教程攻略
ChatGPT Plus订阅指南:GPT-5.5、image-2与Codex值得升级吗
详解ChatGPT Plus核心功能GPT-5.5、image-2图像生成和Codex编程助手的实际体验,对比Plus与Pro方案差异,并提供国内用户安全订阅的完整操作流程与避坑建议。
 教程攻略
Cursor+Codex双IDE协同:开源项目二开实战方法论
基于实战经验总结的开源项目二次开发完整方法论,详解Cursor+Codex双IDE协同工作流,涵盖二开七环节、MVP验证、AI读源码技巧,帮助开发者三天跑通项目、两周完成业务集成。
 教程攻略
Cursor多Agent实战:50分钟搭建Next.js全栈博客
使用Cursor IDE多Agent协作模式,50分钟内从零搭建全栈博客。涵盖Next.js、Clerk认证、Supabase数据库集成,详解4个AI Agent分阶段开发流程与关键避坑经验。