Unsloth 本地运行 Nemotron 3.5 与 Meta Muse Spark Open 全解析

Unsloth 新版让 Nemotron 3.5、Meta 816B MoE 与文本扩散模型在本地可训练、可运行。
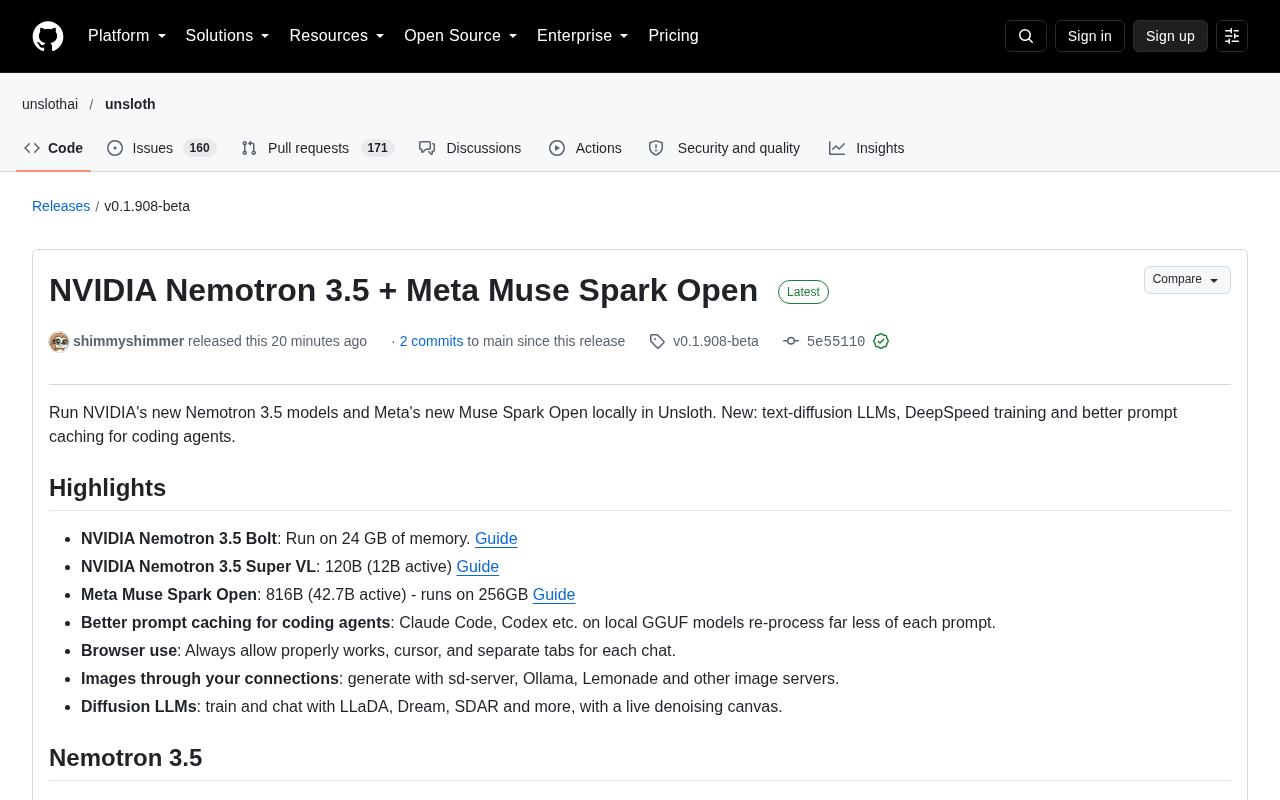
开源微调工具 Unsloth 发布 v0.1.908-beta,围绕「本地能跑什么、能训什么」推进了三件事。Model 侧引入 NVIDIA Nemotron 3.5 双变体(Super VL 120B/1M 上下文、Bolt 74B/32GB 可跑)与 Meta 816B MoE 模型 Muse Spark Open,显著拉低了多模态大模型的本地门槛。训练侧首次支持 LLaDA、Dream、SDAR 等文本扩散语言模型,并新增 DeepSpeed ZeRO-2/3、DPO 与 CPU offload 能力。工程侧优化了编码 agent 的提示缓存与本地推理速度,新 Claude Code 会话首条回复最高快 4 倍,并补上老显卡与混代际多 GPU 的 Vulkan 回退兼容。
开源微调工具 Unsloth 发布 v0.1.908-beta,一次性把三件事推到台前:NVIDIA Nemotron 3.5 系列本地可跑、Meta 最新的 816B 多模态 MoE 模型 Muse Spark Open 开放下载、以及文本扩散语言模型(text-diffusion LLM)的正式训练与对话支持。对长期受限于显存和算力的开发者来说,这次更新真正改变的是「能在自己机器上跑什么」这件事。
Nemotron 3.5:从 1M 上下文到消费级显存
此次发布包含两个 Nemotron 3.5 变体,定位差异清晰。
Super VL 是完整版本:120B 参数(激活 12B),支持最高 100 万 token 上下文,面向文档理解、computer use 和 agent 场景。Unsloth 给出的显存参考是 1-bit 量化下约 64GB,4-bit 下约 128GB。
Bolt 是从 Super VL 压缩而来的轻量版本:74B 参数(激活 9B),128K 上下文,1-bit 或 2-bit 下约 32GB 内存即可运行。这意味着一台配备 24GB 至 32GB 显存的机器,能直接承载一个具备多模态能力的大模型。
性能上,官方称 Super VL 在 100K 输入长度下,生成速度约为 Inkling Small 的 5 倍,且智能水平相近。提速的一部分来自 Unsloth 默认启用的加速机制:Bolt 使用 DSpark drafter(额外占用 1–2GB),Super VL 使用内置的 MTP(Multi-Token Prediction),两者均可在设置中关闭。
对比维度上,压缩模型的取舍值得关注——Bolt 保留了 128K 上下文,但相比 Super VL 的 1M 有明显缩水,适合对话和中等长度代码任务,长文档场景仍建议上 Super VL。
MoE(Mixture of Experts,混合专家) 是理解本次几款模型参数量与显存关系的核心概念。传统稠密模型每次推理都会激活全部参数,而 MoE 把前馈层拆成多个「专家」,每个 token 只路由到其中少数几个,因此「总参数量」和「激活参数量」是两个不同的数字。Nemotron 3.5 Bolt 标注为 74B 总参数、9B 激活,意味着显存要装下全部权重,但每个 token 的实际计算量只相当于 9B 稠密模型——这正是它在 32GB 内存下仍能保持较高吞吐的原因。
由此也可理解文中反复出现的量化口径:1-bit、2-bit、4-bit 指权重被压缩到每个参数 1/2/4 个比特,数值越低显存占用越小,但精度损失越大。1-bit 下 120B 模型约 64GB,正是 120B × 1 bit ÷ 8 的粗略估算结果,实际还会因嵌入层、KV cache 和运行时开销略有浮动。
Meta Muse Spark Open:816B 参数跑到 256GB
Meta 这次放出的 Muse Spark Open 是一个 816B 参数的 MoE 模型,激活参数约 42.7B,支持 100 万上下文,2-bit 量化下约需 256GB 内存。
它的输入模态覆盖文本、图像、视频和音频,推理努力程度(reasoning effort)可在 low 到 xhigh 之间调节——这个设计让同一个模型既能处理快速响应的日常任务,也能切换到高推理预算的复杂场景。
训练数据方面,官方说明其覆盖整仓库级代码生成、端到端项目构建和自动化研究任务。定位上,这是一个面向多模态推理、编程和 agent 工作流的模型,而不是单纯的对话模型。
256GB 的部署门槛显然不是消费级硬件能承担的,但 MoE 架构下 42.7B 的激活量意味着推理时的实际计算开销远低于参数总量,在多卡服务器或高内存工作站上具备可行性。
Reasoning effort(推理努力程度) 是一种控制模型「思考预算」的推理期参数。与训练时的规模不同,它通常在推理时决定模型内部展开多少步思维链、分配多少 token 用于中间推理,从而在延迟与准确率之间滑动。Muse Spark Open 允许在 low 到 xhigh 之间调节,本质上是让同一个模型既跑轻量问答,又能切换到高预算模式处理复杂推理,无需部署两个不同尺寸的模型。
另外,文中提到的 100 万 token 上下文 在工程上最大的成本不是权重显存,而是 KV cache。上下文越长,缓存的历史键值对越多,显存占用随序列长度线性增长,这也是长上下文模型往往需要专门的分页或量化 KV cache 技术支撑的原因。
文本扩散模型进入可训练阶段
本次更新在训练侧引入了一个此前较少被主流工具链覆盖的方向:文本扩散语言模型。
Unsloth 现在支持在应用内训练和对话 LLaDA、Dream、SDAR、LLaDA2、Nemotron-Labs-Diffusion 和 DiffusionGemma 等扩散语言模型。对话回复会显示一个实时去噪画布(live denoising canvas),直观呈现扩散过程如何从噪声逐步生成文本。
训练能力上,新增 DeepSpeed ZeRO-2 和 ZeRO-3 支持,包括 4-bit QLoRA、全量微调、DPO 和 CPU offload。此前会导致崩溃的 DDP + 梯度检查点 LoRA 训练问题也已修复。GRPO 配合 fast_inference 现可在 Nemotron 3 Nano 和 block-FP8 MoE 模型上运行,并与 vLLM 共享权重。
对研究者而言,扩散语言模型代表了一条区别于自回归范式的技术路线,能在本地工具中直接训练这类模型,降低了实验门槛。
文本扩散语言模型 与主流的自回归模型在生成机制上根本不同。自回归模型从左到右逐 token 预测,每一步都依赖已生成的前缀;扩散模型则从纯噪声或随机 token 序列出发,经过多轮去噪迭代,逐步收敛到目标文本。它的优势在于可以并行迭代、天然支持全局修正式生成,但也带来了步数调度、去噪一致性等新问题。文中提到的 LLaDA、Dream、SDAR 等属于这一方向的开源代表。
与之配套的 DeepSpeed ZeRO-2/ZeRO-3 是微软 DeepSpeed 的显存优化技术:ZeRO-2 把梯度与优化器状态分片到多卡,ZeRO-3 进一步把模型参数本身也分片,从而让单卡显存不足以容纳的模型可以跨卡训练。文中的 CPU offload 则把部分状态临时卸载到内存,用速度换取显存余量,这三者叠加正是扩散模型能在本地训练的关键。
编码 agent 的提示缓存与本地推理提速
对日常使用 Claude Code、Codex、OpenCode 的开发者,这次更新有几个直接影响效率的改动。
当这些编码 agent 运行在本地 GGUF 模型上时,后续轮次需要重新处理的对话内容大幅减少,新开的 Claude Code 会话首条回复启动速度提升最高 4 倍。Python 侧,单提示 model.generate 在 32K 上下文下对 Llama 和 Qwen3 模型提速最高 2.7 倍;bitsandbytes 4-bit 模型一次生成 2 到 4 个提示时,在某些 NVIDIA GPU 上提速最高 2.8 倍。
一个实用的工程细节是 --auto-route 参数:在 cloud 模型上运行 Claude Code、OpenCode 或 Codex 时,加上它到 unsloth start,读文件、搜索、执行命令这类常规编码工作会路由到本地模型,只有真正需要强模型的任务才走云端。这是成本与能力的折中方案。
模型别名(Model aliases)功能也值得一提——在 Settings > API > Model aliases 中命名一次,底层模型更换时上层应用无需改动,对多模型切换的工作流是个省心事。
提示缓存(prompt caching) 针对的是编码 agent 场景中反复出现的公共前缀问题。Claude Code、Codex 这类工具每轮都会把系统提示、项目文件、历史对话重新塞进上下文,其中大部分内容与上一轮完全相同。缓存技术让这部分前缀的键值状态被复用,无需重新计算,因此文中「后续轮次需要重新处理的对话内容大幅减少」直接转化为首条回复最高 4 倍的启动提速。
文中提到的 --auto-route 则是一种混合推理路由策略:让本地模型承担读文件、搜索、执行命令这类高频率但低难度的操作,把真正需要强推理的请求转发到云端。它和模型别名(Model aliases)配合,能让上层 agent 在不改代码的前提下切换底层模型,是控制成本与能力平衡的实用组合。
浏览器使用与多模态生成
Browser use 功能这次补齐了可观测性和控制粒度:模型点击和输入时会显示光标,可在设置中关闭;提示支持 Always allow,对某类操作在整段对话中免确认,而脚本类操作仍需每次询问。每个对话拥有独立的浏览器标签页,桌面端即使对话不在前台,浏览器操作也会继续执行。
图像生成方面,Images 页面可通过已连接的图像服务器(sd-server、Ollama、Lemonade、vLLM、llama.cpp 或自定义 OpenAI 兼容地址)生成图片。图像和视频模型现在会跳过从未使用的文本编码器层,每次加载都能省下内存。
硬件兼容性:老显卡和混合配置的修复
这次更新在硬件适配上做了不少补丁,对非主流配置的用户尤其友好。
NVIDIA 驱动早于 CUDA 12 的 Windows PC 不再直接失败,而是安装 Vulkan 或 CPU 版 llama.cpp。ROCm 不支持的 AMD GPU(如 RDNA 1 和 Polaris)即使系统装了 ROCm 或另一块 AMD GPU 支持 ROCm,也能拿到 Vulkan 版 llama.cpp。PyTorch 为 CPU-only 时,GGUF 图像生成可在 AMD 和 Intel Arc GPU 上通过 Vulkan 运行。
多 GPU 混代际的机器现在会为每块 GPU 单独选择注意力后端,Hopper GPU 配合 conda-forge xformers 的崩溃问题也已解决。这些修复谈不上亮眼,但决定了工具能否在老机器上跑起来。
上线建议
如果目标是本地跑大模型,Nemotron 3.5 Bolt 是当前门槛最低的入口,32GB 内存即可起步;Super VL 适合有 64GB 以上显存、需要长上下文的场景;Muse Spark Open 则更偏向团队级的多模态 agent 部署。文本扩散模型的训练支持属于长线价值——现在能跑通,但生态和工具链还在早期。
相关推荐

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。

AI Agent工具权限失控?Citadel Identity360用MCP注册表治住
Citadel Identity360如何治理AI Agent的工具访问?通过跨平台发现Agent、绑定人类owner、建立MCP注册表可视化访问路径,并用OAuth门控和函数白名单实现工具级授权,堵住Agent权限盲区。

Claude Code额度消耗快?上下文窗口管理技巧省35%
Claude Code额度消耗过快怎么办?本文拆解上下文窗口膨胀的根源,分享按任务节点清理、关闭闲置连接器、精简CLAUDE.md等实用技巧,实测同样20项任务token消耗降低约35%,API成本从5.94美元降至3.91美元。