Unsloth 发布 CUDA 13 预编译轮子:告别源码编译烦恼

Unsloth 为 CUDA 13 发布 Flash-Attention 2、Mamba-SSM 等关键库的预编译轮子,免去繁琐的源码编译环节。
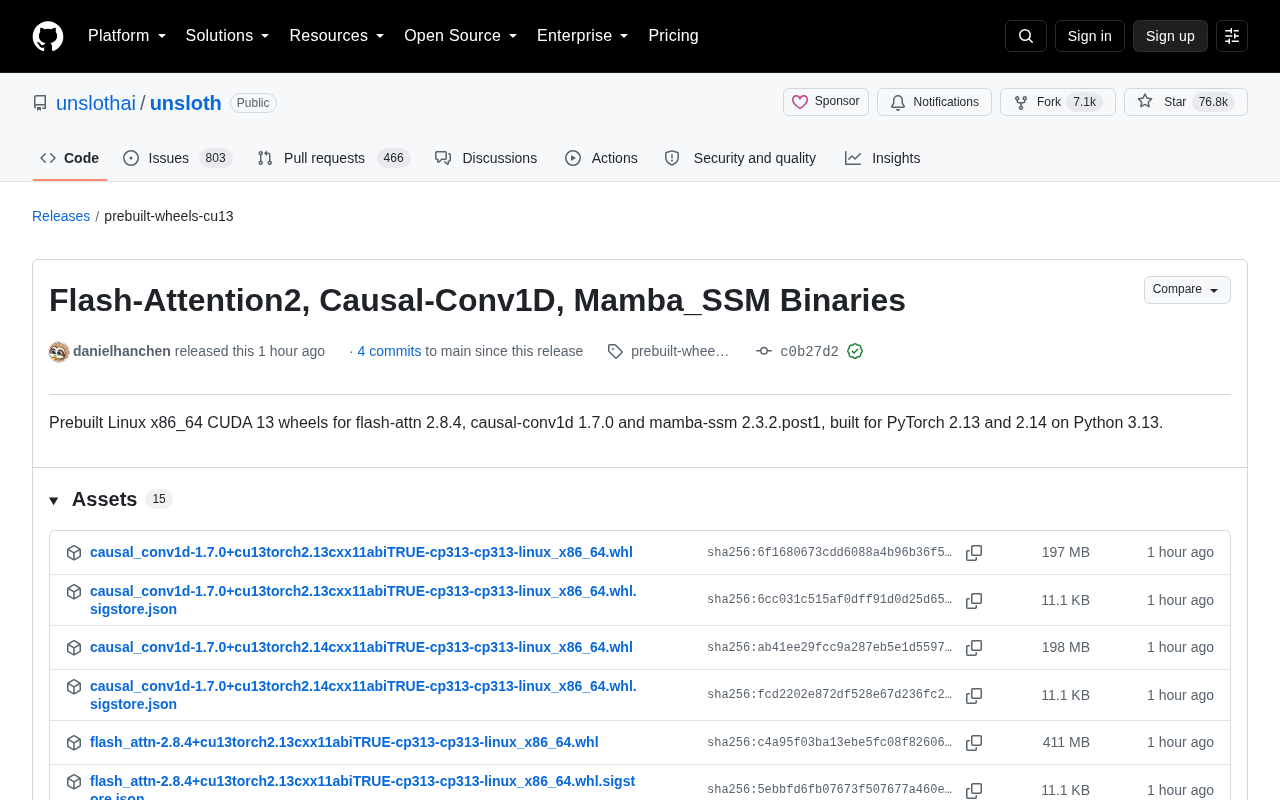
开源微调框架 Unsloth 团队为 CUDA 13 发布了一批预编译 Python 轮子,涵盖 flash-attn 2.8.4、causal-conv1d 1.7.0 和 mamba-ssm 2.3.2.post1 三个大模型训练中的核心底层组件,专为 PyTorch 2.13/2.14 与 Python 3.13 构建,仅支持 Linux x86_64 平台。这些库的源码编译历来是环境搭建的最大痛点,耗时长且因版本不兼容极易失败。预编译轮子将编译工作前置到发布方,用户直接下载安装即可使用,大幅降低时间成本和踩坑风险。此次发布也体现了 Unsloth 率先跟进前沿技术栈的一贯策略——在官方产物尚未就绪时主动为早期采用者填补生态空缺,是其"以工程基础设施降低社区门槛"定位的典型体现。
开源微调框架 Unsloth 团队近日发布了一组针对 CUDA 13 的预编译 Python 轮子(prebuilt wheels),覆盖 Flash-Attention 2、Causal-Conv1D 和 Mamba-SSM 三个在大模型训练中广泛使用的关键组件。对于长期被这些库源码编译折磨的开发者来说,这是一个实打实的效率提升。
发布了什么
此次发布(release tag 为 prebuilt-wheels-cu13)由 Unsloth 核心开发者 Daniel Han 亲自打包上传,内容为 Linux x86_64 平台、面向 CUDA 13 的预编译二进制轮子,具体版本如下:
- flash-attn 2.8.4:高性能注意力计算内核,几乎是当下 Transformer 训练与推理的标配。
- causal-conv1d 1.7.0:因果一维卷积算子,主要服务于状态空间模型(SSM)架构。
- mamba-ssm 2.3.2.post1:Mamba 系列状态空间模型的核心实现。
这批轮子专门为 PyTorch 2.13 和 2.14 构建,并适配 Python 3.13。整个 release 包含 15 个资产文件,覆盖不同版本组合,方便用户按需下载。
Flash-Attention 2 是由 Tri Dao 等人提出的 IO 感知精确注意力算法,通过将计算分块并减少 HBM(高带宽显存)读写次数,在保证数值精度的前提下将标准注意力的显存复杂度从 O(N²) 降低到 O(N),并在实际吞吐量上带来 2-4 倍的速度提升。Causal-Conv1D 则是因果卷积的 CUDA 高效实现,所谓"因果"指卷积核在时间步 t 时只能访问 t 及之前的输入,这对于自回归序列建模至关重要,也是 Mamba 架构的底层算子之一。Mamba-SSM 基于状态空间模型(State Space Model)理论,通过选择性扫描机制(Selective Scan)让模型在处理长序列时能以线性复杂度替代 Transformer 的二次复杂度,近年来在语言建模、音频处理等领域引发广泛关注。这三个组件共同构成了当前高效大模型训练与推理的核心底层支撑。
为什么预编译轮子这么重要
熟悉大模型训练环境搭建的人都知道,Flash-Attention 和 Mamba-SSM 这类库的安装堪称“劝退第一关”。它们依赖底层 CUDA 内核,pip install 时往往需要在本地现场编译,而编译过程动辄消耗十几分钟到数小时,且极易因为 CUDA 版本、编译器版本、PyTorch 版本三者之间的细微不匹配而报错失败。
预编译轮子的价值正在于此:它把编译这一环节前置到了发布方,用户只需下载安装对应版本的二进制文件即可直接使用,省去了本地编译的时间成本和踩坑风险。对于在云服务器或临时容器环境中反复搭建训练环境的团队而言,这种确定性和速度尤为关键。
Python 的 .whl(Wheel)格式是 PEP 427 定义的二进制分发标准,文件名中直接编码了 Python 版本、ABI 标签和平台标签(如 cp313-cp313-linux_x86_64),pip 在安装时会自动匹配当前环境,无需触发任何编译步骤。对于 CUDA 扩展而言,其文件名还隐式绑定了编译时使用的 CUDA 工具链版本,这也是为什么 CUDA 版本、PyTorch 版本、Python 版本三者必须同时对齐——任一不匹配都会导致运行时符号找不到或 ABI 不兼容报错。源码编译之所以耗时,是因为 CUDA C++ 代码需要经过 nvcc 编译器生成 PTX 中间代码再编译为 cubin 二进制,Flash-Attention 这类含有大量模板实例化的库编译产物体积往往超过数 GB,单次编译在普通 CPU 上需要数十分钟。
版本适配的信号
这次发布的一个值得关注的点,是它率先跟进了较新的技术栈组合——CUDA 13、PyTorch 2.13/2.14 以及 Python 3.13。这三者都属于相对前沿的版本,官方或原始项目往往需要一段时间才会提供对应的预编译产物。Unsloth 主动补齐这块空缺,实际上是在帮生态里的早期采用者填坑。
这也符合 Unsloth 一贯的定位。作为一个以“更快、更省显存”著称的微调框架(GitHub 上已积累超过 7.6 万 star、7100+ fork),它的用户群体本身就对训练效率和环境便利性高度敏感。提供开箱即用的依赖二进制,是降低使用门槛、提升整体体验的自然延伸。
如何使用
使用方式相对直接:前往 Unsloth 仓库对应的 release 页面,根据自己环境的 PyTorch 与 Python 版本,下载匹配的 .whl 文件,再通过 pip install 本地安装即可。需要留意的前提条件是:
- 操作系统需为 Linux x86_64(Windows 与 macOS 用户无法直接使用这批轮子);
- CUDA 驱动需支持 CUDA 13;
- PyTorch 版本需为 2.13 或 2.14,Python 为 3.13。
只有当本地环境与这些约束完全对齐时,预编译轮子才能正常工作;否则仍需回退到源码编译或选择其他版本组合。
小结
这不是一次带来新功能的“大版本更新”,但对日常做模型训练和微调的工程师而言,它解决的是一个真实且高频的痛点。在 AI 工具链快速迭代、版本碎片化日益严重的当下,谁能第一时间提供稳定可用的预编译依赖,谁就能实实在在地节省社区的时间。Unsloth 这次的动作,正是这种“基础设施型贡献”的典型体现。
相关推荐

Devin年收入逼近10亿美元:AI编程热潮背后的真实账本
Cognition旗下Devin AI编程智能体年化收入逼近10亿美元,四个月翻倍,估值达480亿美元。本文解析AI编程热潮背后的真实收入、53倍估值倍数、8亿美元现金消耗与企业客户版图。
n8n实战:从零搭建你的第一个AI Agent工作流
基于n8n in 100 days系列第14集实操,详解如何用n8n搭建第一个AI Agent:从When chat message received触发节点、AI Agent与Chat Model,到Memory记忆模块的作用与设计逻辑。

Aleph Alpha开放Kolibri 78B在线免费试用
Aleph Alpha旗下780亿参数大模型Kolibri 78B现已开放免费在线试用,用户无需部署即可通过网页体验这款欧洲本土AI模型的对话能力。