Unsloth v0.1.47-beta发布:LLM微调提速2倍、显存降低70%

Unsloth 悄然发布 v0.1.47-beta
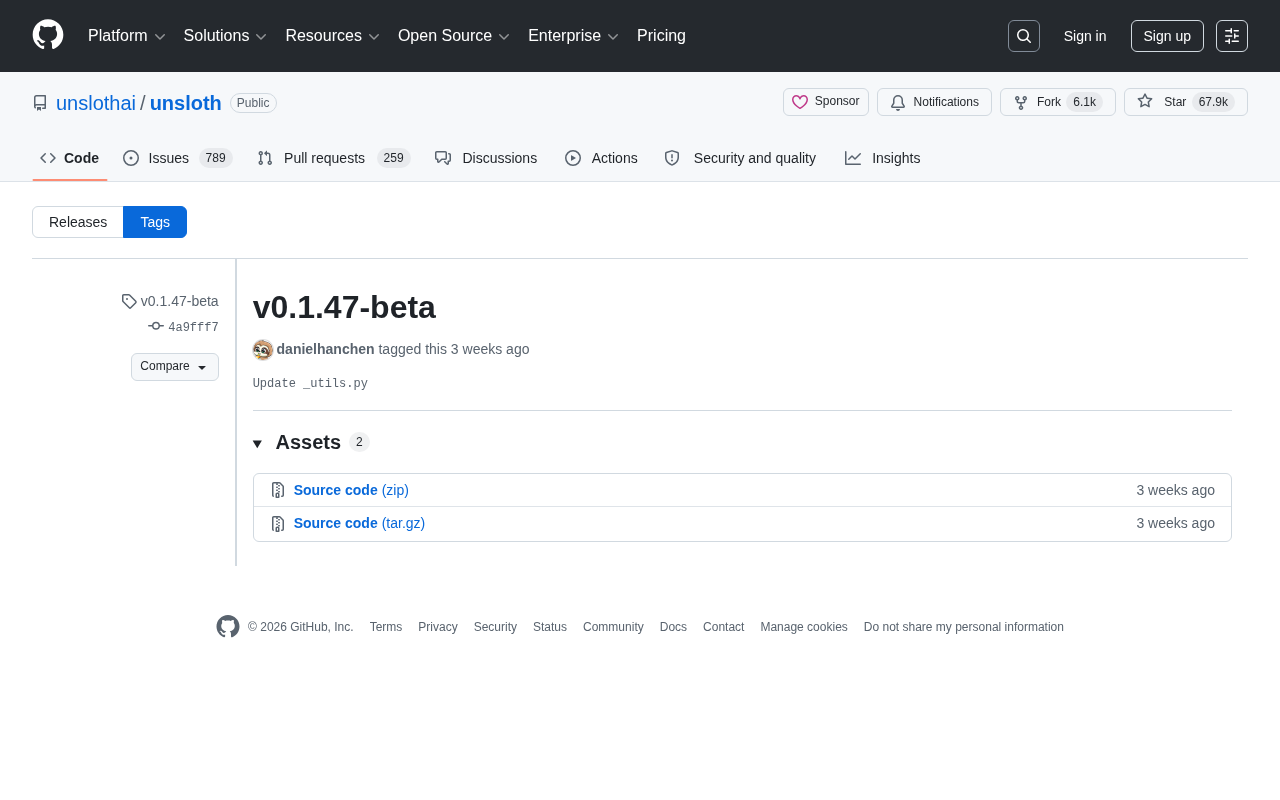
开源大模型微调框架 Unsloth 近日发布了 v0.1.47-beta 版本。作为 GitHub 上备受关注的开源项目,Unsloth 目前已累计获得 6.79 万 Star 和超过 6100 次 Fork,是当前大模型高效微调领域最活跃的开源工具之一。
本次 beta 版本由核心维护者 danielhanchen 于 6 月 18 日发布,主要更新集中在 _utils.py 工具模块,属于持续迭代中的功能优化与稳定性改进。
Unsloth 是什么?为何值得关注
Unsloth 是一款专注于加速大语言模型(LLM)微调的开源框架,其核心优势在于:在保持模型精度不变的前提下,大幅降低显存占用并提升训练速度。
根据项目官方数据,Unsloth 能够让 Llama、Mistral、Gemma、Qwen 等主流开源模型的微调速度提升 2 倍以上,同时将显存占用降低约 70%。这意味着开发者甚至可以在消费级 GPU(如单张 RTX 4090 或免费的 Colab T4)上完成过去需要多卡集群才能承载的微调任务。
Unsloth 的技术底座:手写 CUDA 内核优化
Unsloth 性能跃升的根基在于对底层 GPU 指令的深度定制。CUDA(Compute Unified Device Architecture)是 NVIDIA 推出的并行计算平台,而"手写 CUDA 内核"意味着开发者绕过 PyTorch 等高层框架的通用实现,直接用 CUDA C++ 编写针对注意力机制、矩阵乘法等特定运算高度优化的 GPU 指令。
Unsloth 的核心技术之一是对 Flash Attention 的进一步优化:通过重新设计内存访问模式,将原本需要反复读写 HBM(高带宽显存)的中间结果尽量保留在更快的 SRAM(片上缓存)中,从而突破带宽瓶颈。此外,Unsloth 采用梯度检查点(Gradient Checkpointing)与智能激活重计算策略,在前向传播时不保存全部中间激活值,而是在反向传播时按需重算,以计算换显存,实现显存使用量的大幅降低——这正是其"速度翻倍、显存减七成"的技术实现路径。
降低微调门槛的现实意义
大模型微调长期以来是一项资源密集型工作,高昂的算力成本将许多个人开发者和中小团队挡在门外。Unsloth 通过对底层 CUDA 内核、注意力机制与量化技术的深度优化,有效打破了这一壁垒,让 LoRA/QLoRA 等参数高效微调方法能够以更低的成本真正落地。
LoRA(Low-Rank Adaptation) 是微软研究院提出的参数高效微调方法,其核心思想是在不修改原始模型权重的前提下,通过注入低秩分解矩阵来近似权重更新,将可训练参数量从数十亿压缩至数百万量级。QLoRA 则在此基础上引入 4-bit NormalFloat 量化技术,将基础模型以 4 位精度存储,进一步将显存需求压缩至原来的约四分之一。以 65B 参数的 LLaMA 模型为例,传统全量微调需要 780GB 以上显存,而 QLoRA 仅需约 48GB,使单张 A100 即可完成任务。Unsloth 对这两种方法的底层实现进行了深度重写,在保持数值等价性的同时显著提升了计算效率,让消费级硬件上的微调从理论变为现实。
v0.1.47-beta 版本解读
本次发布为 beta 测试版本,核心变更集中于 _utils.py 内部工具文件的更新。虽然官方尚未提供详尽的发布说明,但结合 Unsloth 一贯的迭代节奏,此类更新通常涵盖以下方向:
兼容性与稳定性维护
_utils.py 承载着框架的通用工具函数,包括模型加载、依赖检测、环境适配等基础逻辑。对该文件的更新通常意味着修复了特定环境下的兼容性问题,或适配了新发布的模型架构与依赖库版本。
持续跟进上游生态
Unsloth 的技术栈深度依赖多个核心上游项目:PyTorch 提供基础张量计算与自动微分引擎;HuggingFace Transformers 负责模型架构定义与权重加载;PEFT(Parameter-Efficient Fine-Tuning)库提供 LoRA 等适配器的标准接口;TRL(Transformer Reinforcement Learning)支持 SFT、RLHF 等多种训练范式;vLLM 则在推理阶段提供高吞吐量服务能力。
这些库的任何版本更新都可能引入 API 变更、数据格式调整或行为差异,要求 Unsloth 及时跟进适配。特别是随着 Qwen2.5、Gemma3、Llama 3.x 等新模型架构频繁发布,模型加载与权重映射逻辑需持续更新——这正是 _utils.py 此类工具模块高频迭代的根本原因,也是 Unsloth beta 版本对于活跃用户而言始终能够跟上快速演进的开源模型生态的底层保障。
如何看待 beta 版本的使用价值
需要说明的是,beta 版本主要面向愿意尝鲜并参与测试的开发者。生产环境或对稳定性要求较高的场景,建议继续使用正式发布版本,待相关改进经充分验证后再行升级。
对于希望跟进前沿进展的研究者和开发者,beta 版本则是提前体验新特性、参与社区共建的有效途径。可通过 pip 直接安装指定版本,或从 GitHub 拉取对应 tag 进行本地测试。
小步快跑,持续进化
Unsloth v0.1.47-beta 是一次典型的小步快跑式迭代,但也正是这种持续不断的优化积累,构筑了它在开源微调工具领域的领先地位。近 6.8 万的 Star 数背后,折射出社区对高效、低成本大模型微调方案的强烈需求。
随着开源大模型生态的持续繁荣,Unsloth 这类能够切实降低技术门槛的工具,将在推动 AI 普惠化进程中发挥越来越关键的作用。建议持续关注该项目的开发者留意后续正式版本的发布动态。
核心要点
相关推荐

AI无需超级智能或恶意,也可能引发核战争
AI引发核战争的真正风险不在于超级智能或恶意,而在于误报、自动化偏见和决策时间压缩。本文分析平庸AI在核指挥系统中的隐患,以及人在回路、可解释性等应对之道。

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。