Unsloth v0.1.811发布:Docker多用户与AMD ROCm支持全解析
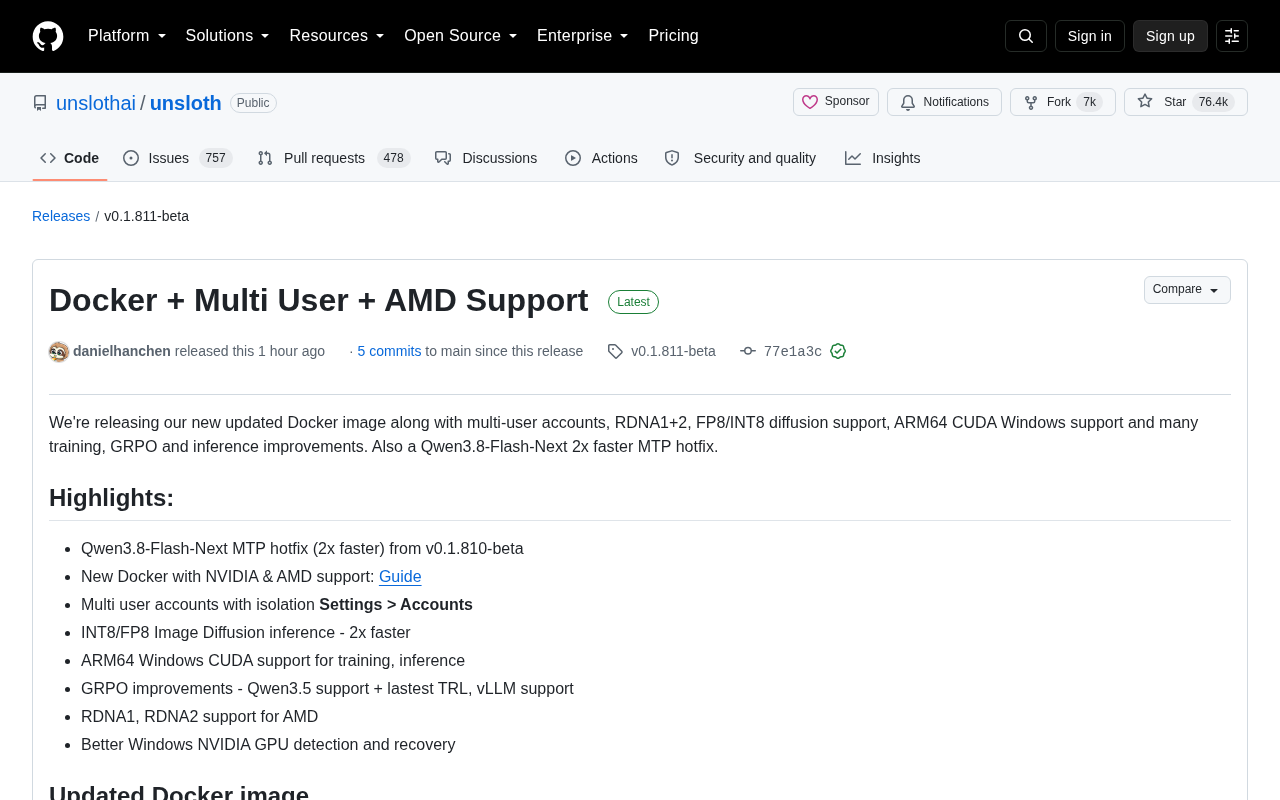
Unsloth v0.1.811 新增 AMD ROCm 支持、多用户隔离与重构 Docker 镜像,推动开源微调工具从个人走向团队生产环境。
Unsloth v0.1.811-beta 是一次覆盖部署、协作与硬件三个维度的重要版本迭代。在硬件层面,首次引入 AMD ROCm Docker 镜像,为 RDNA1/RDNA2 架构显卡用户提供官方微调支持,打破了本地大模型微调长期被 NVIDIA CUDA 垄断的格局。Docker 底层架构经过系统性重构,数据持久化解耦、体积缩减并修复了 TRL 训练补丁缺失问题。多用户账户隔离功能通过一次性设置码创建独立工作空间,同时支持跨账户共享已加载模型,兼顾隐私与显存效率,使 Unsloth 具备团队协作平台的基础能力。此外,GRPO 训练、INT8/FP8 推理提速、OS 级工具沙箱预览等改进进一步完善了训练性能与安全边界,标志着这款开源微调工具正从"个人玩具"迈向生产可用阶段。
开源大模型微调工具 Unsloth 迎来 v0.1.811-beta 版本更新,这次带来了三项重量级功能:全新的 Docker 镜像、多用户账户隔离以及对 AMD 显卡的支持。对于长期依赖 NVIDIA 生态的本地 AI 部署用户来说,这次更新在硬件兼容性和团队协作场景上都补上了重要拼图。
核心更新一览
本次版本的三大亮点分别针对部署、协作和硬件三个维度:
- 全新 Docker 镜像:同时支持 NVIDIA 与 AMD 平台,重构了 CUDA 主镜像和 Studio 配置
- 多用户账户隔离:可在
Settings > Accounts中创建独立账户,实现工作空间隔离 - AMD RDNA1/RDNA2 支持:通过新增的 ROCm 镜像,让 AMD 显卡用户也能跑起微调
此外还包含一个 Qwen3.8-Flash-Next 的 MTP 热修复,据官方说明推理速度提升约 2 倍,以及 ARM64 Windows 平台的 CUDA 训练与推理支持。
Docker 镜像的深度重构
新版 Docker 并非简单的功能叠加,而是对底层架构做了系统性优化。官方更新了主 CUDA 镜像和 Studio 安装流程,移除了打包时捆绑的缓存以减小体积,同时恢复了 Unsloth 在 GPU 主机上的训练补丁(training patches)——这一点尤其关键,因为此前版本在 Docker 环境下曾出现过 TRL 补丁被禁用的问题,导致训练性能无法完全发挥。
数据持久化方面也做了改进:Studio 的数据现在保存在独立的 volume 上,不再与应用代码强绑定。这意味着容器更新时用户数据不会丢失,同时自动生成的密码、可配置端口和依赖包保留机制都得到了完善。对于需要频繁更新镜像的生产环境,这种解耦设计能显著降低运维成本。
最值得关注的是首次引入的 AMD ROCm 镜像,与 CUDA 镜像并列提供给受支持的 Linux 主机。这打破了本地大模型微调长期被 NVIDIA CUDA 垄断的局面,RDNA1 与 RDNA2 架构的 AMD 显卡用户终于有了官方支持的路径。
ROCm(Radeon Open Compute)是 AMD 针对 GPU 通用计算推出的开源软件平台,相当于 AMD 阵营的 CUDA 替代方案。它提供了一套完整的运行时、编译器和数学库,使深度学习框架(如 PyTorch)能够调度 AMD GPU 执行张量运算。RDNA1 与 RDNA2 是 AMD 自 2019 年起推出的消费级 GPU 架构,覆盖 RX 5000 和 RX 6000 系列显卡。此前 ROCm 对消费级显卡的官方支持长期滞后且不稳定,用户往往需要手动打补丁绕过设备检测,大量配置工作让普通用户望而却步。Unsloth 官方提供预配置的 ROCm Docker 镜像,意味着复杂的驱动版本匹配与环境搭建被封装在镜像内部,用户只需拉取镜像即可获得经过验证的可用环境,显著降低了 AMD 显卡用户进入本地大模型微调领域的门槛。
多用户账户:从个人工具到团队平台
多用户功能是这次更新在使用场景上的一次重要扩展。此前 Unsloth Studio 本质上是单用户工具,而新版允许通过一次性设置码(one-time setup codes)创建多个账户,每个账户拥有独立密码。
设计上有一个巧妙的平衡:各账户的工作内容保持隔离,但当设置匹配时,多个账户可以共享已加载的模型。这在多人共用一台 GPU 服务器的场景下非常实用——既保证了数据隐私,又避免了重复加载模型造成的显存浪费。官方也强调,原有的单账户行为保持不变,老用户升级后无需改变使用习惯。
训练、推理与研究能力的全面强化
除了三大亮点,本次更新在多个技术细节上都有打磨:
GRPO 训练新增了对 Qwen3.5 的支持,并跟进了最新的 TRL 和 vLLM。图像扩散推理引入 INT8/FP8 支持,速度提升约 2 倍。MLX 平台获得了视频输入能力、可选的 MoE 与解码优化,以及更可靠的多模态对话表现。
硬件检测方面改进颇多:更好的 Windows NVIDIA GPU 检测与恢复、GGUF 显存估算优化、DGX Spark 处理、NVLink 检查,以及用户自定义 GPU 排序。这些看似琐碎的修复,实际上直接影响本地部署时的稳定性和资源利用率。
Deep Research 功能对未完成报告的保留、JSON 输出处理更加健壮,扫描版 PDF 上传新增了本地 OCR 回退方案。API 层面则增加了 /v1/chat/completions 的视频输入支持,以及通过 API 访问已安装 Ollama 模型的能力。
GRPO(Group Relative Policy Optimization)是近期在大模型后训练领域受到广泛关注的强化学习算法,由 DeepSeek广告 团队在 DeepSeek-R1 相关工作中提出并推广。与传统 RLHF 中需要独立 Critic 模型的 PPO 算法不同,GRPO 通过对同一问题采样多个输出并计算组内相对奖励来估计基线,省去了 Critic 网络,大幅降低显存占用与训练复杂度。这使得在消费级单卡上进行强化学习微调成为可能。INT8 和 FP8 量化是将模型权重或激活值从标准 FP16/BF16 精度压缩到更低比特表示的技术:INT8 将浮点数映射为 8 位整数,FP8 则保留浮点格式但缩减指数与尾数位宽。两者均能在几乎不损失输出质量的前提下,将推理吞吐量提升一倍以上,同时减少约一半的显存占用,对图像扩散模型这类计算密集型任务尤为关键。
安全性:迈向沙箱化工具执行
随着 AI 工具调用(tool calling)能力日益强大,安全边界成为不可回避的话题。本次更新强化了凭证保护和工具调用验证,当工具试图访问沙箱之外的文件时会触发审批请求。
更值得关注的是新增的操作系统级工具沙箱预览功能,目前在受支持的 Linux 和 macOS 主机上可用。官方也坦诚说明了当前限制:网络访问仍不受限制,且在 OS 隔离不可用时,自动模式会保留现有的安全防护措施。这种循序渐进、如实告知边界的做法,比宣称"完全安全"更值得信任。
工具调用(Tool Calling / Function Calling)是指大语言模型在推理过程中识别出需要外部能力时,生成结构化的函数调用指令,由宿主程序执行后将结果返回给模型继续推理的机制。随着 AI Agent 场景普及,模型可能被授权执行文件读写、代码运行、网络请求等操作,一旦模型被恶意提示(Prompt Injection)或自身产生错误决策,就可能对宿主系统造成破坏。操作系统级沙箱通过 Linux 上的 seccomp/namespaces 或 macOS 上的 Sandbox 框架限制进程的系统调用权限与文件访问范围,使工具进程无法触及沙箱边界之外的资源。Unsloth 当前实现仍保留网络访问,说明其沙箱策略优先覆盖文件系统隔离这一最常见的风险面,网络层隔离因涉及更复杂的代理与白名单机制而留待后续迭代,这与业界主流 Agent 安全框架的演进路径一致。
写在最后
从更新日志的密集程度看,v0.1.811 是一次涵盖 Docker、多用户、AMD 支持、训练优化、安全沙箱的大版本迭代。对开发者而言,AMD ROCm 支持降低了本地微调的硬件门槛,多用户隔离则让 Unsloth 具备了向团队协作平台演进的基础。这两项能力叠加,标志着这款开源微调工具正在从"个人玩具"走向"生产可用"。
相关推荐
Qwen Image 2.1 实测:7B 模型的图像生成能力如何?
Reddit 用户抢先体验 Qwen Image 2.1,实测生成 200+ 人物图像。本文解析这款 7B 参数图像生成模型的画质表现、噪点问题以及图像编辑与参考图能力。
Meta Muse评测:强大却令人不安的AI助手
Meta的AI助手Muse功能强大却令人不安。其Mac应用可访问信息、日历和备忘录引发隐私担忧,而它无法描述自身的局限更揭示了当前AI的深层问题。本文解析Muse评测背后的信任与边界议题。
Deodand:中世纪英格兰为致死之物定价的古老法律
Deodand 是英格兰普通法中一项为致死之物定价并没收的古老制度。本文解析其法律逻辑、从宗教赎罪到财政工具的演变,及其对当今自动驾驶与 AI 责任归属讨论的启示。