Unsloth动态量化3.1实测:准确率提升15%,M5 Max跑出117 tok/s

Unsloth动态量化3.1实测:同等压缩率准确率提升15%,MTP带来1.3至1.7倍加速。
本文基于B站UP主在Apple M5 Max、Strata推理引擎上的实测,评估Unsloth动态量化3.1版本的实际表现。测试对比了4位量化的Unsloth UDQ4-KXL模型(约111GB)与3位量化的GSQ-RCO模型(不到70GB)。结果显示,Unsloth模型平均生成速度70至80 tok/s、峰值可达117 tok/s,与3位GGUF版本接近;在.NET 8到.NET 10的代码迁移任务中,Unsloth仅用3分钟、69次工具调用和约8.6万Token,显著少于对照模型的82次调用与130万Token;SVG图像生成质量明显优于3位量化,与5位量化相比质量稍好而速度更快。Strata引擎支持权重从RAM转移到SSD,使64GB内存设备也能运行大模型,加之MTP多令牌预测的支持,本地部署的质量、速度与资源效率得到同步改善。
量化技术的新突破:Unsloth动态量化3.1
在本地大语言模型领域,量化一直是平衡模型质量与硬件开销的关键手段。最近,Unsloth发布了QN3.8 Flash Next模型的动态量化3.1版本,声称在保持与其他领先量化器相同压缩率的前提下,将准确率提升了15%,并在Terminal Bench、DEEP、SWE等基准测试中取得了最高分。据B站UP主的实测视频,这一版本还新增了对MTP(多令牌预测)的支持,使得在Unsloth自身环境中的输出速度提升了1.3到1.7倍。
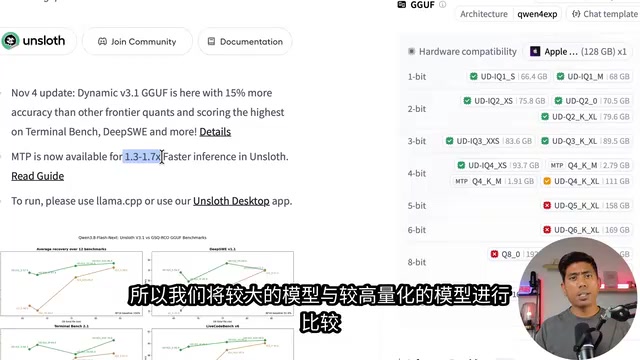
UP主在视频中对比了两种量化方案:一种是3位量化的GSQ-RCO模型(占用不到70GB),另一种是4位量化的Unsloth UDQ4-KXL模型(占用约111GB)。虽然量化位数不同,但UP主希望验证Unsloth的新模型是否在保持加速效果的同时,带来更优的质量表现。
量化(Quantization) 是将神经网络权重和激活值从高精度浮点数(如 FP16/BF16)映射到低精度表示(如 3-bit、4-bit 整数)的压缩技术,其核心目标是在尽量保持模型输出质量的同时,把显存占用和内存带宽需求降低数倍。传统量化多为静态方案:先用校准数据统计各层激活的分布,再一次性确定缩放因子(scale)与零点(zero-point)。动态量化则是在推理时按实际输入动态计算量化参数,或对不同层/不同张量采用混合位宽——对敏感层保留更高精度、对冗余层压得更狠。这就是 Unsloth 声称“同等压缩率下准确率提升 15%”的技术基础:位宽总量不变,但分配更聪明。需要区分的是,量化位宽并不直接等于文件体积,还要考虑分组大小(group size)、是否保留嵌入层与输出头的高精度等因素,因此文中 3-bit 模型占 70GB、4-bit 占 111GB 的差异是合理的。
MTP(Multi-Token Prediction,多令牌预测) 原本是一种训练目标:让模型在一次前向传播中同时预测未来多个位置的 token,而不是只预测下一个 token,从而迫使模型学习更长程的依赖关系。在推理阶段,MTP 头可以被改造为投机解码(speculative decoding) 式的加速手段——主模型一次给出多个候选 token,再由验证步骤并行确认哪些被接受,接受率高时等效于每步产出多个 token。这正是文中“输出速度提升 1.3 到 1.7 倍”的来源:它不是提高了单次前向的计算速度,而是提高了每次前向的“有效产出”。MTP 的加速幅度高度依赖任务本身的可预测性,代码补全、格式化输出这类高规律任务的接受率通常高于开放式创意写作,这也解释了实测中不同任务加速比存在波动。
实测环境与基准测试
测试在Apple M5 Max上进行,使用Strata推理引擎的最新版本。UP主首先让模型检查一个仓库中的代码,以验证其实际理解能力。在运行过程中,监控显示生成速率大约在每秒107到117个Token之间,具体取决于启动方式。平均而言,模型能达到每秒70到80个Token,UP主评价“效果相当不错”。作为对比,GGUF的3位量化版本大约为每秒110个Token,但质量上的权衡需要考量。
仅仅26秒,模型就返回了结果,正确识别了仓库内容,并进行了约20次工具调用,输入输出总计约138个Token。这显示了模型在代码理解任务上的高效性。
文中反复出现的 GGUF 是 llama.cpp 生态主推的模型文件格式,它把权重、分词器词表与量化元数据打包进单个文件,并针对 CPU/Apple Silicon 的金属(Metal)后端做了内存布局优化,是本地推理最常见的分发格式之一。GGUF 的量化命名遵循 K-quant 体系,例如 Q4_K_M 中的“4”表示主体权重约 4 bit,“K”表示采用分块的 k-quant 方案,“M”代表中等混合精度档位。需要注意的是,GGUF 量化与 Unsloth 动态量化属于不同层面的方案:前者偏重通用性与跨平台兼容,后者偏重特定推理引擎下的精度分配。因此文中“3 位 GGUF 约 110 tok/s”与 Unsloth 模型的对比并非严格同条件,读者在解读速度数字时应把格式差异、引擎差异与位宽差异分开看待,避免把加速全部归因于量化算法本身。
代码迁移实战:.NET 8 到 .NET 10
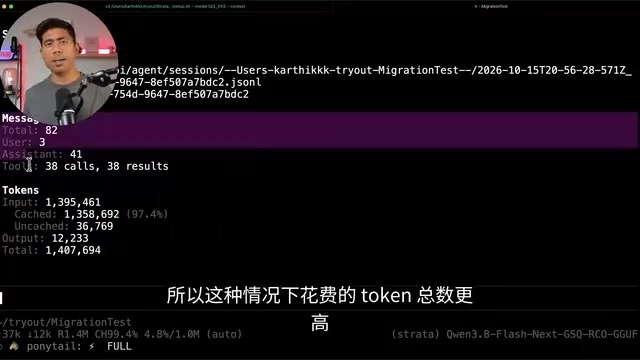
更复杂的测试是将一个产品API项目从.NET 8迁移到.NET 10,修复所有关键更改并更新NuGet包。UP主使用相同的提示词分别运行了4位量化的Unsloth模型和3位量化的GSQ-RCO模型。
Unsloth模型仅用三分钟就完成了全部迁移工作,总速度约为每秒73个Token,共进行了69次工具调用,消耗约86,000个Token(包括输入和输出)。而GSQ-RCO模型耗时2分51秒,消耗了82次工具调用和130万个输入输出Token。UP主指出,两者执行时间差异很小,最多约5秒,但Unsloth模型在Token消耗上明显更少。
这一结果与Unsloth声称的准确率提升15%相呼应——更少的工具调用和Token消耗意味着模型更精准地理解了任务,减少了无效尝试。
图像生成质量对比
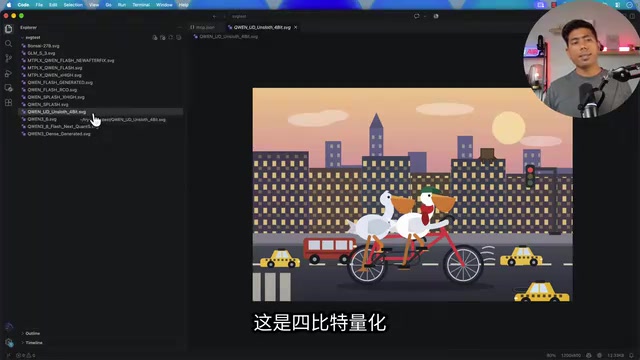
在创意任务方面,UP主让模型生成一张“两只醍醐在纽约骑自行车”的SVG图像。Unsloth的4位量化模型耗时约6分40秒,生成了质量相当不错的图像。而GSQ-RCO的3位量化版本仅需3到4分钟,但图像质量明显较差。
当与GSQ-RCO的5位量化对比时,UP主发现Strata输出引擎下生成的图像质量“稍微好一点”,但生成时间大约需要8到9分钟。这表明Unsloth的动态量化在质量与速度之间取得了更好的平衡,尤其是在4位量化下,质量足以满足实际需求。
Strata引擎与边缘计算前景
Strata推理引擎支持Unsloth动态量化V3.1,并且通过将权重从RAM转移到SSD,在Apple M5 Max上运行时虚拟内存开销更低。UP主提到,这使得在仅有64GB内存的小型机器上也能运行类似的模型。结合MTP支持带来的速度提升,整体渲染速度显著加快。
UP主总结道,Unsloth提供了更好的模型压缩和优化,适用于消费级硬件,同时将输出质量提升15%,而新增的MTP使输出速度比之前版本快1.7倍。这些改进让本地大语言模型的工作效果更好,UP主认为这是边缘计算的未来发展方向。
权重从 RAM 转移到 SSD 本质上是利用操作系统的内存映射(mmap)机制实现的按需分页加载:模型文件留在固态硬盘上,推理时只把当前层或当前专家所需的权重页调入内存,用完即被页缓存回收。其代价是首次加载存在 I/O 延迟,且在内存严重不足、频繁换页(thrashing)时速度会明显下降;收益则是把“能否跑起来”的门槛从“内存 ≥ 模型体积”降低到“内存 ≥ 单层/单专家工作集”。这正是 64GB 内存机器能运行百 GB 级模型的原理所在。配合 MoE(混合专家)架构,每次前向只激活部分专家,工作集进一步缩小,SSD 换页的压力也随之可控。对边缘设备而言,这条路径的实际意义在于:算力不再是唯一瓶颈,存储带宽与随机读取性能正在成为新的关键指标。
总结与展望
本次实测展示了Unsloth动态量化3.1在准确率、速度和资源效率上的综合优势。尽管量化位数不同,但4位Unsloth模型在代码任务中表现出更少的Token消耗和相近的速度,在图像生成中则提供了明显优于3位量化的质量。随着Strata引擎对动态量化的支持以及MTP的引入,消费级硬件上的大模型部署正变得更加可行。UP主也透露,本月和下个月还将有更令人印象深刻的模型发布,本地大语言模型领域的发展值得持续关注。
相关推荐

Zed编辑器发布v1.29.2:一次常规版本迭代的观察
Zed编辑器发布v1.29.2补丁版本,由@JosephTLyons完成版本升级,提交经GitHub签名验证。本文梳理该版本的基本信息、补丁版本的含义以及对用户升级的实际建议。

Anthropic IPO遭质疑:Hacker News热议其上市时机
Hacker News出现「Just say no to Anthropic's IPO」帖子,引发对Anthropic上市时机与AI公司资本化的讨论,涉及估值泡沫与使命独立性等议题。

Genie 4世界模型上手:像木偶师一样实时导演世界
Google DeepMind 世界模型 Genie 4 深度解析:Special Guest X 实测展示如何用提示词实时导演场景、通过 Project Genie 构建自定义交互应用,以及提示词即种子的可复现设计。