Unsloth同步上新:DeepSeek-V4.1-Flash与FLUX.3本地可跑

Unsloth v0.1.909-beta 让 552B DeepSeek 低至 125GB 内存运行并支持 FLUX.3 本地微调。
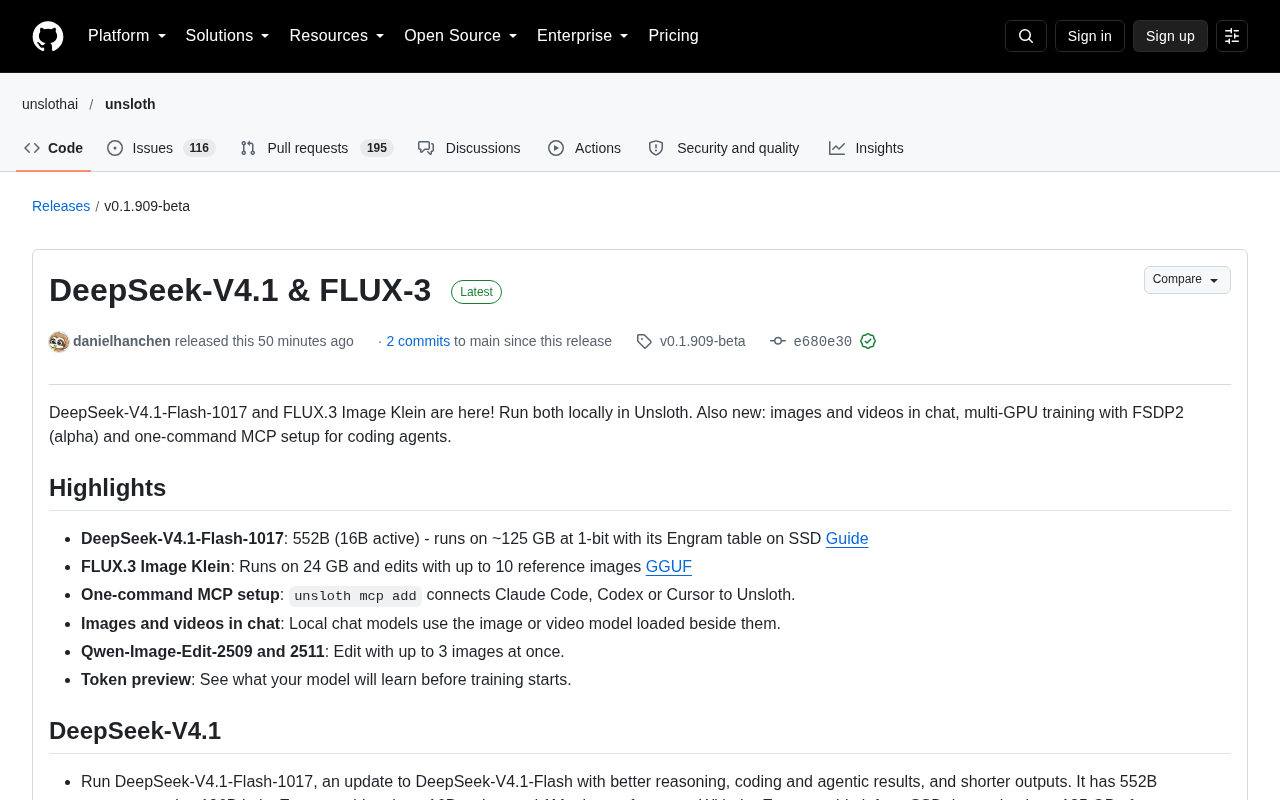
开源微调框架 Unsloth 发布 v0.1.909-beta,一次性支持 DeepSeek-V4.1-Flash-1017 与 FLUX.3 Image Klein 两个模型的本地运行与微调。DeepSeek 版本为 552B 参数、约 16B 激活、1M 上下文,将 Engram 表放在 SSD 上时 1-bit 量化约 125 GB 内存即可运行,Terminal-Bench 4.0 得分从 31.2 提升至 42.3。图像侧 FLUX.3 Image Klein 为 5.6B 模型,24 GB 显存可运行,支持最多 10 张参考图编辑。版本还打通聊天、图像与视频模型,新增 FSDP2、上下文并行及多项显存优化,LoRA 融合内核每步约快 28%,并支持一条命令通过 MCP 接入 Claude Code、Codex、Cursor。
开源微调框架 Unsloth 发布 v0.1.909-beta 版本,一次性把 DeepSeek-V4.1-Flash-1017 和 FLUX.3 Image Klein 两个重量级模型带进本地运行与微调工作流。这次更新的重点不只是"能跑",而是把大模型的显存门槛、训练效率和智能体集成往前推了一步。
DeepSeek-V4.1-Flash-1017:552B 参数跑进 125 GB
DeepSeek广告-V4.1-Flash-1017 是此前 DeepSeek-V4.1-Flash 的更新版本,官方给出的定位是推理、代码和智能体任务更强,输出更短。模型规模为 552B 参数,另外还有 196B 参数存放在 Engram 表中,激活参数约 16B,上下文长度达到 1M tokens。
真正有意思的是显存策略。Unsloth 把 Engram 表留在 SSD 上,在 1-bit 量化下模型大约占用 125 GB 内存即可运行;如果换到 4-bit,则需要约 300 GB。这给没有多卡集群、但有高速固态和大容量内存的玩家提供了一条现实路径。
能力提升有具体数据佐证:Terminal-Bench 4.0 得分从此前 DeepSeek-V4.1-Flash 的 31.2 提升到 42.3。思考模式默认开启且强度为 high,用户可以在 low 到 max 之间调整,或直接关闭思考。
Engram 表是 DeepSeek 模型中的一种外部参数结构,可以理解为存放在主模型权重之外、按需查表的「记忆」参数。把 Engram 表留在 SSD 上,本质是用存储换显存:激活计算只依赖约 16B 参数,静态查表部分不必常驻内存,代价是访问时要走高速固态的带宽。MoE 激活参数则指每 token 实际参与计算的专家子集规模,552B 总参数并不等于每步算 552B,这也是 1-bit 量化后 125 GB 内存可运行的根源。
FLUX.3 Image Klein:24 GB 显存和 10 张参考图
图像侧的新成员是 Black Forest Labs 的 FLUX.3 Image Klein,一个 5.6B 参数的模型,支持文字渲染和最多 10 张参考图的图像编辑。它能在 24 GB 显存的 GPU 上运行,GGUF 版本在没有受支持 GPU 的电脑上也能跑,另外还提供了未蒸馏的 Klein Base 版本。
默认开启的提示词增强功能值得单独提一句:它会把短提示扩展成详细描述,官方说法是能修复大多数困难姿态下的身体畸变。预览界面会展示扩展后的描述,方便复制或手动修改。
聊天、图像与视频打通
这次更新把本地聊天模型和图像、视频模型放到同一个工作环境里。在配有独立 GPU 的电脑上,图像、视频和朗读语音模型可以常驻在聊天模型旁边,设置里可选"放得下时加载"或"始终加载"。
打开 Images 开关后,本地聊天模型能直接调用旁边的图像或视频模型生成图片和可播放视频。图像模型替换掉 GGUF 聊天模型后,只要开启了跨卸载保留对话上下文,聊天不会重新读取整段对话。
Qwen-Image-Edit-2509 和 2511 现在每次编辑最多接受 3 张图;视频尺寸和宽高比可以自定义,也能选择模型训练过的尺寸。带大文本编码器的图像和视频模型在 GPU 支持时会默认加载量化编码器,编码器显存占用最多减半,加载也更快。LTX-2.5 不再需要 Hugging Face 登录。
训练:FSDP2、上下文并行与显存优化
多卡训练是这一版的另一条主线。Python 中可以用 FSDP2 把 LoRA、QLoRA 和全量微调分散到多张 GPU,配合 context_parallel_size 切分长序列,包括打包后的序列。上机前可以先跑 unsloth doctor --gpus 检查环境。
显存优化给出了几个开关:optim = "adamw_flash" 降低全量微调的优化器内存;设置 UNSLOTH_OFFLOAD_OPTIMIZER_STATE=1 可以把优化器状态放到系统内存,速度会有代价。开启 lora_dropout 或 lora_bias 的 LoRA 训练现在走 Unsloth 融合内核,每步约快 28%。
Gemma 4 的全局注意力层在 NVIDIA Ampere 及更新 GPU 上用上新内核,注意力速度提升 1.4 到 2.1 倍,注意力显存最多降低 4.9 倍。Qwen3.8-Flash-Next 在 MLX 上于 M5 Mac 最高快 1.4 倍,M1 到 M4 最高快 1.2 倍;M1 到 M4 上 4-bit 和 8-bit MLX 模型并行多轮对话最高快 1.8 倍。
训练前的 Token 预览功能会显示数据集里模型实际训练的部分,并标记被上下文上限截断的样本。Data Recipe 对话现在按多轮对话训练,Qwen 微调会保留数据集里的 thinking 文本。
FSDP2(Fully Sharded Data Parallel v2)是 PyTorch 的新一代全分片数据并行实现,它把模型参数、梯度和优化器状态切分到各张 GPU 上,前向和反向时按需聚合,因此能在多卡上训练单卡放不下的模型。上下文并行则沿序列长度维度切分,把长序列的不同片段分给不同 GPU 计算注意力,二者结合可以同时缓解参数显存和长上下文显存压力。
LoRA 融合内核指把低秩适配中的低秩矩阵运算与 dropout、bias 等操作合并进单个 CUDA/Triton 内核,减少中间结果的读写与内核启动开销,这也是每步约快 28% 的原因。
一条命令接入编码智能体
Unsloth 加入了 MCP 服务器支持,一条 unsloth mcp add claude-code(或 codex、cursor)就能把 Claude Code、Codex 或 Cursor 接进来。智能体可以上传数据集、启动训练、加载产出的检查点,还能提前下载模型、预览加载时的下载内容,或排队视频生成任务。
MCP(Model Context Protocol)是让大模型应用以统一方式调用外部工具和数据源的开放协议。Unsloth 内置 MCP 服务器后,Claude Code、Codex、Cursor 这类编码智能体可以通过标准接口发现并调用「上传数据集」「启动训练」「加载检查点」等能力,无需为每个客户端单独写适配层,这也是「一条命令接入」得以实现的前提。
硬件兼容:Vulkan 与混合显卡
没有 NVIDIA GPU 或 ROCm 的电脑,比如 Snapdragon 笔记本和 Linux ARM 板子,现在可以通过 Vulkan 在 GPU 上跑 GGUF,而不是退回 CPU。NVIDIA MIG 切片能被正确划分和选择,混用不同代 GPU 的机器会得到每张卡都能运行的设置和 llama.cpp 构建。Windows on ARM 设备可以在设置里开启 Sandbox High。
Vulkan 是跨平台的现代图形与计算 API,在缺少 CUDA(NVIDIA)或 ROCm(AMD)生态的设备上,llama.cpp 等推理后端可以通过 Vulkan 调用 GPU 做矩阵运算,从而避免完全退回 CPU。NVIDIA MIG(Multi-Instance GPU)把一张物理 GPU 切分为多个独立实例,适合多用户或多任务隔离,但需要工具正确识别和选择切片,否则会出现显存或设备分配错误。
一点观察
把 552B 的模型压到 125 GB 内存、让 5.6B 的图像模型在 24 GB 显存上编辑 10 张参考图,这两个数字放在一起看,Unsloth 想解决的问题很明确:让前沿模型脱离云端 API,落到个人工作站上。Engram 表放 SSD 的做法是一种取舍,换来的是内存门槛的大幅下降,代价则押在存储带宽上。FSDP2 和上下文并行的加入说明它也在往多卡训练场景延伸,不再只是单卡微调工具。
对开发者来说,MCP 一条命令接入编码智能体可能是日常使用频率最高的改动;对想本地跑大模型的人来说,DeepSeek-V4.1-Flash-1017 的 1-bit 路线值得实测,尤其是它在长上下文下的实际表现。
相关推荐

2026年AI编程工具横评:Claude、ChatGPT、Gemini谁最强?
2026年五款主流AI编程工具横评:Claude Code、ChatGPT Codex、Gemini、DeepSeek和GitHub Copilot在真实项目、定价与代码质量上的全面对比,帮你决定每月20美元该花给谁。

ChatGPT Codex克隆任意软件?实测风险与真相
YouTube短视频宣称用ChatGPT Codex或Claude Code即可克隆Adobe、Excel、Figma等软件并终身免费使用。本文拆解其技术可行性、法律风险与私信引流套路,说明AI编程工具真正适合的用法。

Kilo Code免费安装但API收费:成本估算与配置指南
Kilo Code 开源 AI 编程代理安装免费,但接入的 AI 模型按 token 收费。本文详解 VS Code 扩展与 CLI 配置步骤,并用假设用量演示 API 成本估算方法,对比按量付费与订阅制的选择逻辑。