Unsloth新版本:定时任务与MiniMax-M3.1-Flash登场

Unsloth v0.1.911-beta 新增定时任务、MiniMax-M3.1-Flash 模型与图像编辑能力,并大幅优化 Mac 与训练性能。
Unsloth v0.1.911-beta 带来多方向更新。自动化方面新增“Scheduled”定时任务,可按一次性、每日、工作日、每周或每月运行提示词,结果保存为新会话,支持指定模型并配置通知策略,但仅在 Unsloth 运行期间执行且不支持工具调用与联网搜索。模型生态引入 MiniMax-M3.1-Flash,428B 总参数、23B 激活的 MoE 架构,支持 100 万 tokens 上下文,1-bit 量化仍需约 130GB 内存与显存总和。图像侧 FLUX 3 支持提示词编辑并保留原始尺寸,新增需 SAM 3 与 inpainting 模型配合的 Detailer,视频可用 Cosmos3-Edge 生成,旧款 NVIDIA GPU 上 Wan2.1 1.3B 提速约 5 倍。性能上 Mac 端 MLX 聊天提速最高 16%,Z-Image 文生图快 1.5-2 倍,渲染收尾内存占用下降;训练侧支持跨 GPU 分层训练与 GRPO 提速,API 安全策略亦有收紧。
Unsloth 最新发布的 v0.1.911-beta 版本带来了一系列实用更新,涵盖自动化任务、新模型支持、图像编辑和多平台性能优化。本文梳理其核心亮点,并分析这些变化对开发者的实际价值。
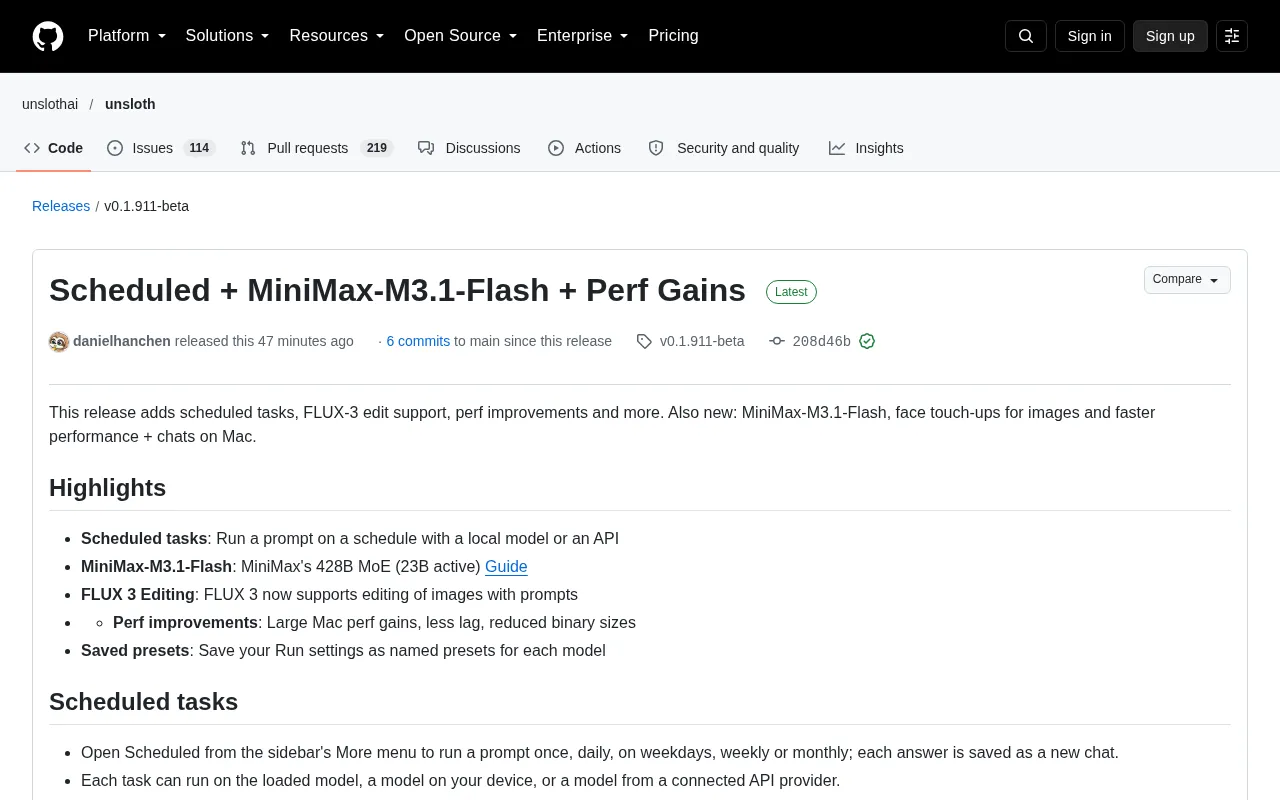
定时任务:让模型在后台自动运行
Unsloth 在侧边栏的“More”菜单中新增了“Scheduled”入口,允许用户按计划运行提示词。任务频率支持一次性、每日、工作日、每周或每月,每次运行的结果都会保存为一个新的聊天会话。
任务可以指定在已加载的模型、本地设备上的模型,或来自已连接 API 提供商的模型上运行。如果任务所需的模型尚未加载,Unsloth 会先询问用户,除非开启了“Switch automatically when I'm away”选项。用户还可以设置通知策略:每次运行后通知、仅在失败时通知,或从不通知。
需要注意的是,任务仅在 Unsloth 运行期间执行,且不支持工具调用或网络搜索。这一设计适合那些重复性的文本生成或分析任务,比如每日摘要、定时提醒等。
MiniMax-M3.1-Flash:面向编码与Agent工作流
本次更新引入了 MiniMax-M3.1-Flash,这是一个拥有 428B 总参数、23B 激活参数的 MoE 模型,官方定位为编码、工具使用和 Agent 工作流场景。它支持高达 100 万 tokens 的上下文长度,适合处理长文档或复杂对话。
在 GGUF 量化方面,1-bit 量化版本至少需要 130GB 的内存与显存总和。对于想在本地运行该模型的用户,这是一个重要的硬件门槛,需要提前评估设备配置。
MoE(Mixture of Experts,混合专家)是一种稀疏激活的模型架构:模型内部包含多个“专家”子网络,每个 token 在推理时只被路由到其中少数几个专家计算,因此总参数量可以做得很大,而单次前向计算实际用到的参数量(即“激活参数”)却很小。这正是 MiniMax-M3.1-Flash 能以 428B 总参数、仅 23B 激活参数运行的原因——它保留了大规模参数带来的知识容量,同时把推理成本控制在接近 23B 稠密模型的水平。对本地部署而言,决定显存需求的主要是激活路径与量化后实际驻留的权重,而 GGUF 等量化格式会进一步压缩权重体积;但 1-bit 量化仍需约 130GB 内存与显存总和,说明总参数规模依然是硬件门槛的主导因素。
图像编辑与生成能力增强
FLUX 3 现在支持通过提示词对图像进行编辑,用户可以在 Images > Edit 中修改照片,并保留原始尺寸。这为图像后期处理提供了更灵活的方式。
此外,Images 页面新增了 Detailer 功能,可以开启以更高分辨率重绘人脸、手部或其他用户指定的区域。该功能需要 SAM 3 和一个支持 inpainting 的模型配合使用。
在视频方面,用户可以通过 NVIDIA 的 Cosmos3-Edge 在 Video 页面从文本或图像生成视频。对于较老的 NVIDIA GPU(RTX 30 系列之前),Wan2.1 1.3B 文本到视频的渲染速度提升了约 5 倍,这显著降低了旧硬件用户的使用门槛。
Inpainting(图像修复/局部重绘)指只对图像中指定的蒙版区域重新生成内容,而蒙版以外的像素保持不变,因此特别适合修脸、补手、去物体等局部编辑。Detailer 的工作流程通常分两步:先用检测或分割模型(这里用的是 SAM 3,Segment Anything Model 的第三代)自动或手动圈出目标区域,再把该区域裁剪放大后交给支持 inpainting 的模型以更高分辨率重绘,最后贴回原图。由于扩散模型在原始分辨率下对人脸、手指等小面积区域分配的像素太少,直接生成容易糊或变形,先放大再重绘能显著提升细节质量,这也是 Detailer 需要额外配合分割模型的原因。
性能优化:Mac 与本地推理提速
Mac 用户是本次性能改进的重点受益者。MLX 聊天在草稿模型加持下回复速度最高提升 16%,且自带草稿模型的 MLX 模型会自动启用该功能,无需额外下载。在 Apple Silicon 上,Z-Image GGUF 默认使用 MLX 引擎从文本生成图像,速度比之前快 1.5 到 2 倍。
图像和视频渲染在结束时所需的内存大幅减少,低内存 Mac 因交换而卡顿的情况将明显减少。此外,许多图像和视频模型在 NVIDIA GPU 上首次加载后会保存构建版本,后续加载更快。
MLX 是 Apple 为 Apple Silicon 芯片设计的数组计算与机器学习框架,能统一利用 CPU 与 GPU 共享内存,因此在 Mac 上运行大模型时通常比通用后端更高效。文中提到的“草稿模型”对应推测解码(speculative decoding):用一个体积小、速度快的草稿模型先连续猜出若干 token,再由目标大模型一次性并行验证,被接受的猜测直接保留,从而在不改变输出分布的前提下减少大模型的前向次数,实现加速。草稿模型与目标模型越“对味”,接受率越高,提速越明显;自带草稿模型的 MLX 模型自动启用该机制,正是省去了用户手动挑选匹配草稿模型的步骤。
训练与API安全改进
训练方面,LoRA 和 QLoRA 训练现在支持将模型的每一层拆分到多块 GPU 上,通过设置 UNSLOTH_TP_SIZE 环境变量并使用 torchrun 启动,每块 GPU 的显存占用更低。GRPO 训练在使用 vLLM 生成时,在 Linux + NVIDIA GPU 环境下配合 16-bit LoRA,每步速度提升最高 1.9 倍;不使用 vLLM 时,Llama 和 Qwen3 在 NVIDIA GPU 上每步速度提升最高 4.4 倍。
API 安全方面,使用 Unsloth API 密钥的应用不能再自行批准 Python 或终端调用在沙箱外运行。Unsloth 默认也不再信任转发客户端 IP,若部署在反向代理后,需要设置 UNSLOTH_STUDIO_TRUST_FORWARDED=1,否则所有用户将共享同一个登录速率限制。
把模型每一层拆分到多块 GPU 上,属于张量并行(Tensor Parallelism)的思路:单层内的权重矩阵被切分到不同设备,各设备计算部分结果后通过集合通信(如 all-reduce)汇总,从而把单卡显存压力分摊到多卡。与数据并行不同,张量并行切分的是同一层的参数本身,适合单卡放不下的大模型微调,但代价是设备间通信频繁,对互联带宽较敏感。torchrun 是 PyTorch 提供的分布式启动器,负责为每个进程设置 rank、world size 等环境变量并拉起多进程;UNSLOTH_TP_SIZE 则告诉 Unsloth 期望的并行度,两者需保持一致,否则会出现进程数与切分策略不匹配的问题。
总结
Unsloth v0.1.911-beta 在自动化、模型生态和性能上均有实质进展。定时任务为重复性工作提供了便利,MiniMax-M3.1-Flash 扩展了本地可运行的大模型选择,而 Mac 和训练侧的优化则直接提升了日常使用体验。对于关注本地 AI 工作流的开发者,这个版本值得升级。
相关推荐

Cognition SWE-2 实战:一个提示词搞定产品发布全流程
解析 YouTube 创作者用 Cognition SWE-2 发布产品的完整提示词:落地页、七封邮件序列与未购买用户跟进工具三段式结构,以及"测试并汇报"这一约束如何改变 AI 的交付质量。
AWS AgentCore Gateway:用MCP打通AI Agent与企…
AWS AgentCore Gateway:用MCP打通AI Agent与企业后端
AWS AgentCore Gateway如何作为主MCP服务器聚合REST API、Lambda与已有MCP服务?解析其AST实时映射、零冷启动、语义搜索治工具过载、会话隔离与密钥注入安全设计,以及企业AI Agent解耦后端的架构思路。

一个链接给Figma AI装上新技能:MCP连接器实战
通过粘贴一个MCP服务器链接,Figma中的AI Agent就能获得新工具能力。本文拆解配置流程、超过20个一键接入应用、读写权限与执行策略设置,以及公开HTTPS链接这一关键限制。