#性能优化
共 19 篇相关文章
PyTorch性能剖析实战:从torch.profiler到AWS Trainium硬件周期
AWS Annapurna Labs工程师分享PyTorch性能剖析实战方法论:如何用torch.profiler在AWS Trainium芯片上捕获trace、下钻硬件周期、追踪依赖链,并结合自动化分析定位主机开销、通信阻塞与计算空闲等瓶颈。
Anthropic如何用Claude在两周内让Claude.ai提速3倍
Anthropic用Claude在两周内让Claude.ai和桌面应用提速3倍。本文深度拆解其方法论:先测量后优化、实验室确定性指标、CI护栏,以及由此带来的过度缓存回归问题与AI辅助性能工程的新思路。

帧率上限正在拖慢你的可玩广告加载速度
可玩广告常用 30fps 帧率上限省电,但在预加载阶段保留它会拖慢加载。实测显示移除预加载帧率限制后,加载时间从 4.1 秒降至 1.7 秒。本文解析原因并给出分阶段帧率策略与 DevTools 排查建议。

Unity WebView优化:1MB限制下真正的瓶颈是运行时成本
Unity WebView优化中,1MB文件限制只是入场券,真正的瓶颈是纹理解码、着色器编译和内存分配等运行时成本。本文解析如何通过严格预算和视觉取舍降低首次可交互时间。
AI时代跨语言编程实战:TS调用C++实现高性能计算
本文基于B站演示案例,详解AI时代如何用TypeScript调用C++实现高性能计算:涵盖Node.js原生扩展、CMake构建、Node API接口注册,以及GB级大数据交互中的零拷贝优化技巧,适合AI与智能体开发者参考。
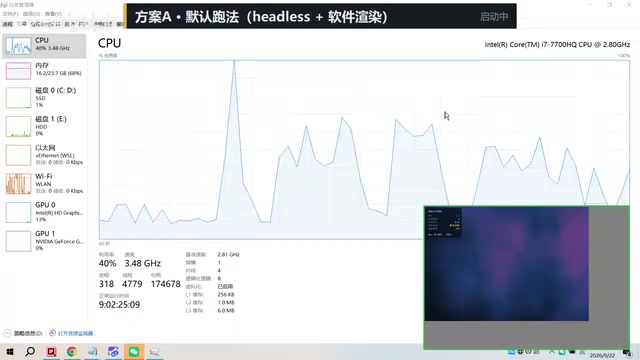
Agent浏览器自动化卡死?这个Skill让CPU占用降96%
AI Agent 跑浏览器自动化时 CPU 频繁卡死?一个 Browser Verified GPU 技能通过真实 GPU 渲染、降画质限帧的方式,实测让 CPU 占用降低约 96%、场景加载快 6.8 倍,验证结论完全一致。

两周让 Claude.ai 快3倍:Anthropic 的前端性能优化实践
Anthropic 分享如何用两周让 Claude.ai 性能提升约3倍。本文解读 AI 对话应用的性能瓶颈、前端流式渲染优化与工程实践启示,帮助开发者提升 AI 产品体验。
让AI Agent优化Rust代码:性能编程新思路
探讨一种新兴的Rust性能优化思路:通过让AI Agent在基准测试反馈下反复迭代,自动化提升代码运行速度。分析该方法的可行性、关键要点与潜在风险。

循环展开优化Gauss-Seidel迭代:破解循环携带依赖瓶颈
深入解析Gauss-Seidel迭代法中的循环携带依赖问题,探讨如何通过循环展开技术打断依赖链、隐藏指令延迟,从而提升数值计算的实际性能表现及其中的工程权衡。
用记忆化技术将eBPF的CPU开销降低约90%
一则Hacker News技术分享显示,通过记忆化(Memoization)缓存技术可将eBPF程序的CPU开销降低约90%。本文解析记忆化在eBPF中的落地方式、eBPF map缓存策略及工程权衡。
 教程攻略
Android 17开发新工具:性能优化与跨设备UI开发实战指南
深入解析Google I/O 2025发布的Android 17开发新工具,涵盖R8 Configuration Analyzer性能优化、Jetpack Glance跨设备UI开发、Media3 AI FX媒体处理全链路方案,助力开发者打造高端用户体验。
 科技前沿
SGLang v0.5.12.post1发布:DeepSeek V4稳定性修复与Blackwell适配
SGLang v0.5.12.post1稳定性补丁详解,包含12项关键修复,涵盖DeepSeek V4乱码与崩溃问题、NIXL PD分离式推理逻辑修复、Blackwell B300架构适配及冷启动性能优化。
 前沿研究
Go 1.25实验性垃圾回收器Green Tea详解
Go 1.25引入实验性垃圾回收器Green Tea,探索GC架构变革。本文解析Green Tea设计理念、启用方式及对高并发服务、内存密集型应用的潜在性能提升,帮助开发者评估新GC的实际价值。
 科技前沿
Go 1.26 正式发布:全新GC、SIMD支持等重大更新解析
Go 1.26 正式发布,带来全新垃圾回收器、cgo调用开销大幅降低、实验性SIMD支持包及runtime/secret密钥管理包。本文详细解析各项更新对Go开发者的实际影响。
 前沿研究
栈上分配:逃逸分析如何用栈替代堆实现内存优化
深入解析栈上分配的内存优化策略,介绍逃逸分析原理、编译器实现机制及实际性能影响。了解如何通过减少堆分配降低GC压力、提升缓存命中率,并掌握帮助编译器优化的开发实践。
 科技前沿
Pi AutoResearch:AI自动跑实验,性能优化不再手动试错
Pi AutoResearch 是基于 Karpathy Auto Research 理念的编程插件,能自动生成优化方案、修改代码、跑测试、记录结果,实现性能优化实验的全流程自动化,支持构建速度、打包体积、模型训练等多种场景。
 科技前沿
GPT-5.2击败Claude Opus 4.5:Anthropic性能挑战实测详解
开发者使用GPT-5.2配合Codex CLI,在Anthropic官方性能挑战中以1243周期击败Claude Opus 4.5的1487周期基准,实现119倍加速。深度解析优化历程、技术方案与行业启示。
 科技前沿
TRE正则引擎:Python绑定与ReDoS防御实战
深入解析TRE正则引擎的无回溯设计如何防御ReDoS攻击。通过Python ctypes绑定实验,对比TRE与Python re模块在恶意正则输入下的性能差异,探讨Redis采用TRE的原因及安全正则引擎的实践应用。
