V100显卡选购对决:4×16G PCIe与2×32G SXM哪个更值?

两种 V100 方案的硬件背景
NVIDIA V100 于2017年发布,基于Volta架构,是当时数据中心AI计算的旗舰产品。Volta架构(GV100芯片)采用台积电12nm FFN工艺,集成210亿晶体管,是当时半导体制造工艺的极限挑战之一。其核心创新是引入了Tensor Core单元——专为混合精度矩阵乘法设计的硬件模块。Tensor Core 并非普通的浮点运算单元:与传统 CUDA Core 每个时钟周期完成一次浮点乘加不同,每个 Tensor Core 每个时钟周期可以完成一次 4×4 矩阵乘加运算,等效于 64 次浮点运算。
Tensor Core 的设计哲学来源于对深度学习计算特征的深刻洞察:NVIDIA对ResNet、BERT等典型网络的长期分析表明,神经网络训练和推理中超过70%的计算时间集中在矩阵乘法(GEMM)操作,而矩阵乘法天然适合以分块方式并行执行。Volta架构的Tensor Core将4×4矩阵乘加融合为单条硬件指令(D=A×B+C),支持FP16输入、FP32累加的混合精度模式,在保证数值精度的同时最大化吞吐。V100 搭载 640 个 Tensor Core,这正是其在FP16精度下峰值算力达到125 TFLOPS、是前代Pascal架构5倍以上的硬件基础。这一设计直接催生了NVIDIA与百度共同推广的AMP(Automatic Mixed Precision)训练范式,现已内置于PyTorch和TensorFlow框架中。混合精度训练范式(前向传播用 FP16 利用 Tensor Core 加速,参数更新保留 FP32 以维持数值稳定性)也由此成为大模型训练的标准做法。这一架构思路后来在A100的第三代Tensor Core(新增TF32和BF16支持)以及H100的第四代Tensor Core(原生FP8支持,峰值达3958 TFLOPS)中持续演进。在A100发布前,V100是深度学习训练和推理的事实标准,大量部署于AWS、Azure、Google Cloud等主流云平台。如今其二手价格已从最高约1万美元/张跌至数百至千余元人民币区间,使其成为个人和小型团队本地部署大模型的可行硬件选项。
随着 SXM2 和 PCIe 接口 V100 在二手市场大量流通,玩家们逐渐分化出两条部署路线。一条是购买原生 PCIe 接口的 16G V100,靠数量堆叠(如 4 张卡)来扩展显存和算力;另一条则是采用 32G 大显存的 SXM 版本,通过转接板转成 PCIe 接口使用,靠单卡大显存和更高带宽取胜。
值得了解的是,V100 的 SXM2 与 PCIe 两种形态有着根本性的工程差异。SXM(Socket for HPC with Mezzanine)是 NVIDIA 与IBM联合开发的高性能计算服务器 GPU 封装与互联标准,其底板连接器可承载超过400W的持续功耗,并直接集成NVLink控制器信号引脚,与消费级 PCIe 插槽在物理形态、供电方式和信号传输上均有本质区别。SXM2 版本的 V100 通过 NVLink 2.0 实现 GPU 间点对点直连,单条 NVLink 链路提供 25 GB/s 双向带宽,V100 配备 6 条 NVLink,总双向带宽达 300 GB/s。
NVLink 绕过了传统PCIe多卡系统中GPU间通信必须经过CPU的PCIe根复合体(Root Complex)中转的路径,在GPU芯片之间建立点对点的高速串行链路,其协议栈专为GPU内存语义(load/store)设计,支持原子操作和远程直接内存访问(RDMA)。NVLink 还支持 GPU 间统一内存寻址(Unified Memory),使多卡显存可以被视为逻辑连续的地址空间访问,这对需要频繁跨卡读取 KV Cache 的长上下文推理场景尤为重要。相比之下,PCIe 3.0 x16 的单向理论带宽仅约 15.75 GB/s,双向约 31.5 GB/s,差距近 10 倍。二手市场上的 SXM 版本通常来自 DGX/HGX 退役服务器,需通过第三方转接板才能插入标准 PCIe 插槽——由于SXM底板的NVLink信号引脚在转接后缺乏对应的板级电气路径,NVLink 功能在转接后往往无法启用,只剩下更大显存容量和略高的功耗上限作为核心优势。
说个细节,原生 PCIe 版本的 16G V100 TDP 被限制在约 250W,而 SXM 版本的 TDP 为 300W。这 50W 的差距在长时间高负载推理中会体现为可感知的算力差异。测试所使用的推理框架为 OneCat VLLM 1.2.1,模型为 Qwen3.6 的 R7B FP8 版本。
关于 OneCat VLLM:vLLM 是由 UC Berkeley 开发的高性能 LLM 推理引擎,其核心创新 PagedAttention 技术借鉴操作系统虚拟内存管理思想,将 KV Cache 划分为固定大小的"页"进行动态分配。传统实现为每个请求预分配最大序列长度所需的连续内存块,导致大量内部碎片——例如为2048 token上限预分配的内存在实际序列长度仅512 token时,有75%的显存被浪费。PagedAttention通过页表维护逻辑地址到物理页的映射,使不同请求可以共享相同前缀的KV Cache页(Prefix Caching),从根本上解决了 KV Cache 内存碎片化和预分配浪费的问题,显存利用率从传统方案的60%~80%提升至95%以上。OneCat VLLM 1.2.1 是社区针对特定硬件环境优化的定制版本,在官方 vLLM 基础上对旧架构 GPU 做了兼容性适配。
关于 FP8 量化:FP8(8 位浮点)量化存在 E4M3(4位指数+3位尾数,适合权重存储)和 E5M2(5位指数+2位尾数,适合梯度)两种子格式。原生 FP8 硬件加速最早在 NVIDIA Hopper 架构(H100,2022年)的第四代 Tensor Core 中实现,峰值算力达 3958 TFLOPS,是 FP16 的两倍。V100 所属的 Volta 架构 Tensor Core 仅支持 FP16/FP32 混合精度,不具备原生 FP8 矩阵乘法指令,因此 FP8 在 V100 上通常通过将数值反量化为 FP16 后再计算的方式执行,无法获得算力加速。FP8 的主要收益集中于显存节省——将 7B 模型的权重从约 14 GB(FP16)压缩至约 7 GB(FP8),使单卡可容纳的 KV Cache 空间几乎翻倍,对 16G 显存的 V100 尤为关键。
关于 Qwen3 R7B:Qwen3 是阿里云广告推出的第三代通义千问开源系列,覆盖从 0.6B 到 235B 参数的多个规模档位。R7B 是该系列中激活参数约为 7B 的推理优化(Reasoning)变体,具备强化的链式思维能力,适合逻辑推理和复杂问答场景。该系列还引入了分组查询注意力(GQA)技术,将KV头数从32减少至8,相比标准多头注意力(MHA)将KV Cache体积压缩至约1/4,有效缓解了长上下文下的显存压力。
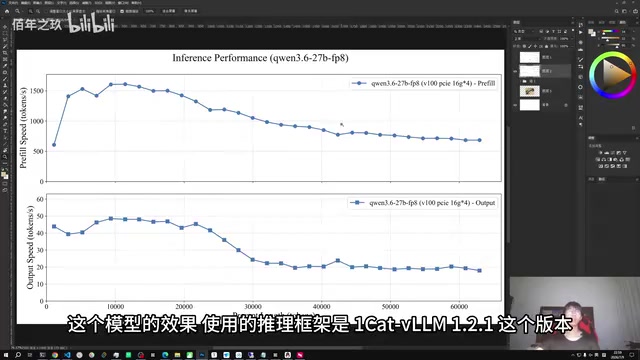
预处理速度:张量并行未能带来线性提升
直觉上,4 张 16G 显卡在总算力和总显存上都应超过 2 张 32G 显卡,理应跑出接近两倍的性能。然而实测结果给出了一个更复杂的答案。
尽管 VLLM 支持张量并行(Tensor Parallelism),能将模型切分到多张卡上协同计算,但从预处理(Prefill)速度来看,4 张 V100 16G 并未跑出两倍于 2 张 V100 32G 的效果。
张量并行的工作原理是将单层神经网络的权重矩阵横向切分到多张 GPU 上并行计算——以 Transformer 注意力层为例,多头注意力的权重被均匀分配给每张卡,各卡独立完成局部矩阵乘法后,再通过 All-Reduce 操作将结果汇总同步。All-Reduce 是分布式训练和张量并行推理中最核心的集合通信原语,其Ring-AllReduce实现将数据分成N份在N个节点的环形拓扑中流转,每个节点发送和接收的数据总量趋近于2倍原始数据量。在实际工程中,Megatron-LM等框架将AllReduce分解为ReduceScatter和AllGather两个阶段以提升流水线效率。值得注意的是,张量并行的实际加速比遵循Amdahl定律的通信扩展版本:Megatron-LM的实验数据表明,在NVLink互联环境下8卡张量并行可达到7.5×以上的线性加速;而在PCIe 3.0 x16环境下,对于7B规模模型通常仅能达到2.5-3×,超过4卡后通信开销完全抵消额外算力。对于7B参数模型,单层Transformer的隐层维度通常为4096,全精度激活值每层约需传输数十MB,在PCIe 3.0 x16约15.75 GB/s的单向带宽下,32层网络的累计通信延迟可达数十毫秒量级——在 NVLink 互联环境下,300 GB/s 的双向带宽使这一开销相对可控;而在转接为 PCIe 的场景中,每次 All-Reduce 都需经过 CPU 或 PCIe Switch 中转,延迟可高出 5~10 倍,随着并行卡数增加,这一差距会被反复放大。这也是NVIDIA在推荐张量并行时始终强调"TP度数不应超过NVLink直连的GPU数量"的工程原因。
UP 主分析认为原因出在两个层面:
- 功耗限制:原生 PCIe 版本 16G V100 单卡功耗仅 250W,算力天花板受限;
- 带宽瓶颈:预处理阶段对显存带宽和卡间通信带宽高度敏感,多卡张量并行引入的额外通信开销,会抵消相当一部分算力堆叠的收益。
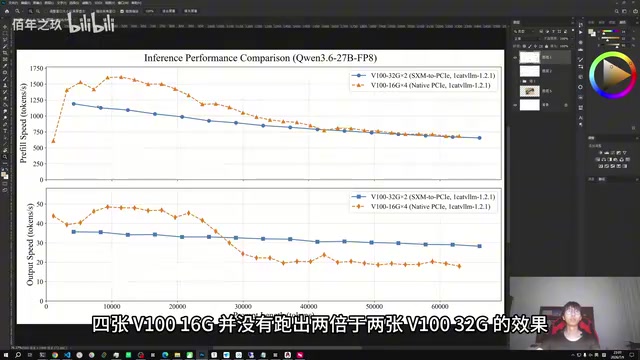
长上下文下的性能收敛现象
测试中还出现了一个耐人寻味的现象:当上下文长度超过 3 万 token 时,两种方案的预处理速度曲线逐渐贴合。也就是说,在长上下文场景下,4×16G 与 2×32G 的预处理性能差距被明显抹平。
这是偶然巧合,还是长上下文下带宽瓶颈主导了两者共同的性能天花板?UP 主坦言目前尚无定论。从技术角度推测,这与 KV Cache 的访存特性密切相关。KV Cache(Key-Value Cache)是 Transformer 推理优化的核心机制,模型会缓存每个已处理 token 对应的注意力键值对以避免重复计算,但其内存占用随上下文长度线性增长。对于Qwen系列7B模型,其精确的KV Cache占用可由公式计算:2 × num_layers × num_kv_heads × head_dim × seq_len × dtype_bytes。由于Qwen系列采用分组查询注意力(GQA),KV头数仅为8(而非完整的32),FP16精度下每千个 token 约占用 256 MB 显存——已是标准MHA的1/4;在 3 万 token 时,KV Cache 总量约达 7.5 GB,已占 16G 显存的近一半。随着上下文逼近 3 万 token,KV Cache 的读写压力剧增,显存带宽逐渐成为主导因素,而两种方案在这一区间的有效带宽趋于接近,从而导致曲线收敛。
输出速度:长上下文下的断崖式衰减
如果说预处理速度的对比还算势均力敌,输出(Decode)速度的对比则暴露了更明显的问题。
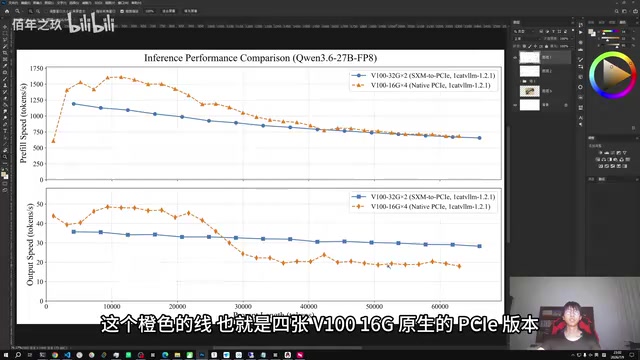
测试数据清晰显示,代表 2×32G SXM 转接版本的曲线,将 4×16G 原生 PCIe 版本的曲线明显划分为上下两段:
- 2 万 token 以内:输出速度可达约 45 tokens/秒;
- 3 万 token 以上:输出速度骤降至约 20 tokens/秒。
这一断崖现象有其深层的物理原因。Decode 阶段属于典型的访存密集型操作——每生成一个新 token,模型必须从显存中读取全部历史 token 的 KV Cache 来计算注意力权重,但实际计算量只有一个向量与整个序列的内积。理解这一现象需要引入**计算访存比(Arithmetic Intensity,AI)**的概念:定义为浮点运算次数(FLOPs)与内存访问字节数(Bytes)之比。V100的峰值算力约125 TFLOPS(FP16),显存带宽约900 GB/s,临界AI约为138 FLOP/Byte——高于此值的算子为Compute Bound,低于此值的为Memory Bound。Decode阶段的AI接近1 FLOP/Byte,远低于138的临界值,是极端Memory Bound的工作负载,GPU 的计算单元在等待数据搬运时大量空转,整体吞吐完全受制于显存带宽而非算力。这也是为何FlashAttention、FlashDecoding等IO感知算法在Decode阶段能带来显著加速的根本原因——它们通过减少对HBM的访问次数来直接压缩这一瓶颈。
当上下文超过约 3 万 token,4×16G 方案中每张卡仅持有部分 KV Cache,生成每个 token 时需要通过 PCIe 总线跨卡读取其他 GPU 上的 KV Cache 片段——PCIe 的传输延迟通常在数十微秒级,而 NVLink 为亚微秒级,相差一到两个数量级,在高频次的 Decode 循环中被线性放大,最终导致速度从 45 tokens/秒断崖式跌落至 20 tokens/秒。而 2×32G 方案中每张卡持有的显存更大,KV Cache 分布更集中,跨卡通信频次相对较低,因此在长上下文下表现更为稳定。
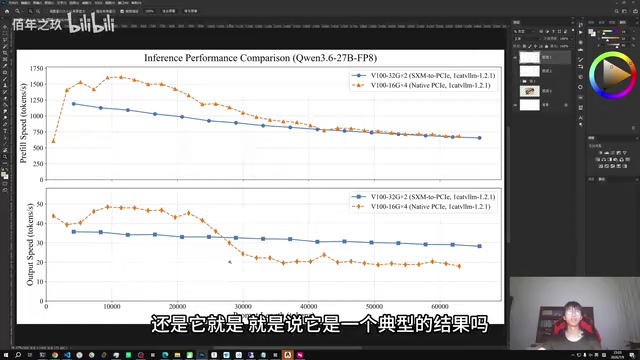
这种断崖式的衰减意味着,在处理长文档、长对话等场景时,用户能明显感受到生成速度的下降。今天的曲线图将 UP 主此前口头提及的现象可视化,直观呈现了衰减的临界点所在。
单次测试的局限性
UP 主保持了难得的严谨态度,明确指出输出速度的这次下降仅测试了一次,无法判断它是偶然现象还是典型规律。他提出后续可重复测量五次取平均值,通过统计手段验证这一衰减是否显著。这种对实验可重复性的重视,在硬件评测内容中值得肯定——单次跑分很容易受系统状态、缓存、散热等偶发因素干扰,GPU 的动态降频(Boost Clock 随温度变化)本身就会造成同等条件下数个百分点的性能波动。值得一提的是,V100在持续满载推理时的热节流现象尤为明显:当芯片结温超过83°C后,Boost Clock会从约1530 MHz逐步降至基础频率1290 MHz,算力损失约16%,这在散热方案一般的转接卡环境中是常见现象。
性价比之王究竟是谁?
综合两组数据,可以得出一些初步判断,但难有绝对定论:
- 中短上下文(2 万 token 以内):两种方案输出速度接近,4×16G 方案靠算力堆叠略有优势,但功耗限制和通信开销拖住了线性翻倍的可能;
- 长上下文(3 万 token 以上):预处理速度趋同,但输出速度出现明显衰减,32G 大显存方案在单卡承载长上下文时 KV Cache 无需跨卡读取,稳定性更具优势;
- 成本维度:原生 PCIe 16G V100 价格已大幅回落,但堆 4 张的总成本未必低于 2 张 32G SXM 版本,还需额外考量主板 PCIe 插槽数量、电源功率(4×250W vs 2×300W,前者峰值总功耗更高)与散热压力。
所谓"性价比之王"并没有唯一答案,关键在于应用场景。以短文本任务为主且预算极度敏感,4×16G 是可行之选;若需要稳定处理长上下文,2×32G 方案的大显存优势更值得优先考虑。
总结与后续展望
这次对比虽然只围绕 Qwen3.6 R7B FP8 单一模型展开,却揭示了一个重要认知:多卡堆叠并不等于性能线性叠加,功耗墙、带宽瓶颈和卡间通信开销都会显著拖累实际表现。对于打算用 V100 搭建本地推理平台的用户而言,理解这些瓶颈,比单纯盯着显存总量更有实际意义。
UP 主表示,后续计划继续对比 Qwen3.6 35B A3 FP8 这一更大规模的 MoE 模型。MoE(Mixture of Experts,混合专家)架构最早由Jacobs等人于1991年提出,在大语言模型时代由Google的Switch Transformer重新激活,其核心是用稀疏激活替代稠密前馈网络:每个 Transformer 层包含 N 个专家子网络(FFN),门控路由器(Gating Router)根据每个 token 的隐状态动态选择 Top-K 个专家处理。Qwen3系列使用Top-2路由,即每个token同时选择2个专家进行处理。为避免所有 token 都路由至同一个专家(专家坍塌),训练时通常引入辅助负载均衡损失(Auxiliary Load Balancing Loss)和专家容量因子(Expert Capacity Factor)强制均匀分布;但在推理时,不同输入序列的路由决策本质上是动态的,无法提前预判。以 Qwen3 35B A3 为例,35B 为总参数,A3 表示每次前向传播激活约 3B 参数,实际计算量与 3B 稠密模型相当,但参数存储量达 35B——FP8量化后仍需约35 GB存储,超出单张32G V100的物理限制,必须跨卡分布存储专家权重,推理时显存占用不可压缩。
MoE 在多 GPU 部署时面临独特的通信挑战:不同专家被分散存储在不同 GPU 上,每个 token 的路由目标是动态决定的,这要求使用 All-to-All 通信原语——每个 GPU 需要向所有其他 GPU 发送属于其专家的 token,同时接收路由至本卡专家的 token。All-to-All 的通信量与GPU数量N的平方成正比,远比稠密模型 All-Reduce 更难扩展。此外,专家容量因子(通常设置为1.2-2.0)意味着每个专家需预留额外缓冲以处理负载峰值,进一步增加显存压力。叠加专家负载不均衡(部分热门专家被频繁选中导致 GPU 利用率差异悬殊)和显存碎片化问题,在 PCIe 互联带宽受限的 4 卡方案中,两种 V100 方案的差距可能进一步拉大,值得持续关注。
核心要点
相关推荐

AI Agent Skill 脚本开发:何时该写与绝不能写
AI Agent Skill 开发中,脚本什么时候该写、什么时候绝对不能写?本文梳理对接外部系统、固定运算、复用脚本等必写场景,以及意图识别、规则变动、高危操作等禁写场景,附一句话决策原则。

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。