VersaCamVLA:可配置相机的机器人VLA策略框架

VersaCamVLA通过解耦相机表示与动作学习,让VLA模型不再怕换相机。
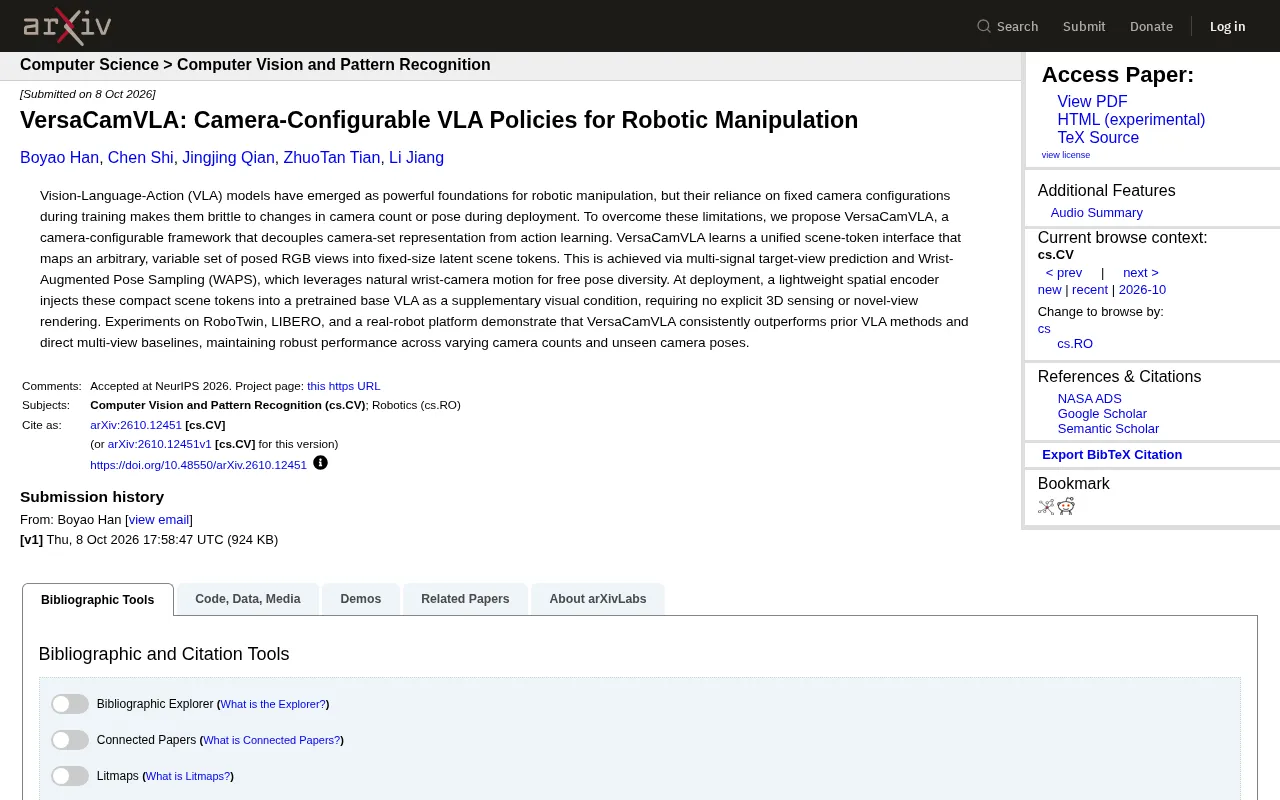
针对视觉-语言-动作(VLA)模型对固定相机配置高度依赖、部署时相机数量或位姿变化即性能骤降的问题,VersaCamVLA提出了一种相机可配置的策略框架。它把任意数量与位姿的带位姿RGB视图映射为固定尺寸的场景token,从而将相机表示与动作学习解耦。核心方法包括多信号目标视图预测和腕部增强位姿采样(WAPS),前者迫使场景token编码丰富的空间信息,后者利用腕部相机自然运动获得免费的位姿多样性。部署时仅需轻量空间编码器将场景token注入预训练VLA,无需显式3D传感或新视图渲染。在RoboTwin、LIBERO及真实平台上,该方法持续优于先前VLA与多视角基线,并在未见相机位姿下保持鲁棒。
机器人操作中的视觉-语言-动作(VLA)模型看似强大,却有一个常被忽视的软肋:它们对训练时的相机配置过度依赖。一旦部署环境中的相机数量或位姿发生变化,模型性能就可能急剧下降。这种脆弱性在真实场景中尤为致命,因为产线上的相机布局往往无法与训练集完全一致。
近期,一篇题为《VersaCamVLA: Camera-Configurable VLA Policies for Robotic Manipulation》的研究提出了针对这一问题的系统性解法。它不再要求模型死记硬背某组固定的相机视角,而是学习一种与相机集合无关的场景表示,再将这种表示注入到预训练的VLA基座中。
问题根源:VLA模型为何怕换相机
当前主流的VLA模型通常将多路RGB图像直接拼接或按固定顺序输入策略网络。这种设计隐含了一个假设:训练和测试时的相机数量、安装位置、内外参完全一致。
一旦部署时增加一个相机、拆掉一个腕部相机,或者只是把相机挪了几厘米,输入张量的结构就被破坏,模型看到的是“错位”的视觉信号。更麻烦的是,重新采集数据并微调模型成本极高,对于每个新相机配置都要重复一遍。
VersaCamVLA的核心洞察在于:动作学习本身不应该与相机集合的表示纠缠在一起。如果能把任意数量、任意位姿的相机视图压缩成一组固定的场景token,那么下游的VLA策略就可以专注于动作生成,而无需关心相机配置。
什么是VLA模型:视觉-语言-动作(Vision-Language-Action, VLA)模型是一类将视觉感知、自然语言指令与机器人动作生成统一到一个网络中的具身基础模型。其典型做法是以预训练的视觉-语言模型(如CLIP、PaLI等)为骨干,通过在大规模机器人示教数据上进行微调,让模型学会“看到画面、听懂指令、输出动作”。代表性工作包括RT-2、OpenVLA、π0等。由于VLA通常以多路RGB图像作为视觉输入,并依赖固定的相机编号与顺序拼接,其视觉编码器隐式地把“第几路相机”与“画面语义”绑定在一起,这正是它在相机配置变化时失效的根源。
相机内参与外参:相机内参描述镜头与成像传感器的几何特性,包括焦距、主点位置和畸变系数,决定了三维点如何投影到像素平面;相机外参描述相机在机器人基坐标系或世界坐标系中的位置与朝向,通常由旋转矩阵和平移向量构成。VLA模型在不同相机配置下失效,本质上是因为输入图像所隐含的内外参发生了变化,而策略网络无法感知这种变化,导致视觉token的语义与训练时不再对应。
方法拆解:解耦相机表示与动作学习
VersaCamVLA构建了一个统一的场景token接口,将“任意可变集合的带位姿RGB视图”映射为“固定尺寸的隐空间场景token”。这个映射过程依赖两个关键设计。
多信号目标视图预测
模型并不直接监督场景token去重建输入图像,而是通过预测一组目标视图的视觉特征来间接训练。这种多信号预测迫使场景token编码足够丰富的空间信息,而不仅仅是压缩像素。
新视图合成与目标视图预测的区别:新视图合成(novel-view synthesis)通常指用NeRF、3D高斯泼溅等方法,从已有视角显式渲染出一个全新视角的像素图像,计算代价高且需要重建几何。VersaCamVLA采用的是目标视图预测,即不生成像素,而是让模型预测某个虚拟视角下的视觉特征(如DINOv2或CLIP特征)。这种做法的好处是:特征空间比像素空间更紧凑,避免了渲染开销;同时多个目标视图提供多路监督信号,迫使场景token保留跨视角一致的三维结构信息,而不会退化成对单一输入图像的简单压缩。
腕部增强位姿采样(WAPS)
真实数据中相机位姿的多样性往往有限。WAPS利用机器人腕部相机在操作过程中的自然运动,自动产生大量免费且多样的相机位姿样本。这意味着模型在训练阶段就能“见过”各种视角,而不需要专门为每个新位姿采集数据。
这两个设计共同作用,使场景token接口具备了良好的泛化能力:无论输入几个相机、位姿如何变化,都能输出稳定、紧凑的场景表示。
腕部相机与手眼标定:腕部相机(wrist-mounted camera)是安装在机器人末端执行器附近的相机,随机械臂运动而移动。相比固定的第三人称相机,腕部相机在操作过程中天然扫过大量不同位置和角度,形成了丰富的位姿轨迹。WAPS正是利用这一物理特性,把腕部相机在不同时刻的位姿当作“免费的”不同视角样本来增强训练,从而在不额外采集数据的情况下扩充相机位姿分布。需要注意的是,腕部相机的位姿可通过机器人正运动学和手眼标定精确获得,这也是它能作为监督信号的前提。
部署方式:无需3D传感器或新视图渲染
很多多视角方案会引入显式的3D重建、点云处理或新视图渲染(novel-view rendering),这些模块本身就带来额外延迟和工程复杂度。
VersaCamVLA选择了更轻量的路径。部署时,一个轻量级空间编码器将场景token注入到预训练的基础VLA中,作为补充视觉条件。整个过程不依赖显式3D传感,也不需要渲染任何新视图。
这意味着它可以作为一个“插件式”模块叠加在现有VLA基座上,而不必重新设计整个策略网络。对于已经部署了VLA模型的团队来说,迁移成本相对可控。
插件式策略与基础模型适配:所谓插件式模块,指在不改变预训练VLA主干参数结构的前提下,额外插入一个轻量编码器或适配器(adapter),把场景token作为附加条件注入到策略网络的特征流中。这与全量微调不同:全量微调会修改主干权重,需要为每个新相机配置重新训练并可能遗忘原有能力;而插件式方案只训练少量新增参数,主干保持冻结或基本冻结。其代价是表达能力受限于适配器容量,优点是训练成本低、迁移快、易于在同一基座上支持多种相机配置。
实验表现:跨相机数量与未见位姿的鲁棒性
论文在三个平台上进行了验证:仿真基准RoboTwin、LIBERO,以及一个真实机器人平台。
结果显示,VersaCamVLA在多个任务上持续优于先前的VLA方法和直接的多视角基线。更重要的是,它在相机数量变化和未见过的相机位姿下都保持了稳定的性能。
这一点在多视角基线中很难做到——那些方法通常在训练配置下表现尚可,一旦相机集合改变就明显退化。VersaCamVLA的优势恰恰体现在这种分布外泛化场景中。
行业意义:VLA走向实用部署的一步
机器人基础模型正从实验室演示走向真实产线,而相机配置的灵活性是绕不开的工程问题。产线改造、相机维护、不同工位的硬件差异,都会导致相机配置偏离训练分布。
VersaCamVLA提出的解耦思路——用统一的场景token接口吸收相机变化,让动作策略保持稳定——为VLA的鲁棒部署提供了一个务实的方向。它不追求端到端的完美统一,而是把相机表示和动作学习拆开,各自用合适的方式处理。
当然,该方法目前仍依赖带位姿的RGB视图输入,场景token的信息瓶颈也值得进一步分析。但就“让VLA不再怕换相机”这个目标而言,VersaCamVLA给出了一份有说服力的答卷。