Vibe Coding架构解析:认知、执行与编排三位一体系统

什么是Vibe Coding:一场开发范式的转移
Vibe Coding(凭感觉编程)这个概念最早由特斯拉前AI总监Andrej Karpathy提出。Karpathy是深度学习领域的标志性人物,曾负责特斯拉Autopilot视觉系统,此前在OpenAI担任研究科学家,也是斯坦福大学广受欢迎的深度学习课程CS231n的创建者。2025年初,他在社交媒体上首次提出Vibe Coding这一概念,描述自己如何完全依赖LLM编程,甚至"忘记了代码的存在"。
具体来说,Karpathy在2025年2月的一条推文中详细描述了自己的实践:他使用Cursor中的Composer功能,配合SuperWhisper语音输入,几乎完全通过口述自然语言来完成编程。他表示自己"看代码的时间越来越少,只是接受所有diff,报错了就把错误信息复制给AI"。这种看似随意的开发方式之所以引发巨大反响,是因为它暗示了一个深刻的范式转移:当模型能力跨过某个阈值后,人类开发者的核心价值不再是"写出正确的代码",而是"定义正确的问题"。这一概念迅速引发开发者社区的广泛讨论,因为它精准捕捉了AI辅助编程从"工具辅助"跃迁到"意图驱动"的临界点。
它并不是指某个具体工具,而是一种全新的开发习惯,或者说是一种新范式。
在传统的编码模式下,开发者既要当"设计师"去构思逻辑,又要当"泥瓦匠"去搬砖——手动敲写大括号、分号,抠各种底层API调用细节。而在Vibe Coding模式下,工作流发生了根本变化:开发者不再需要死磕复杂的语法和底层API,而是扮演"总指挥"或"产品经理"的角色,只需用自然语言表达意图,底层的AI执行架构会接管所有的"体力活"。
换句话说,人类只负责表达意图和最终验收,所有实现细节都交给系统完成。这标志着开发正从"手工语法"走向"意图驱动"。
Vibe Coding的三个演进阶段
这种变化并非一夜之间发生,而是经历了三个清晰的阶段:
- 复制粘贴时代(约一两年前):使用网页版ChatGPT或Claude,在聊天框里提问,手动复制代码到编辑器,报错了再复制回去继续问。此时AI与本地环境是物理隔离的。
- 智能体时代:像Cursor这样的工具直接驻留在本地,能读取项目文件、自动运行、自动改错,省去了频繁的手动复制。Cursor是由Anysphere公司开发的AI原生代码编辑器,基于VS Code开源内核进行深度改造,其核心创新在于将大模型的上下文窗口与本地代码库通过RAG(检索增强生成)机制深度集成。RAG最初由Meta AI研究团队在2020年提出,其核心思想是将外部知识库与生成模型解耦——生成时先通过向量检索从知识库中找到相关片段,再将这些片段作为上下文注入生成模型。在代码编辑器场景中,RAG的实现更为复杂:需要对整个代码库进行语义索引(而非简单的关键词匹配),包括函数调用图、类型继承关系、import依赖链等结构化信息,这样当用户发出指令时,Cursor会自动检索相关文件、函数定义、类型声明等上下文,将其注入提示词,使大模型拥有项目级的"视野"。但在这个阶段,AI往往"单兵作战",缺乏大局观。
- 工作流时代:也就是真正的Vibe Coding。通过引入框架和约束,用标准工作流规范AI,确保在多轮修改中代码不会写坏、不会漏掉真实需求。
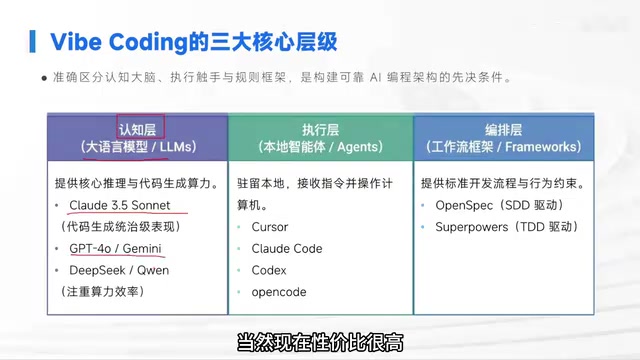
三层架构:认知层、执行层与编排层
一个完整的Vibe Coding架构由三个明确的层级组成,可以类比为一个团队的三种分工。
认知层:团队的大脑
认知层由各种大语言模型构成,负责核心的推理和代码生成能力。在写代码这个极度内卷的赛道上,模型可以分为三个梯度:
- 代码专精模型:代表是Claude 3.5 Sonnet。它由Anthropic公司开发(Anthropic由前OpenAI研究副总裁Dario Amodei创立,专注AI安全研究)。Sonnet之所以在代码生成领域表现突出,核心原因在于其训练策略的差异化——在Constitutional AI框架下进行了大量代码推理的专项优化,尤其擅长长链逻辑推理和上下文一致性维护。Constitutional AI(宪法AI)是Anthropic在2022年提出的对齐方法论,其核心创新在于用一组明确的原则("宪法")来指导模型的自我改进过程。与传统RLHF(基于人类反馈的强化学习)依赖大量人工标注不同,Constitutional AI让模型先生成回答,再根据预设原则进行自我批评和修订,最后用修订后的数据进行训练。在代码领域,这意味着模型被训练为在生成代码时自动检查逻辑一致性、安全性和可维护性,而非仅仅追求"看起来正确"的输出。在SWE-bench等代码基准测试中,Sonnet的表现长期领先。SWE-bench是由普林斯顿大学研究团队在2023年发布的代码能力评估基准,全称Software Engineering Benchmark——与传统的代码生成评测(如HumanEval、MBPP)只测试单函数生成不同,SWE-bench从真实的GitHub开源项目中提取了数千个已解决的Issue,要求模型在完整的代码库上下文中定位问题、理解需求并生成正确的代码补丁,因此被业界视为衡量AI编程能力最权威的基准之一。所谓砍掉了多模态功能,是指其算力预算和训练资源更集中于文本推理而非图像/视频生成,专注逻辑推理和代码生成。在Vibe Coding中,它是首选"大脑",决定了代码质量的上限。
- 全能通用模型:如GPT-4o、谷歌Gemini,追求全环境覆盖,综合素质好,适合多模态交互和通用业务场景。
- 效率与本地模型:如DeepSeek广告、通义千问广告,主打性价比和速度,适合写单元测试、格式化文件等高频、低逻辑难度的场景。
执行层:本地Agent的角色
执行层是驻留在本地的Agent工具,如Cursor、Claude Code。它们负责接受大脑的指令,真正去操作计算机——读取项目结构、写入文件、运行终端命令。这些工具内置了终端集成和diff预览机制,AI生成的代码修改以diff形式展示,用户确认后才真正写入磁盘,这本身就是一种轻量级的读写隔离实践。
编排层:工作流的项目经理
这一层提供开发流程和行为约束,是三层中最关键的部分。像OpenSpec、Superpowers这类框架,就像项目经理或标准工作流制度,规定AI必须先干什么、再干什么,从而保证代码靠谱、可维护。
云端大脑与本地Agent的协同机制
大模型运行在云端服务器上,而代码在本地硬盘里,两者协同必须有一套机制。
打破物理隔离
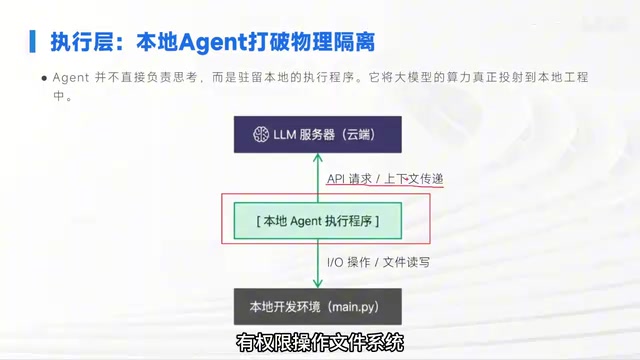
大模型本质上是运行在云端沙盒里的文本生成引擎,它看不见也摸不着你的电脑,连本地硬盘都进不去。如果它想修改一个 main.py 文件,它无法直接伸手,只能在云端生成一行代码,然后被网络边界挡住。
解决方案是在本地部署一个"听话的"Agent。当大模型想修改文件时,它通过API把指令发送给本地Agent;Agent因为运行在本地、拥有文件系统权限,会直接在硬盘上做IO操作,或在终端运行代码检查报错,再把报错信息打包成上下文回传给云端大脑。这就像云端大脑通过"无线电"指挥本地机器人干活,物理隔离由此被打破。
Function Calling:自然语言转机器指令
大模型说的是"大白话",机器人如何精准执行?关键技术是 Function Calling。
Function Calling是OpenAI在2023年6月随GPT-3.5/4 API更新首次引入的能力,随后迅速成为行业标准。发布后,它迅速催生了整个AI Agent生态——2023年下半年,LangChain、AutoGPT等框架将Function Calling封装为"工具使用"(Tool Use)抽象层;2024年,Anthropic的Claude推出了自己的Tool Use API,Google Gemini引入了Function Declaration机制。到2025年,Function Calling已从单一函数调用演进为复杂的多步骤工具编排(Tool Orchestration),支持并行调用、条件分支和错误重试。
其核心原理是:在系统提示词中以JSON Schema格式定义可用工具的名称、描述和参数结构;大模型在推理时如果判断需要外部工具介入,会输出一段符合预定义Schema的结构化JSON,而非自然语言文本。本地运行时通过解析这段JSON,提取函数名和参数,调用对应的本地函数或API。这一机制本质上是将大模型从"纯文本生成器"升级为"智能路由器"——它知道什么时候该自己回答、什么时候该调用外部能力。这一技术的意义远超编程领域,它本质上定义了"AI如何与外部世界交互"的标准协议,是从聊天机器人到自主智能体演进的关键基础设施。
以"查一下北京今天的天气"为例:本地应用提前告诉大模型有一个 getWeather 工具及其参数。大模型听懂后不会直接回答,而是返回一段结构化数据,请求在本地执行 getWeather(city='北京')。本地应用调用真实的天气API拿到结果(如"晴朗25度"),再送回给大模型,由它组织成一句自然语言回复。
在这个循环中,不可控的自然语言被完美转换成计算机能准确执行的系统级调用,这正是本地Agent能读写文件、运行命令的底层逻辑。
编排层详解:给AI套上工程化缰绳
如果完全放任AI自由发挥,很快就会面临工程灾难。原始无约束的Vibe Coding有三大痛点:
- 目光短浅:为修复眼前小bug,大刀阔斧改动多处,破坏底层架构,引入更隐蔽的缺陷。
- 需求失真:自然语言模糊有歧义,AI根据脑补做错误假设,写出的业务逻辑跑偏。
- 上下文退化:对话轮次一多,受限于注意力机制,AI逐渐忘记核心规范、接口命名规则甚至架构风格。上下文退化问题根植于Transformer架构的注意力机制。Transformer由Google Brain团队在2017年的论文《Attention Is All You Need》中提出,其自注意力(Self-Attention)机制允许模型在处理序列时关注任意位置的信息,理论上解决了RNN的长程依赖问题。然而,自注意力的计算复杂度为O(n²),其中n为序列长度,这意味着即使窗口扩大,模型对远距离token的有效利用率也在下降。各种位置编码方案(RoPE、ALiBi等)虽然在一定程度上缓解了这一问题,但纯粹扩大上下文窗口并不能从根本上解决信息遗忘。尽管现代大模型的上下文窗口已扩展到128K甚至更长的token,但注意力分数的分配并非均匀的。模型对最近的token和最开始的token关注度较高,中间部分容易被"遗忘",这被称为"Lost in the Middle"现象(2023年斯坦福研究团队首次系统性证实)。在多轮对话场景中,早期定义的架构规范会逐渐滑入注意力的"盲区",导致AI生成的代码风格漂移、违反既定规范。
为对付这些痛点,必须把与AI的交互封装成标准工作流,强制它走一套确定性的工程流程。目前主流有两种驱动方式。
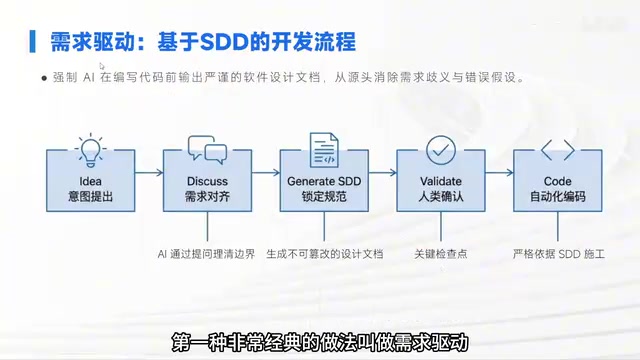
SDD:需求驱动开发
SDD(软件设计文档)驱动强调"规范先行"。AI动笔前必须先理清需求:通过提问对齐理解、厘清边界,然后生成一份不可篡改的设计文档,把模块、接口、数据流向全部固定下来。经人类关键节点确认后,AI才能严格按文档施工,从源头消灭需求失真。
TDD:测试驱动开发
TDD(测试驱动)强调"测试先行",以测试用例作为AI行动的绝对标尺。TDD并非AI时代的新发明,而是Kent Beck在2003年正式提出的经典软件工程方法论,属于极限编程(XP)实践的核心组成部分。Kent Beck是极限编程的创始人,也是敏捷宣言的17位初始签署者之一。TDD的经典循环是"红-绿-重构"三步走,看似简单实则蕴含深刻的设计哲学:它迫使开发者在写代码前先思考"这段代码应该做什么"(通过测试定义行为),而非"这段代码怎么实现"。这与Vibe Coding的意图驱动理念不谋而合。
流程是:AI先写单元测试(此时业务代码未写,运行失败显示"红灯");接着AI只能编写"刚好能通过测试的最小代码",多余一行都不准写;测试变"绿灯"后再进行重构优化。将TDD应用于AI编程的精妙之处在于:测试用例构成了一个不可欺骗的"裁判系统"——AI不能通过模糊的自然语言蒙混过关,代码要么通过测试要么不通过,这种二值判定天然适合作为AI行为的约束边界。TDD在传统开发中推广困难的主要原因是人类开发者觉得"先写测试"违反直觉、增加初始工作量;而AI没有这种心理负担,反而天然适合这种受约束的工作模式。测试用例不会撒谎,AI想敷衍都不行。
OpenSpec与Superpowers框架对比
- OpenSpec:典型的SDD驱动,理念是规范先行。内部设计了状态机(explore探索→propose定稿→apply执行),把写文档和改代码严格分开。状态机(Finite State Machine)是计算机科学中最基础的计算模型之一,由有限数量的状态、状态间的转移条件和转移动作构成。在OpenSpec中引入状态机的设计意义深远:它将AI的行为从"自由对话"约束为"有限状态转移"——AI在每个状态下只能执行特定类型的操作,且必须满足明确的退出条件才能进入下一状态。例如在Explore状态下AI只能提问和检索,不能生成代码;只有当需求明确度达到阈值后才能转移到Propose状态。这种设计将不确定性的AI行为强制纳入确定性的工程流程,是编排层实现可靠性的数学基础。OpenSpec适合复杂业务和从0到1构建大项目。
- Superpowers:典型的TDD驱动,理念是测试先行。严格限制AI执行逻辑,彻底消除AI擅自捏造虚假测试结果的风险,适合核心算法模块和高可靠性系统重构。
EPA模式:读写隔离的安全阀门
高级编排框架通常强制实行读写隔离:在 Explore(探索) 阶段AI只能只读操作,检索、搜索文件;进入 Plan(规划) 阶段仍是只读,先写好改动方案;只有方案经人类确认,进入 Act/执行 阶段,才真正放开写权限。
这种读写隔离的设计思想在计算机科学中有深厚渊源,类似于数据库事务中的隔离级别控制、操作系统中的用户态/内核态权限分离。其核心理念是:在信息不完整时绝不允许产生副作用(写操作),只有当决策充分确认后才赋予执行权限,从而将错误操作的影响域压缩到最小。
分层存储:对抗上下文退化的策略
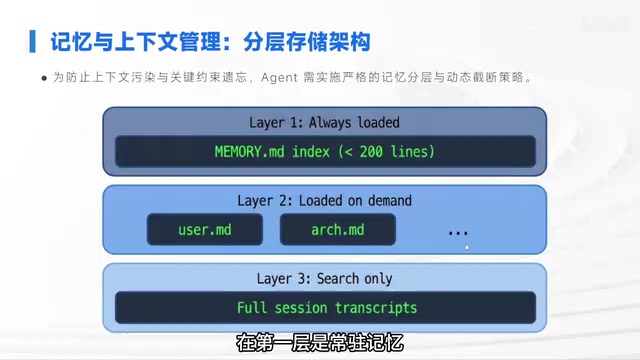
为防止上下文退化,编排层采用分层存储架构:
- 常驻记忆:项目根目录下的
memory.md,通常不超过200行,记录最核心、绝不能忘的项目规范,每次对话无条件加载。这相当于人类工作记忆中的"核心信念",无论对话如何推进都始终在注意力焦点内。 - 按需加载记忆:用户手册、架构文档等,只在执行相关任务时动态加载。这类似于RAG(检索增强生成)的思路——不把所有信息一次性塞入上下文窗口,而是根据当前任务的语义相关性按需检索注入,既节省宝贵的token配额,又确保相关信息的完整性。
- 仅限检索记忆:完整的对话历史,平时不加载,只在需要查历史决策时通过检索定向获取。
三位一体系统的协同与未来演进
把认知、执行、编排三层拼合,就构成了一条自上而下的精密流水线:
- 起点:开发者用自然语言提出意图;
- 第一关——编排与约束层:用SDD/TDD工作流规范需求,用生命周期钩子控制关键节点,用分层存储锁定记忆,把有歧义的需求收敛成有规矩的开发计划;
- 第二关——执行层:本地Agent通过Function Calling把方案翻译成机器指令,在受限的权限沙盒里安全地读写文件、运行测试;
- 第三关——认知与推理层:Claude 3.5 Sonnet等代码专精模型提供源源不断的推理算力。
三层互相咬合,最终输出的才是真正高可靠、生产级的代码。这与平时在聊天框里"问一句改一句"的简单模型调用有着本质区别。
不变的底层逻辑
面对模型和工具的高速迭代,其实不必焦虑。最外圈的基座模型迭代最快,中间圈的工具形态不断演进(今天是VS Code插件,明天可能是独立命令行工具),但最核心的底层架构逻辑永远不变。要用AI稳定产出商业级代码,始终要做三件事:
- 读写隔离:达成方案共识前不让AI乱碰代码;
- 约束注入:用测试或设计文档规范AI的行为边界;
- 上下文收敛:分层管理记忆,防止大模型丢三落四。
这三条原则的底层逻辑,其实与软件工程几十年来积累的最佳实践一脉相承——代码审查(Code Review)是读写隔离的人工版本,需求规格说明书是约束注入的传统形态,项目wiki和技术文档是上下文收敛的原始手段。Vibe Coding并没有发明新的工程原则,而是用AI+自动化的方式将这些原则的执行效率提升了数个量级。
只要掌握这套三位一体的底层逻辑,无论未来技术如何迭代,都能一眼看透新工具的本质,把技术主动权牢牢抓在自己手里。
核心要点
核心要点
相关推荐

特斯拉Roadster为何要会飞?深度拆解马斯克的疯狂演示
特斯拉Roadster发布会演示了爬墙、倒立与飞跃特技,但The Vergecast拆解后指出:演示车或拆除电池、Rocket版为邀请制且不合法上路,官网条款甚至不保证交付。跳票九年后,这台车为何仍需存在?

AI不是替代者:从工厂根因分析看人机协作
从工厂根因分析场景出发,解析AI如何加速证据链构建而非替代人类专家,探讨「AI支持人而非取代人」的务实落地逻辑与商业价值。

AI Agent决策审计:受监管流程中的证据链怎么建
从Reddit讨论出发,分析受监管流程中AI agent决策审计的三个核心问题:审计记录该包含哪些字段、错误决策的反馈延迟如何应对、以及LLM评审员与人类判断的一致性如何持续校准。