VibeCodeArena排行榜揭秘:人类+AI为何能击败最强模型

VibeCodeArena 排行榜揭示:评测高分不等于 Elo 排名,人机协作可压过顶级模型。
文章基于 HackerEarth 的 VibeCodeArena 平台数据,指出 LLM 编程竞技场中 Eval score 与 Elo 排名并不同步,Elo 来自两两对战更接近人类偏好。头部人类用户通过“人机协作”模式——从模型产出出发、读指标定位问题、验证修复——取得约 99.5 评测分和 1641-1642 Elo,压过最强模型。作者还强调置信度和趋势比名次更关键,排名第一的模型置信度为 Low,且高评测分应用仍可能藏有大量正确性问题。最后给出调整提示词习惯的实操建议,并认为 AI 让调试、读需求等能力更值钱。
VibeCodeArena 是 HackerEarth 打造的一个 LLM 编程竞技场,模型和人类用户同台解决相同的编程挑战,共享同一个排行榜。一位参与该平台工作的顾问在修复 AI 生成应用的过程中,从排行榜数据里读出了几个反直觉的结论:评测高分不等于排名靠前,人类用户组成的"人机组合"甚至能压过顶级模型。
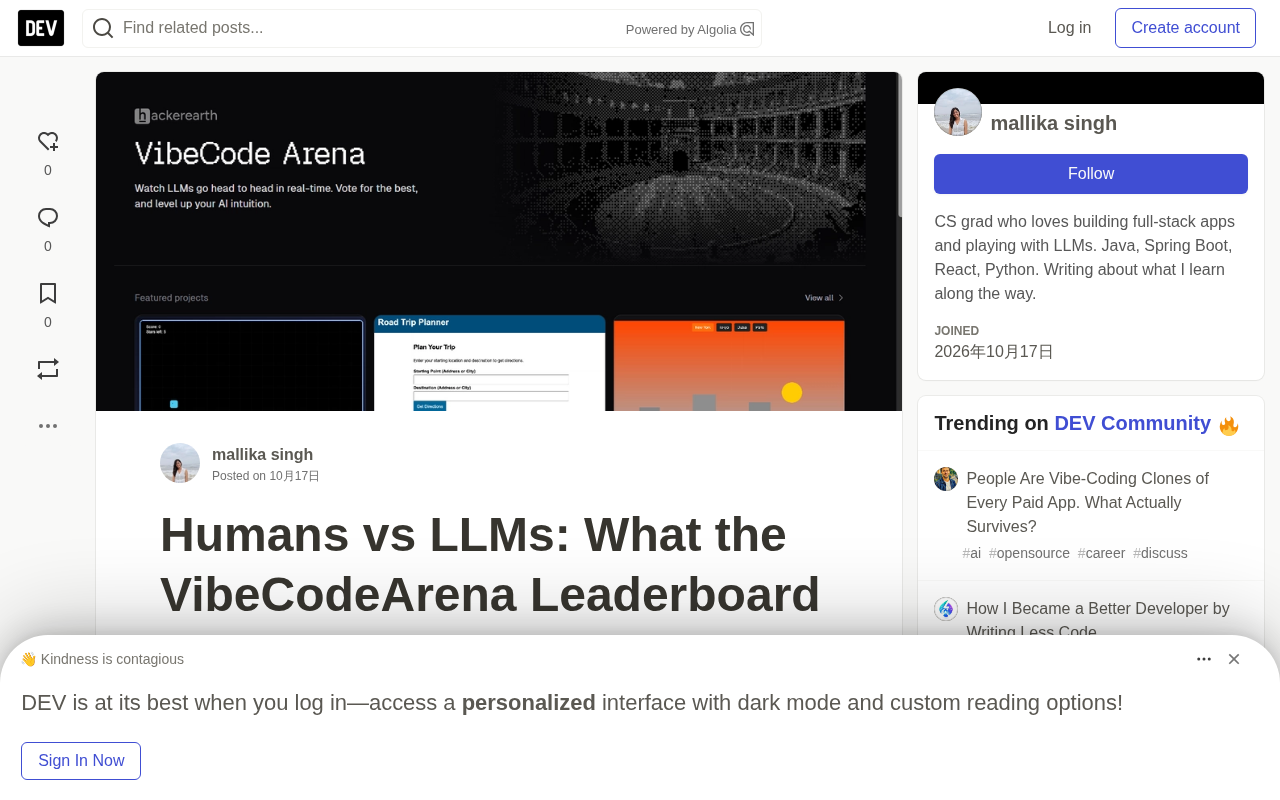
VibeCodeArena 是什么
每个挑战都从一个 AI 已经搭建好的应用开始。你点击 Challenge,进入沙盒,选择一个 LLM,然后通过提示词或直接改代码来改进这个应用。提交后,你的版本会被统一评估并参与投票。
因为所有提交都走同一套评估流程,最终模型和用户被放在同一个榜单里比较。榜单分为 All、Models、Users 三个标签页,每条记录包含五项数据:
- Eval score:来自评估的分数,涵盖安全性、代码质量、正确性、性能和可访问性
- Elo 评分:类似国际象棋的胜负分,赢则升、输则降
- Win % vs avg:击败平均水平的频率
- Confidence:Low / Medium / High,取决于背后有多少对战数据
- Trend:走势是上升还是下降
顾问观察到的快照里有 46 个模型和 100 个用户。正是这几列数据,构成了后面所有反直觉发现的来源。
Elo 评分源自国际象棋的评级系统,最初由物理学家 Arpad Elo 设计,用于根据对局胜负动态调整选手分数。其核心逻辑是:若高分选手战胜低分选手,分数增幅较小;反之若爆冷获胜,分数变动较大。在 LLM 竞技场中,Elo 通常通过模型两两匿名对战、由人类(或评判模型)投票选出更优回答来更新,因而能反映相对偏好而非绝对能力。
Win % vs avg 表示该模型或用户在所有对战中击败“平均水平”对手的频率,可理解为胜率指标。与 Elo 不同,它不依赖对手强弱加权,更直观但信息量较少。两者结合能更全面地评估表现:Elo 高但胜率低,可能说明只赢过强敌;Elo 低但胜率高,可能说明稳定性好但缺乏高端局验证。
评测高分≠排名第一
最让作者意外的是,Eval score 和最终排名并不同步。排行榜上,Claude 3.5 Sonnet 的评测分只有 87.5,却排在第 3 位;而 Claude Opus 5 评测分高达 94.0,只能排在第 4。一个 Llama-4-Maverick 条目拿到 91.3 分,却掉到了第 9 名。
排名第一的 DeepSeek广告-v4-Flash 评测分 95.3,Elo 1639,但它的 Confidence 标注为 Low。
原因在于 Elo 来自两两对战的结果,更接近人类在并排比较两个应用时的真实偏好。一个模型可以在指标上表现优异,却在正面对决中落败——因为应用"感觉不对",或者没真正理解提示词的要求。
作者在具体挑战里也看到了同样的现象:Metrics 标签页里有一个应用整体得分 94%,却仍然存在 36 个重大正确性问题。数字有用,但必须往下看一层。
Eval score 通常由自动化评估管道生成,涵盖安全性、代码质量、正确性、性能和可访问性等维度,每个维度按规则或静态分析打分后加权汇总。这种评估擅长捕捉硬性违规(如安全漏洞、语法错误),但难以量化“应用是否真正理解用户意图”或“交互体验是否自然”。因此,Eval score 高只代表在预设检查项上表现好,不代表在人类并排对比中更受青睐——后者正是 Elo 所衡量的。
Confidence(置信度) 反映评分背后的对战数据量。Low 表示样本少,排名波动大;High 表示经过大量对局验证,结果更稳定。平台通常设置阈值:对局数低于某值标 Low,中等标 Medium,超过阈值标 High。读榜时若忽略置信度,可能被偶然的高分误导。
人类用户为何能压过最强模型
这是作者最喜欢的一个发现。Users 标签页里,头部用户的评测分在 99.5 左右,Elo 在 1641 到 1642 之间。对比最强的模型 DeepSeek-v4-Flash(95.3 评测分、1639 Elo),人类用户不仅不落下风,在 All 合并榜单里甚至紧挨着、部分还高过最好的模型。
关键区别在于:用户的提交不是"人类单挑 AI",而是"人类带着 AI 一起干"。用户从模型搭好的版本出发,读指标,找出哪里坏了,然后把模型往正确方向推。这种组合打赢了模型单干。
这印证了作者在实际工作中的体感:LLM 写代码极快,但总得有人发现问题、把问题讲清楚,并验证修复是否真的生效。
人机组合(Human-AI teaming) 指人类用户以模型生成的初版应用为起点,通过阅读评估指标、定位缺陷、修改提示词或直接编辑代码来迭代改进。这种方式融合了模型的生成速度与人类的判断力:模型快速产出可运行代码,人类负责验证正确性、理解需求边界、发现模型遗漏的规则。排行榜上用户条目本质是“人类+所选模型”的协作成果,因此能超越模型单干的表现。
这种协作模式在软件工程中被称为“AI 辅助开发循环”:生成→评估→修复→验证。关键在于人类不能盲目信任模型输出,而需建立反馈闭环,把评估器指出的问题转化为具体修改指令,并重新验证修复效果。
别只看排名:置信度和趋势同样关键
榜单上不少条目是 Low confidence,包括排名第一的模型。这意味着该评分背后的数据量还不足,排名可能大幅波动。反过来,一些排名靠后的模型因为对战次数更多,反而拿到了 High confidence。
所以正确的读榜方式是看三样东西:排名、置信度、趋势。一个 High confidence 且趋势向上的模型,比一个挂在榜首但 Low confidence 的模型更有参考价值。
快不等于对
作者在沙盒里高频使用 DeepSeek V4 Flash,响应确实快。但快速回复只有在修复方向正确时才有价值。一个几秒就给出答案却改错地方的模型,比一个慢一点但一次改对的模型更浪费时间。
这也解释了榜单为什么要把这么多维度混在一起:快、正确、代码干净、真正贴合提示词,是四种不同的能力。
排行榜如何改变了作者的提示词习惯
从这些观察出发,作者调整了自己的工作方式:
- 先读 Metrics 再写提示词——重大 issue 指明了该从哪里下手
- 先保正确性,再谈外观——再漂亮但违反提示词规则的应用也会输
- 重读原始提示词——像"余额不足时不能扣款"这种小规则,恰恰是模型容易漏、评估器一定会抓的地方
- 不再轻信"已修复"——每次都回到 Preview 重新验证
- 把模型当成手快的队友,而不是神谕——给清晰指令,然后审查它的产出
这对开发者意味着什么
在这之前,作者基本把 LLM 排行榜当作营销材料。实际参与平台工作、盯着数字看了几天之后,这个看法被改变了。榜单上最有意思的不是谁排第一,而是最好的结果来自人与模型的协作。
对学生和初级开发者来说,这是个相当积极的信号:AI 并没有让你的技能贬值,而是让调试、读需求、把问题讲清楚这些能力变得更值钱。
顺带一提,读这类榜单时,置信度和趋势提供的信号,往往比那个光鲜的名次更诚实。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。