VideoLVR:用潜视觉推理破解视频理解中的视觉遗忘难题
VideoLVR 用紧凑潜视觉证据替代文本坐标与帧重插入,缓解视频推理中的视觉遗忘。
文章介绍了 VideoLVR 这一视频推理方法,针对多模态大模型用自然语言写推理链时逐渐“忘记”画面的视觉遗忘问题。现有两条路线各有缺陷:文本坐标只给位置符号、不携带视觉内容;重插入裁剪图或关键帧虽保住细节,却导致上下文膨胀与推理成本上升。VideoLVR 的做法是在相关视频时刻从局部区域构建紧凑的潜视觉证据,让模型在文本 token 与潜视觉状态之间交错推理,并可整合不同时刻的证据。方法将视觉 token 重建表述为在输入视频派生词表上的预测,与文本生成统一进同一 token 预测框架,还可扩展到强化学习,把视觉 token 视为动作、以最终答案奖励联合优化。实验显示其在多项视频基准上有效,细粒度视觉证据任务收益尤为明显。
多模态大模型在视频理解任务中已经能给出流畅的推理链条,但一条隐忧始终存在:当模型用自然语言写下推理步骤时,它其实正在逐渐"忘记"画面里真正发生了什么。论文 VideoLVR: Latent Visual Reasoning over Grounded Video Evidence 针对的正是这一核心矛盾——语言推理轨迹无法可靠地让模型回看视觉证据,导致视觉遗忘(visual forgetting),细粒度理解能力因此受损。
现有方案的两难:符号坐标 vs 上下文膨胀
要让模型在推理过程中保持对画面的"注意力",已有工作大致走了两条路。
第一条是文本坐标路线:用文字描述证据位置,例如给出时间戳或区域坐标。这种做法的问题在于,坐标只是符号化的位置标记,并不携带视觉内容本身——模型知道"该看哪里",却未必真正"看到"了什么。
第二条是重插入路线:把裁剪后的区域或关键帧重新塞回多模态上下文。视觉细节确实保住了,代价是上下文长度显著扩张,推理成本随之上升。两条路各有取舍,却都没有同时解决"看得见"和"看得省"的问题。
VideoLVR 的核心思路:把局部证据变成潜视觉状态
VideoLVR 提出的方案是在相关视频时刻从局部区域构建潜视觉证据(latent visual evidence),为中间推理步骤提供视觉支撑。与文本坐标不同,这些潜状态直接由画面内容编码而来,保留了视觉信息;与重插入整帧或裁剪图不同,它们以紧凑的潜表示形式存在,不会让上下文大幅膨胀。
按论文的表述,模型因此在推理时能够在交错的文本 token 与潜视觉状态之间切换,并把来自不同时刻的证据整合起来。这相当于给推理链条装上了可随时调取的"视觉记忆",而不是让模型凭文字描述去想象画面。
潜空间(latent space)与潜表示:在多模态模型中,视觉编码器(如 ViT)会把图像块或视频帧映射为一组连续向量,这组向量所处的维度空间即“潜空间”。与人类可读的文本 token 不同,潜向量不直接对应任何词或符号,而是以分布式方式编码颜色、纹理、形状、运动等视觉属性。所谓“潜视觉证据”,就是在这类连续表示空间中保留下来的一段局部视觉特征,它既可以被后续 Transformer 层像 token 一样读取,又不必展开成自然语言描述。正因为绕过了“视觉→文字”的翻译环节,潜表示能避免描述过程中的信息丢失,同时其长度远小于重插入原始帧或裁剪图块,从而在“保真”和“省上下文”之间取得折中。理解这一点,是理解 VideoLVR 为何优于文本坐标与重插入两条路线的关键。
统一 token 预测框架:视觉重建与文本生成共用一套目标
一个关键设计是视觉 token 预测目标。VideoLVR 把视觉 token 的重建形式化为"在由输入视频派生出的词表上做预测",从而将视觉证据重建与文本生成统一进同一个 token 预测框架。
这个统一带来两个好处。其一是监督信号自然对齐:潜视觉证据的生成不再是游离于语言建模之外的任务,而是与文本预测共享同一套机制。其二是结构上的简洁:模型无需为视觉证据单独设计一套解码路径,交错推理在单一框架内即可完成。
视觉 token 与派生词表:要让视觉证据进入语言模型的 token 预测框架,通常需要先把连续视觉特征“离散化”。常见做法是借助 VQ-VAE 或 VQ-GAN 这类向量量化器,维护一个码本(codebook),把每个视觉特征向量映射到码本中最近的条目,从而得到离散的视觉 token。VideoLVR 所说的“由输入视频派生出的词表”,指的是针对当前视频构建或选取的一组视觉 token 集合,模型在其中做分类预测,形式上和预测下一个文本词完全一致。这样一来,交叉熵损失可以同时作用于文本 token 和视觉 token,视觉重建不再是独立的辅助任务,而是与语言建模共享同一套输出头与训练目标,这也是“统一 token 预测框架”在工程上得以简洁实现的基础。
扩展到强化学习:视觉 token 当作动作来优化
论文进一步把 VideoLVR 延伸到强化学习场景:采样得到的视觉 token 与文本 token 一样被视为动作,策略以最终答案的奖励进行联合优化。这意味着模型不只是被"教"着生成有用的视觉证据,还会根据任务成败来调整"看什么、何时看"的决策。对于需要多步定位证据的视频任务,这种端到端的奖励驱动优化比纯粹的监督学习更贴近实际使用目标。
将生成视为动作的强化学习范式:在序列生成任务中,把每一步生成的 token 视为动作、把完整输出视为轨迹,是强化学习与大模型结合的常见做法(如 RLHF 中的策略优化)。VideoLVR 的特别之处在于,动作空间同时包含文本 token 和视觉 token,策略网络需要学习“何时插入视觉证据、从哪个时刻取、取哪块区域”。由于视觉证据的“好坏”很难用逐 token 的监督标签刻画,用最终答案的正确性作为奖励信号进行策略梯度优化(如 REINFORCE 类算法)就成为一种自然选择:模型通过试错来发现哪些视觉取证行为真正有助于答对问题,而不仅仅是模仿训练数据中的标注轨迹。
效果与意义:细粒度任务上的优势更明显
论文在多组视频基准上验证了方法的有效性,并特别指出在需要细粒度视觉证据的任务上收益更为突出。这与方法设计的直觉一致——当推理步骤需要反复核对画面细节时,潜视觉证据的价值最大;而对于主要依赖语义概括的任务,提升空间相对有限。
从更宏观的视角看,VideoLVR 触及的是多模态推理的一个基础问题:推理的中间状态是否必须是自然语言。当证据本身是视觉的,让它以视觉形式参与推理,或许比强行翻译成文字更符合任务本质。这一思路是否能推广到更长视频、更复杂的多跳推理,仍是值得关注的方向。
常见问题
VideoLVR 与直接插入视频帧有何区别? 直接插入帧会显著扩大上下文,而 VideoLVR 构建的是紧凑的潜视觉证据,在保留细节的同时控制上下文开销。
潜视觉证据如何被监督? 通过视觉 token 预测目标,把视觉 token 重建表述为在输入视频派生词表上的预测,与文本生成共享同一框架。
是否支持强化学习训练? 支持。论文将采样的视觉 token 视为动作,与文本 token 一起用最终答案奖励联合优化策略。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
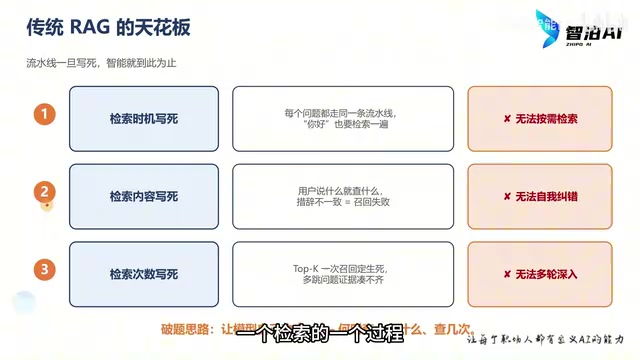
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
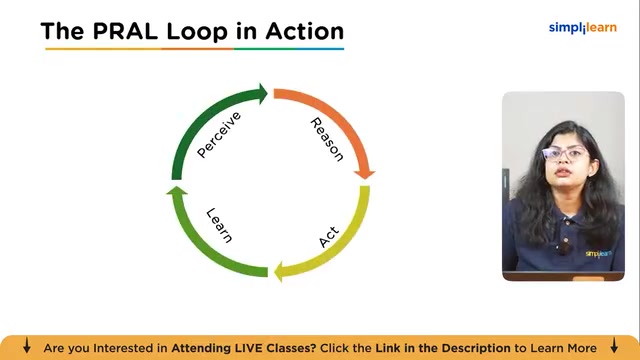
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。