VLA推理该信几分?Q-自适应引导拿下Waymo新SOTA
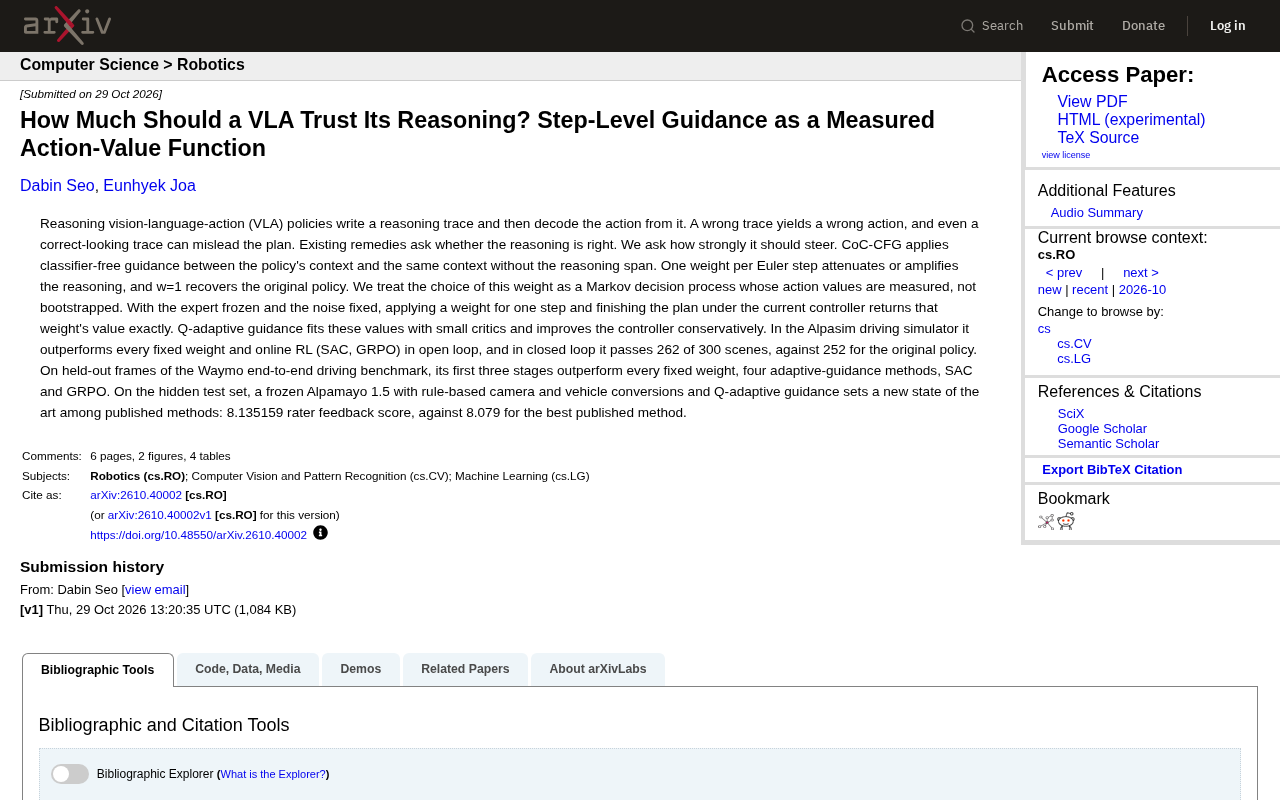
将VLA推理引导权重建模为MDP并直接测量动作价值,实现步级自适应引导。
文章介绍了一项关于视觉-语言-动作(VLA)模型推理引导的新研究。传统思路把推理质量当作二值判断,而该论文转而追问“推理应以多大力度的介入动作”。作者采用 CoC-CFG,在同一上下文下分别用带推理与不带推理的策略做无分类器引导,每个 Euler 步设置一个权重,并把权重选择建模为马尔可夫决策过程。与常见强化学习不同,动作价值通过冻结专家策略、固定噪声后完整 rollout 直接测量,而非 bootstrapping 估计,从而规避价值高估与训练不稳定,小型 critic 即可拟合。实验上,该方法在 Alpasim 仿真开环与闭环(300 场景通过 262 个,原始策略 252 个)均领先,并在 Waymo 端到端基准隐藏测试集取得 8.135159 的 SOTA 评分。文章认为,推理增强的 VLA 需要一个可调节的“信任旋钮”,“如何用推理”与“推理本身”同等重要。
视觉-语言-动作(VLA)模型正在成为自动驾驶和机器人控制的主流范式。这类模型通常会先写出一段推理轨迹,再基于这段轨迹解码出具体动作。但一个棘手的问题随之而来:推理轨迹一旦出错,动作必然出错;即使推理看起来正确,也可能把规划带偏。
现有研究大多在问“推理对不对”,而一篇新论文换了个问法——“推理应该以多大的力度影响动作”。这项工作提出 Q-adaptive guidance,把引导权重的选择建模为马尔可夫决策过程,并用可精确测量的动作价值函数来拟合,在 Alpasim 仿真和 Waymo 端到端驾驶基准上都取得了领先结果。
问题重构:从“推理是否正确”到“推理该多强”
传统思路把推理质量当作二值判断:推理正确就采纳,错误就丢弃。但论文指出,即便推理轨迹表面上看是对的,它也可能在细节上误导后续规划。真正需要控制的是推理对最终动作的介入程度。
作者采用的方法叫 CoC-CFG,即在同一上下文下,分别用带推理片段和不带推理片段的策略做无分类器引导(classifier-free guidance)。每个 Euler 步设置一个权重,用来衰减或放大推理的影响。权重 w=1 时退化为原始策略,因此这个框架天然包含了“完全不引导”的基线。
关键洞察在于:这个权重不该是一个固定超参数,而应该随步、随场景动态调整。
无分类器引导(Classifier-Free Guidance, CFG) 最早在扩散生成模型中流行:训练时随机丢弃条件信息,让模型同时学会“有条件”和“无条件”两种分布;推理时把两者的预测做外推组合 ε = ε_uncond + w·(ε_cond − ε_uncond),权重 w 控制条件信号相对于无条件先验的放大倍数。w=1 等价于纯条件模型,w>1 会强化条件一致性但可能牺牲多样性。CoC-CFG 把这一思路迁移到 VLA 的动作解码:条件不是类别标签而是推理轨迹片段,无条件分支即“只看上下文、不看推理”,于是引导权重自然成为“推理介入强度”的旋钮。
把权重选择变成可测量的MDP
论文将每一步的权重选择建模为马尔可夫决策过程,但动作价值不是靠 bootstrapping 估计,而是直接测量得到。具体做法是:冻结专家策略、固定噪声,在某个步骤施加一个权重,然后用当前控制器把剩余规划走完,这样就能精确得到该权重的真实价值。
有了精确的价值标签,Q-adaptive guidance 用小型 critic 网络拟合这些价值,并以保守的方式改进控制器。这种“测量而非估计”的设计回避了强化学习中常见的价值高估和训练不稳定问题,也让小模型足以胜任。
bootstrapping(自举估计) 是主流强化学习估计动作价值的做法:用下一步状态的估计价值 V(s') 或 Q(s',a') 来构造当前步的目标值,再逐步反向传播。它无需走完整个回合,样本效率高,但误差会沿时间步递归累积,配合函数逼近容易产生高估(如 DQN 中的 max 算子偏差)和训练不稳定。本文反其道而行:在每个 Euler 步施加候选权重后,用冻结的控制器把剩余规划真正走完,直接拿到该权重的回报作为标签。代价是每个候选权重都要一次完整 rollout,但换来了无偏、方差可控的价值标签,使得一个小型 critic 就足以拟合,也绕开了 bootstrapping 的固有偏差。
实验结果:开环闭环双线领先
在 Alpasim 驾驶仿真器中,Q-adaptive guidance 在开环设置下优于所有固定权重方案以及在线强化学习方法(SAC、GRPO)。闭环测试中,它在 300 个场景里通过 262 个,而原始策略通过 252 个,提升幅度明确。
在 Waymo 端到端驾驶基准的留出帧上,该方法的前三个阶段同样优于所有固定权重、四种自适应引导方法以及 SAC 和 GRPO。更具说服力的是隐藏测试集上的表现:冻结的 Alpamayo 1.5 配合基于规则的相机与车辆转换,再加上 Q-adaptive guidance,在已发表方法中取得新的 state of the art,评分反馈得分为 8.135159,而此前最佳已发表方法为 8.079。
开环与闭环评测在自动驾驶中衡量的是不同东西。开环评测把模型预测的轨迹与数据集里人类驾驶员的轨迹逐点比较(如位移误差、碰撞率),计算便宜、可复现,但存在“因果混淆”:模型可能只是复现了记录轨迹,并未真正响应自身动作引发的状态变化。闭环评测则让模型在仿真器里真正驾驶,动作会改变后续观测,能暴露累积误差与分布漂移,但依赖仿真器的保真度。本文同时报告两类结果,并用 Alpasim 的 300 场景闭环通过率佐证开环领先并非过拟合记录数据,这一双线设计增强了结论的可信度。
这项工作意味着什么
第一,推理增强的 VLA 系统需要一个可调节的“信任旋钮”,而不是全有或全无的开关。步级权重提供了一种细粒度控制手段,让模型在推理可靠时多依赖推理、在推理可疑时退回上下文本身。
第二,将引导权重选择形式化为 MDP 并测量动作价值,是一条兼顾理论清晰度和工程可行性的路径。相比端到端 RL 训练整个策略,只学习一个小型 critic 显然更省算力、更易收敛。
第三,结果说明“如何用推理”与“推理本身”同等重要。对于自动驾驶这类安全敏感场景,可控的推理介入机制可能比单纯提升推理能力更早带来实际收益。
论文尚未披露权重调节在极端场景下的失效模式,以及 critic 在分布外场景的泛化表现,这些仍是后续值得关注的方向。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。