vLLM 部署 Kimi K3 吞吐量提升 2.2–2.8 倍:性能优化拆解
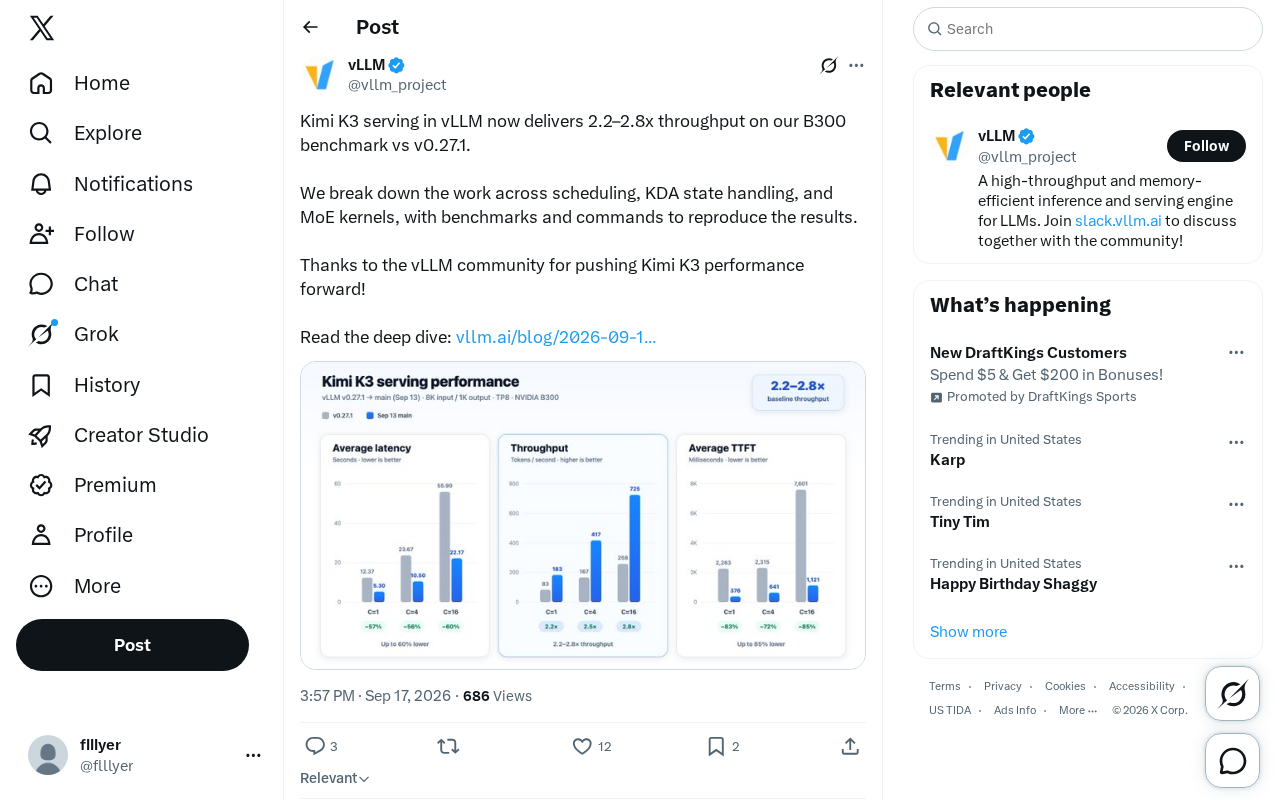
Kimi K3在vLLM上通过调度、状态处理与MoE内核三项协同优化,实现B300基准下2.2–2.8倍吞吐提升。
Kimi K3 在 vLLM 推理框架上完成了一次系统性性能升级,相较于 v0.27.1 版本,在 NVIDIA B300 硬件基准测试中实现了 2.2 到 2.8 倍的吞吐量提升。这一成果由三个方向的协同优化驱动:调度层针对高并发场景的请求编排效率进行了深度调优;KDA 状态处理层通过重构状态读写路径,降低了长序列与多轮对话场景中的内存拷贝与同步开销;MoE 内核层则专门优化了混合专家架构中的专家分发、负载均衡与 GPU 算子调度。官方同步提供了完整的基准复现命令,保证了结果的可验证性。对于关注推理成本与并发能力的部署团队,此次优化提供了在相同硬件预算下服务更多用户的具体路径,也再次彰显了 vLLM 开源社区在大模型基础设施演进中的核心作用。
一次显著的推理性能跃升
Kimi K3 在 vLLM 上的部署迎来一次值得关注的性能升级。根据官方在 B300 基准测试上的数据,相较于 v0.27.1 版本,新的优化方案在吞吐量上实现了 2.2 到 2.8 倍的提升。对于大规模模型推理服务而言,这种量级的改进直接意味着更低的单位推理成本和更高的并发处理能力。
这一成果并非来自单点突破,而是围绕三个关键环节展开的系统性工程:调度(scheduling)、KDA 状态处理(KDA state handling)以及 MoE 内核(MoE kernels)。官方也特别感谢了 vLLM 社区在推动 Kimi K3 性能演进方面的贡献,体现出这是开源协作的产物。
优化的三个核心方向
调度层:更高效的请求编排
调度是推理服务性能的第一道关口。在高并发场景下,如何合理编排请求批次、平衡延迟与吞吐,直接决定了硬件资源的利用率。vLLM 长期以其连续批处理(continuous batching)机制著称,而针对 Kimi K3 的调度优化,进一步压榨了在 B300 这类高端加速卡上的调度效率,减少了空闲等待与资源碎片。
连续批处理(Continuous Batching)是 vLLM 的核心调度机制,区别于传统的静态批处理(Static Batching)。静态批处理要求一批请求全部完成后才能加入新请求,导致已完成推理的 GPU 算力在等待中浪费;连续批处理则允许在每个解码步骤(decoding step)后动态插入新请求,使 GPU 利用率接近饱和。然而在极高并发或请求序列长度差异显著时,调度器仍面临"长尾请求阻塞短请求"的优先级问题,以及 KV Cache 内存分配碎片化的挑战。针对 B300 硬件的调度优化,可能涉及对批次组装策略(batch packing)和抢占式调度(preemption)的精细调整,以匹配该硬件更高的内存带宽与计算密度特性。
KDA 状态处理:降低状态管理开销
KDA(Kimi 相关的注意力/状态机制)的状态处理是本次优化的另一重点。在长序列与多轮对话场景中,状态的读写和维护往往成为隐性瓶颈。通过重构状态处理路径,减少不必要的内存拷贝与同步开销,能够在保证正确性的前提下提升整体吞吐。这类底层优化通常不易被用户直接感知,却是性能提升曲线中不可或缺的一环。
MoE 内核:混合专家模型的计算加速
Kimi K3 采用了混合专家(MoE)架构,这意味着每次前向推理只激活部分专家网络。MoE 的路由与专家计算对内核实现极为敏感——专家分发、负载均衡、以及 GPU 上的高效算子调度都会显著影响最终性能。针对 MoE 内核的专门优化,是本次实现倍数级吞吐提升的关键驱动力之一。
混合专家(Mixture of Experts,MoE)架构的核心是路由机制(Router):每个输入 Token 由一个轻量路由网络决定激活哪几位"专家"(通常为 Top-K 选择),其余专家的参数在该次前向计算中完全跳过。这带来了参数量与实际计算量的解耦——模型总参数可以极大,但单次推理的浮点计算量(FLOPs)维持在较低水平。然而 MoE 的工程挑战在于:被路由到不同专家的 Token 需要在 GPU 上进行"分发-聚合"(dispatch-gather)操作,这是一种不规则的内存访问模式,对 GPU 的算子实现极为敏感。专家间负载不均衡(某些专家过热、某些专家空闲)也会拖累整体利用率,因此高效的 MoE 内核需要同时解决计算规整化和负载均衡两个问题。
可复现的基准测试
值得肯定的是,官方并未止步于展示漂亮的数字,而是提供了完整的基准测试方法和复现命令。这种透明的做法在业界并不总是常态,它让第三方开发者和团队可以在自己的环境中验证结果,而非仅凭厂商单方面声明。
这里也需要保持理性:2.2–2.8 倍的提升是在特定的 B300 硬件与特定基准负载下取得的。实际收益会因模型配置、请求分布、序列长度和硬件型号而异。对于计划部署 Kimi K3 的团队来说,参考官方给出的复现步骤在自身工作负载下实测,才能得到最贴近生产环境的判断。
B300 是 NVIDIA Blackwell 架构的服务器级加速卡,相较于上一代 H100/H800,其显存容量、内存带宽和 FP8 计算吞吐均有显著提升,尤其针对大规模 MoE 模型的推理场景具备更强的硬件适配性。在该类高端硬件上进行基准测试时,通常以"每秒输出 Token 数"(Output Tokens per Second)或"每秒处理请求数"(Requests per Second)作为吞吐指标,并辅以首 Token 延迟(TTFT)和逐 Token 延迟(TPOT)来评估响应速度。由于 B300 的硬件特性与 H100 存在差异,针对 B300 调优的内核和调度策略未必能在其他硬件上产生相同幅度的收益,这也是官方特别标注"B300 基准"的重要背景。
对开发者与部署方的意义
对于依赖大模型推理服务的团队,这类优化的价值是直接的。吞吐量翻倍意味着在相同硬件预算下可以服务更多用户,或在相同负载下削减硬件投入。在推理成本仍是大模型商业化核心挑战的当下,vLLM 与 Kimi K3 的这次协作提供了一个具体的降本样本。
从生态角度看,这也再次印证了 vLLM 作为主流开源推理框架的地位。围绕特定模型(如 Kimi K3)进行深度调优、并将成果回馈社区的模式,正在成为大模型基础设施迭代的常态。对于选型推理框架的工程团队而言,框架背后活跃的社区与持续的模型适配能力,往往比一时的峰值性能更值得权衡。
小结
这次 Kimi K3 在 vLLM 上的性能升级,是调度、状态处理与 MoE 内核三方面协同优化的结果,在 B300 基准上带来了 2.2–2.8 倍的吞吐提升,并附带了可复现的测试方法。对于关注推理效率与部署成本的开发者,这是一个值得深入阅读官方技术拆解的案例。感兴趣的读者可以查阅官方发布的深度解析获取完整细节。
相关推荐
AI玩转《宝可梦红》:Jev仅花2美元通关两个道馆
一位Reddit用户让AI模型Jev实时游玩《宝可梦红》,harness由Opus 5同步搭建,仅花不到2美元就击败两个道馆,展现了低成本AI智能体的潜力。
20-30人小团队如何选对多智能体AI平台?
20-30人的初创团队如何在数十款多智能体AI平台中选对工具?本文基于Reddit真实讨论,分析中小团队的选型痛点,并给出从高频场景切入、关注留存意愿等实用建议。
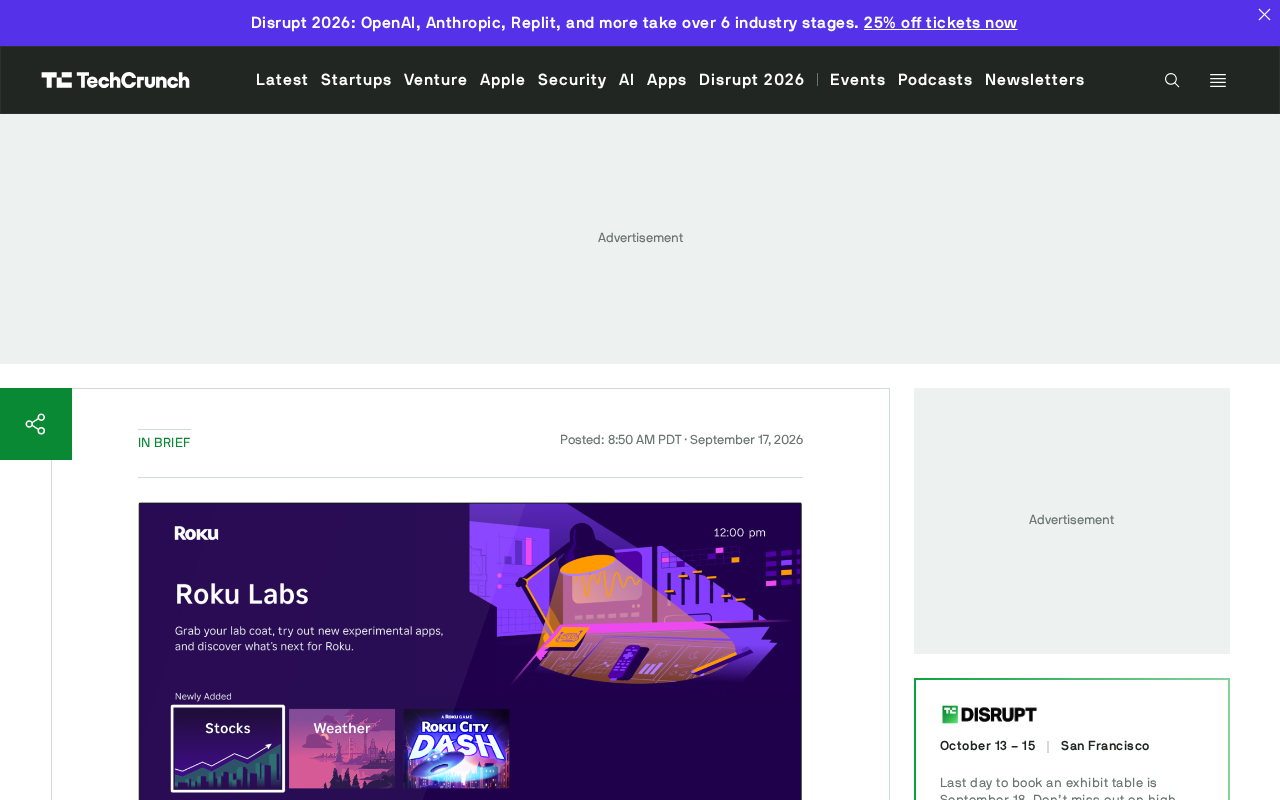
Roku Labs 上线:实验性应用登陆大屏幕
Roku 最新 OS 更新推出 Roku Labs 实验性应用入口,同时扩展个性化主屏市场覆盖并引入流媒体订阅捆绑功能,进一步强化其智能电视软件生态。