vLLM Hybrid HiSparse:稀疏MLA破解长上下文显存瓶颈
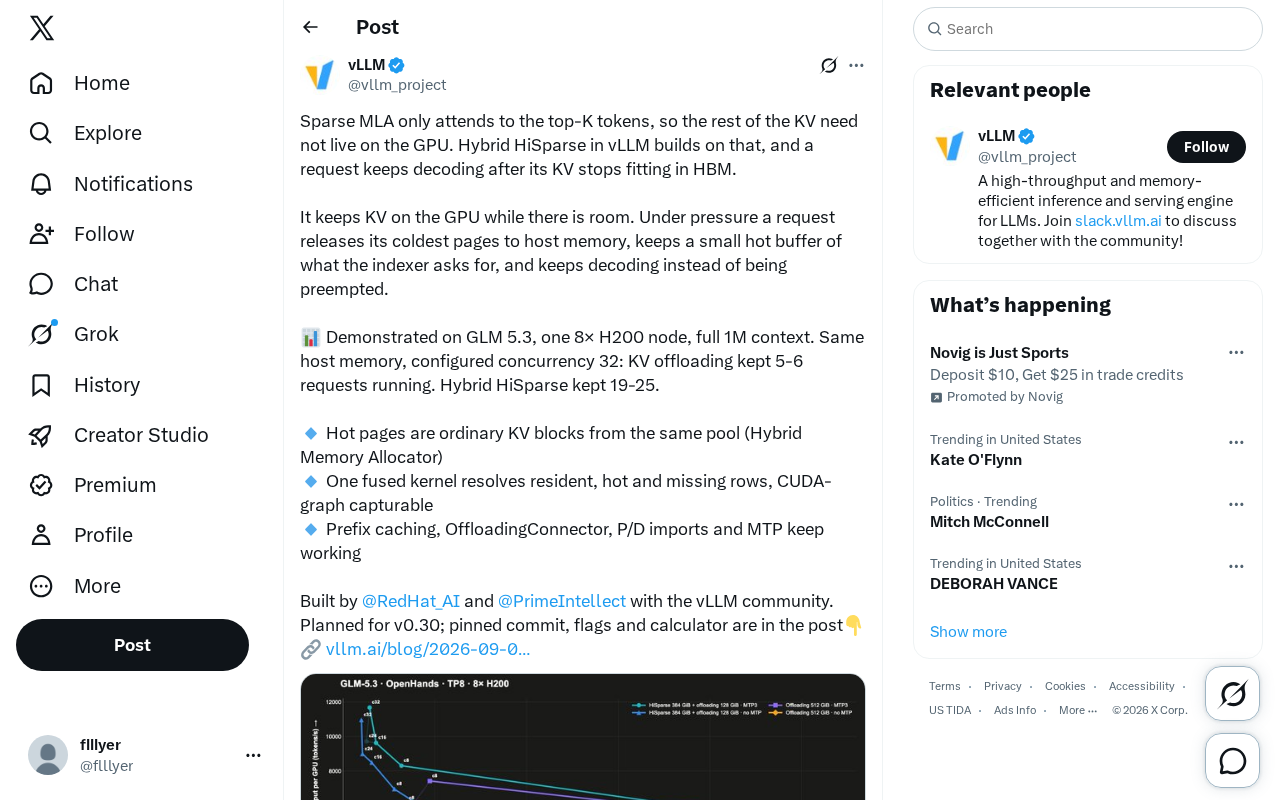
vLLM新方案Hybrid HiSparse结合稀疏MLA与分级内存,在不增加硬件的情况下将百万上下文并发数提升3-4倍。
大模型处理百万级长上下文时,KV Cache的显存占用往往成为并发瓶颈,传统做法是在显存不足时强制中断(抢占)请求。vLLM社区推出的Hybrid HiSparse方案通过两项关键技术的结合解决了这一问题:稀疏MLA使模型解码时只需访问top-K个最相关的token,其余KV数据可安全下放至主机内存;分级内存调度则在显存紧张时自动将「冷」页面迁移到CPU DRAM,同时维持热缓冲区供稀疏索引器按需调取,让请求持续解码而非被抢占。在GLM 5.3模型、8×H200节点、100万上下文的实测中,相同硬件条件下有效并发请求数从传统KV offloading的5-6个提升至19-25个。该方案兼容前缀缓存、CUDA图捕获等现有vLLM特性,由Red Hat AI与Prime Intellect联合开发,计划于v0.30版本正式发布。
长上下文推理的显存困局
大模型推理中,KV Cache(键值缓存)是决定并发能力的关键因素。随着上下文长度扩展到百万级别,KV Cache 占用的显存急剧膨胀,往往成为限制并发请求数的硬约束。传统做法是当显存(HBM)装不下时,直接抢占(preempt)请求,导致吞吐量骤降、用户体验受损。
vLLM 社区最新推出的 Hybrid HiSparse 方案,正是针对这一痛点提出的系统级优化。它建立在稀疏 MLA(Sparse Multi-head Latent Attention)的基础之上,让请求在 KV Cache 无法完全驻留于 HBM 后,依然能够持续解码,而不是被强制中断。
稀疏MLA的核心思想
稀疏 MLA 的设计前提很直接:注意力机制在解码时只关注 top-K 个最相关的 token,那么其余大量 token 的 KV 就没有必要一直占据宝贵的 GPU 显存。
这一观察为分级存储打开了空间。既然模型每一步只需要一小部分「热」数据,系统就可以把「冷」数据下沉到成本更低、容量更大的主机内存(host memory),仅在需要时再调入 GPU。这与传统的 KV offloading(全量下放)有本质区别——HiSparse 结合了稀疏索引,只保留真正被查询到的部分。
分级内存的运作机制
Hybrid HiSparse 的调度逻辑可以概括为三步:
- 有空间时:KV Cache 正常驻留在 GPU 上,走常规解码路径;
- 显存吃紧时:请求主动释放最「冷」的页面(coldest pages)到主机内存,同时保留一个小的热缓冲区(hot buffer),存放索引器(indexer)明确请求的数据;
- 持续解码:请求不再因为显存不足而被抢占,而是带着分级缓存继续推进。
这种「按需驻留」的策略,把显存从「必须全量容纳」的硬约束,转变为「弹性调度」的软资源。
MLA(Multi-head Latent Attention)是 DeepSeek 提出的注意力机制变体,其核心创新在于将 Key 和 Value 压缩为低秩的潜在向量(latent vector)进行缓存,相比标准多头注意力可将 KV Cache 体积压缩至原来的 5%-13%。这使得 MLA 天然适合长上下文场景。在此基础上,「稀疏」(Sparse)进一步将注意力计算限制在 top-K 个高相关性 token 上——实验表明,即便只保留全部 token 中一小部分进行计算,模型输出质量也几乎不受影响,因为注意力权重的分布本身就高度集中。这一特性为系统层面的分级内存调度提供了理论依据:既然模型计算本身只依赖少数「热」token,将其余 token 的 KV 数据下放到更慢的存储层并不会影响正确性,只会引入有限的数据搬运延迟。
这里的「页面」(page)概念沿袭自 vLLM 的 PagedAttention 设计——KV Cache 被切分为固定大小的内存块(block),每个块可以像操作系统内存页一样独立分配、迁移和回收。PagedAttention 的分页管理是 Hybrid HiSparse 实现分级调度的基础:正因为 KV 数据以离散块而非连续张量的形式存在,系统才能在不影响整体推理流程的前提下,把单个「冷块」从 GPU HBM 迁移到 CPU DRAM,并在需要时按页粒度重新加载。这种细粒度的内存管理让「弹性调度」在工程上成为可能。
实测数据:并发能力提升3到4倍
据发布方展示,该方案在 GLM 5.3 模型、单个 8× H200 节点、完整 100 万上下文 的配置下进行了验证。
在相同的主机内存、并发配置为 32 的条件下:
- 传统 KV offloading 仅能维持 5-6 个请求 运行;
- Hybrid HiSparse 则能同时保持 19-25 个请求 运行。
这意味着在不增加任何硬件成本的前提下,有效并发能力提升了大约 3 到 4 倍。对于需要处理超长文档、大规模上下文检索的生产环境而言,这样的提升直接转化为服务成本的显著下降。
工程实现的关键设计
Hybrid HiSparse 之所以能被顺利集成进 vLLM,得益于几个务实的工程决策:
复用现有内存池
热页面(hot pages)本质上就是来自同一内存池的普通 KV 块,由 Hybrid Memory Allocator 统一管理。这避免了引入独立的内存管理逻辑,降低了系统复杂度和维护成本。
融合内核与CUDA图兼容
方案通过**单个融合内核(fused kernel)**来一次性解析驻留(resident)、热(hot)和缺失(missing)三类数据行,并且这个内核是 CUDA-graph capturable 的。这一点尤为重要——CUDA 图捕获能力意味着该优化不会破坏 vLLM 现有的图执行加速路径,性能开销可控。
CUDA Graph(CUDA 图)是 NVIDIA 提供的一种执行优化技术,它将一系列 GPU kernel 调用及其依赖关系预先录制成计算图,在实际运行时直接重放,省去每次推理的 CPU 调度开销和 kernel 启动延迟。在大模型推理中,CUDA Graph 能显著降低小批量场景下的延迟。然而,凡是涉及动态内存访问模式的操作(例如条件分支、不定长数据检索)通常无法被 CUDA Graph 捕获,因为图捕获要求计算流在每次执行时保持结构固定。Hybrid HiSparse 的融合内核将三类数据(驻留、热、缺失)的处理逻辑合并为一次 kernel 调用,并且保证其访问模式在图捕获阶段是确定性的,从而绕开了这一限制,使优化方案得以与 vLLM 现有的图执行加速路径无缝共存。
生态兼容性
值得关注的是,Hybrid HiSparse 与 vLLM 的多项现有功能保持兼容,包括前缀缓存(Prefix caching)、OffloadingConnector、P/D 分离导入以及 MTP(多 token 预测)。这种「不破坏现有能力」的设计,大大降低了用户迁移和采用的门槛。
开源协作与落地路线
该项目由 Red Hat AI 与 Prime Intellect 联合 vLLM 社区共同构建,体现了开源大模型推理基础设施的协作模式。
根据规划,Hybrid HiSparse 计划在 vLLM v0.30 版本中正式发布。发布方在原帖中提供了固定的 commit 版本、启用标志(flags)以及一个用于估算的计算器工具,方便开发者提前测试和评估收益。
对行业的意义
Hybrid HiSparse 代表了一个明确的技术趋势:长上下文推理的瓶颈正从「模型能力」转向「系统调度」。当模型本身已经支持百万级上下文,如何在有限硬件上高效服务大量并发请求,成为决定实际可用性的关键。
通过稀疏注意力与分级内存的结合,vLLM 展示了一条不依赖更多显存、而靠更聪明的调度来扩展并发的路径。对于运营大模型推理服务的团队来说,这类优化的边际收益极高——同样的 H200 节点能服务更多用户,意味着更低的单位推理成本。随着 v0.30 的落地,这一能力有望成为长上下文场景的标准配置。
相关推荐
分布式系统经典论文导读:从入门到精通的必读清单
一份在 Hacker News 走红的分布式系统经典论文清单,涵盖共识算法、逻辑时钟、CAP 定理等核心主题,为工程师提供系统化的学习路径与理论到实践的桥梁。
Valve仍在权衡Steam Deck 2的推出时机
Valve完成Steam Controller、Steam Machine和Steam Frame三款2026硬件产品线后,Steam Deck 2仍无明确时间表。Valve设计师表示仍在权衡"如何以及何时"推出,坚持不为单纯性能提升而做续作。
"Dario, Please":一封写给Anthropic CEO的公开呼吁引发热议
《Dario, Please》一文在Hacker News引发热议,累计247分与122条评论。这封写给Anthropic CEO Dario Amodei的公开呼吁,折射出AI社区对头部大模型公司决策方向的持续关切与话语生态变化。