vLLM v0.31.0rc1 发布:优化 CUDA 12.x 镜像构建流程

vLLM发布v0.31.0rc1,核心为跳过CUDA 12.x镜像构建中的snapshot runtime步骤,属CI工程优化类更新。
vLLM v0.31.0rc1 是一次聚焦于 CI/构建流程的工程维护型候选发布版本。其核心改动(提交 #59118)是在 CUDA 12.x 系列镜像构建中跳过 snapshot runtime 环节,以减少构建耗时、降低环境差异引发的失败风险。该提交通过 cherry-pick 方式从主分支合入发布分支,遵循成熟的版本管理实践。值得关注的是,提交署名中出现了 Claude Opus 5.5 的协作信息,体现 AI 编程助手正深度参与开源基础设施的日常开发。vLLM 坐拥约 9.29 万 Star,任何发布都影响大量下游用户,因此构建流程的持续打磨具有实际意义。生产环境用户建议在测试环境验证后,等待 0.31.0 正式版再决策升级。
vLLM 项目发布了 v0.31.0rc1 版本(Release Candidate 1,候选发布版)。作为业界广泛采用的大语言模型推理与服务引擎,vLLM 每一次迭代都牵动着大量部署方的关注。本次候选版本的核心改动聚焦于 CI/构建流程的优化,属于工程侧的打磨性更新。
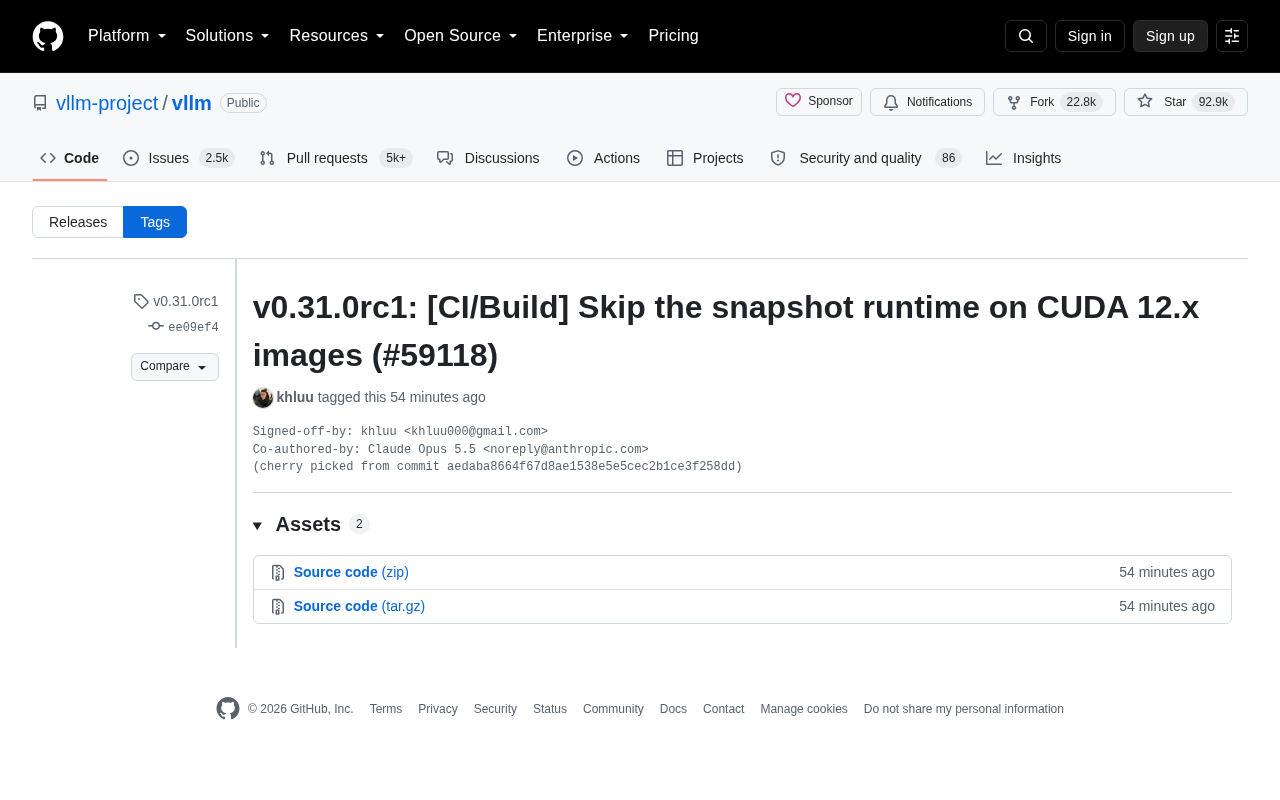
本次更新的核心改动
根据发布记录,v0.31.0rc1 的关键提交为 #59118,其内容是「Skip the snapshot runtime on CUDA 12.x images」——即在 CUDA 12.x 系列镜像的构建过程中跳过 snapshot runtime 环节。
这类改动看似细微,但对持续集成(CI)流水线的效率和稳定性有实际意义。构建 GPU 相关的容器镜像通常耗时较长,跳过在特定 CUDA 版本上不必要的 snapshot runtime 步骤,可以减少构建时间、降低因运行时环境差异导致的构建失败风险。对于 vLLM 这种需要同时维护多套 CUDA 版本镜像的项目而言,构建流程的每一处优化都会在长期累积中带来可观的收益。
值得关注的是,该提交的署名信息显示由维护者 khluu 提交,并标注了 Co-authored-by: Claude Opus 5.5 的协作署名。这从一个侧面反映出 AI 编程助手正在深度参与开源基础设施项目的日常开发工作。
Snapshot Runtime 是容器镜像构建流程中的一个环节,通常指在构建过程中对当前运行时环境状态进行快照记录,用于后续的一致性校验、缓存加速或回滚。在 GPU 相关镜像中,这一步骤往往涉及 CUDA 驱动版本探测、库依赖扫描等耗时操作。当某个特定 CUDA 版本(如 12.x)的运行时环境已足够稳定,或该快照步骤在该版本上存在兼容性问题时,跳过它既能缩短 CI 流水线耗时,也能规避潜在的构建中断风险。Cherry-pick 则是 Git 中将某个特定提交从一个分支"摘取"并应用到另一个分支的操作,常用于将主干上已验证的修复有选择地同步到发布分支,而不引入其他未经验证的变更。
为什么是 Release Candidate
v0.31.0rc1 中的 rc1 表示这是 0.31.0 正式版之前的第一个候选发布版本。发布候选版是开源项目常见的稳定性验证机制:在正式打标签之前,先向社区释放一个功能冻结、以修复为主的版本,供用户在真实环境中测试,暴露潜在问题。
从本次 rc 版本的改动性质来看,它主要是 CI/Build 层面的调整,并通过 cherry-pick(从主分支挑选特定提交,commit aedaba8)的方式合入。这意味着相关修复已经在主开发分支验证过,再被有选择地回合到发布分支,是较为成熟的版本管理实践。
vLLM 项目的社区体量
从项目页面数据可以看出 vLLM 的影响力:仓库获得约 9.29 万 Star、2.28 万 Fork。这一量级在开源推理引擎领域处于头部位置,也意味着任何一次发布——即便只是构建流程的微调——都可能影响到大量下游用户和企业部署。
正因如此,vLLM 对 CI/Build 的持续优化并非可有可无。庞大的用户基数要求发布流程必须高效、可靠,构建镜像的稳定性直接关系到用户能否顺利拉取和使用对应 CUDA 版本的运行环境。
vLLM 的核心技术优势在于其提出的 PagedAttention 机制——借鉴操作系统虚拟内存分页思想,将 KV Cache(推理过程中键值对缓存)以非连续内存块的方式进行管理,从而大幅提升 GPU 显存利用率,支持更高的并发吞吐量。这使 vLLM 在同等硬件条件下相比朴素推理实现可获得数倍的吞吐量提升,成为工业部署场景的首选引擎之一。正是这一技术影响力,使其庞大的用户基数对构建流程的稳定性极为敏感——CUDA 镜像的任何构建异常,都会直接阻碍下游用户的部署流水线。
对使用者的实际影响
对于普通用户而言,v0.31.0rc1 这样一个以构建流程优化为主的候选版本,通常不会引入面向功能层面的破坏性变更。但如果你的工作流依赖于 vLLM 官方发布的 CUDA 12.x 镜像,可以关注后续正式版本,验证镜像是否按预期正常构建与运行。
由于这是候选发布版而非正式版,生产环境用户建议保持谨慎:可在测试环境中试用,等待 0.31.0 正式版发布后再评估是否升级。开源项目的 rc 版本本身就是为了收集反馈,遇到问题及时向社区反馈也是一种有价值的参与方式。
小结
vLLM v0.31.0rc1 是一次典型的工程维护型发布,核心是对 CUDA 12.x 镜像构建流程的优化。虽然改动本身不涉及新特性,但它折射出两个趋势:一是头部开源推理引擎对工程质量的持续投入,二是 AI 编程助手(如 Claude)正越来越多地参与到真实开源项目的协作开发中。对于关注 LLM 推理部署的团队,持续跟踪 vLLM 的版本节奏,有助于第一时间获得性能与稳定性的改进。
相关推荐

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
AI代购时代来临:Shopify开放Agent结账,抢占万亿新市场
Shopify开放AI代理结账功能,允许Agent读取、更新并提交订单。本文解析AI代购时代的平台分化、结构化数据的重要性与agent-assisted安全机制,并给出商家应对策略。