vLLM v0.34.0rc0:Gemma与StableLM迁移至Transformers后端

vLLM v0.34.0rc0 将 Gemma 与 StableLM 迁移到 Transformers 后端以统一模型加载路径。
vLLM 发布 v0.34.0rc0 候选版本,核心改动是将 Gemma 和 StableLM 两个模型系列迁移到 Transformers 后端,合并请求编号为 #66393,由开发者 hmellor 提交并带有 GitHub 验证签名。文章分析认为,这一迁移属于“减少分叉、统一入口”式重构,目的是把模型定义与权重加载职责交还上游库,降低多模型维护成本,并让模型行为更贴近 Transformers 参考实现。同时提醒迁移可能带来量化配置或自定义算子路径的短期回归风险。对使用者而言,升级前应重点验证权重加载兼容性、输出数值一致性和显存吞吐表现,rc0 适合兼容性测试而非直接上生产。
一次版本发布背后的架构调整
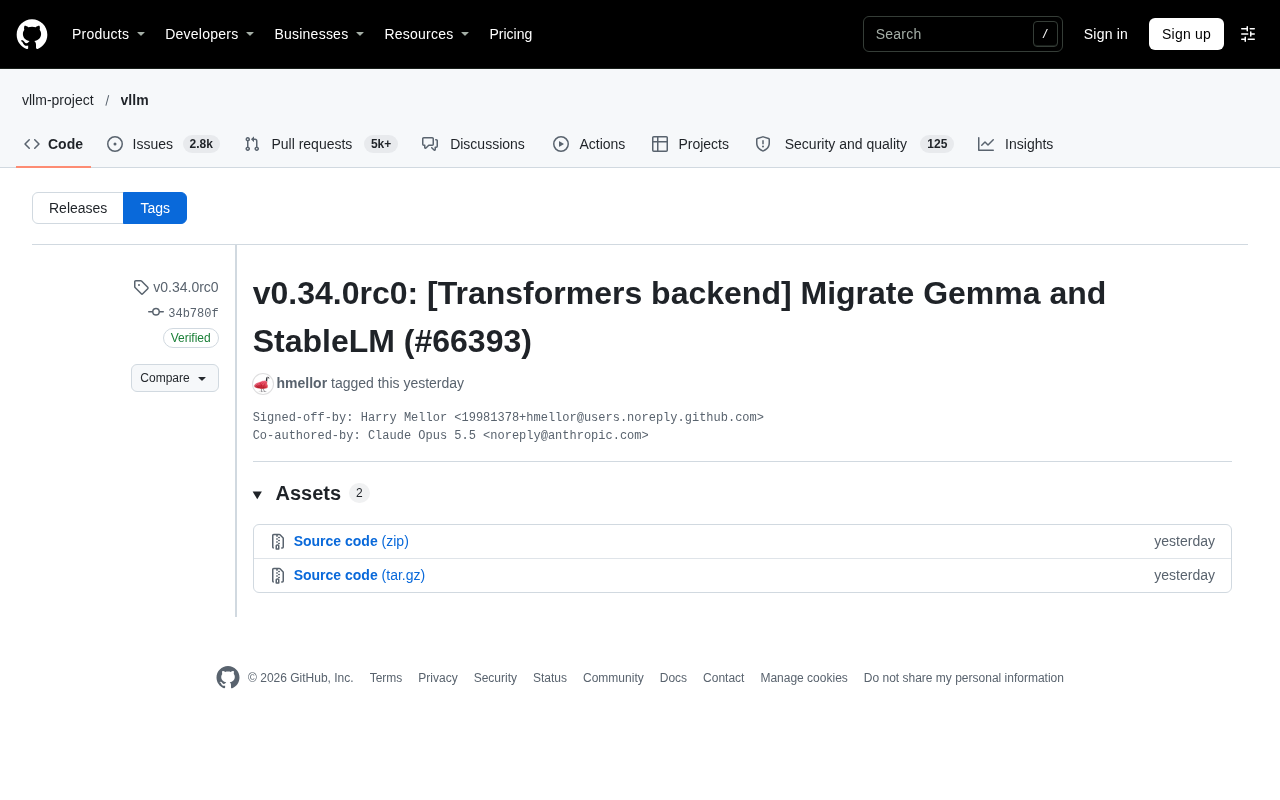
vLLM 发布了 v0.34.0rc0 预发布版本,本次更新的核心是一项后端迁移:将 Gemma 和 StableLM 两个模型系列迁移到 Transformers 后端。这一改动由开发者 hmellor 提交,提交信息中明确记录了合并请求编号 #66393,并且提交已通过 GitHub 验证签名。
从工程视角看,这类迁移通常意味着模型实现从专用代码路径切换到统一的后端框架,属于典型的“减少分叉、统一入口”式重构。对于关注 vLLM 部署实践的用户,版本号中的 rc0 提示这是候选发布版本,适合提前验证兼容性而非直接用于生产环境。
迁移的意义:为何要统一到 Transformers 后端
降低维护成本的必然选择
推理框架支持数十个模型系列时,如果每个模型都维护一套独立的加载与执行逻辑,代码库会迅速膨胀,任何底层改动都需要在多个模型实现中重复验证。将 Gemma 与 StableLM 迁移到 Transformers 后端,本质是把模型定义与权重加载的职责交还给上游库,vLLM 侧只需关注推理调度与内存管理等核心能力。
这种做法在开源推理框架中已有先例。分流实现虽然能在特定模型上做极致优化,但长期来看会让新模型接入周期变长,也提高了社区贡献者的理解门槛。
对模型行为的一致性问题
不同后端在处理权重映射、数据类型转换、注意力实现细节时可能存在细微差异。迁移到统一后端后,Gemma 和 StableLM 的行为更贴近上游 Transformers 的参考实现,这对需要做输出可比性验证的用户是一个正向变化。
不过,迁移也可能带来短期的回归风险,例如某些量化配置或自定义算子路径在新后端下尚未覆盖。rc0 版本的存在正是为了收集这类反馈。
Transformers 后端指的是直接复用 Hugging Face Transformers 库中的模型定义、权重映射和配置解析逻辑,而非在 vLLM 内部为每个模型单独编写实现。Transformers 已成为模型权重与配置的事实标准格式,绝大多数开源模型发布时都会提供 config.json、model.safetensors 等配套文件。vLLM 通过挂接这一层,可以自动继承上游对新模型结构、RoPE 配置、数据类型等细节的支持,从而把“模型长什么样”与“如何高效推理”解耦。代价是需要在 vLLM 的注意力实现与 Transformers 的模块抽象之间做适配,某些上游未覆盖的融合算子或量化方案可能暂时缺失。
版本信息与提交细节
本次提交的标签为 v0.34.0rc0,提交哈希为 34b780f,由 hmellor 在 11 月 8 日打上标签。提交配有 GitHub 验证签名,GPG 密钥 ID 为 B5690EEEBB952194,说明代码来源可追溯。
合并请求 #66393 的标题直接点明了范围:Transformers backend 下的 Gemma 与 StableLM 迁移。提交信息中还标注了 Co-authored-by 字段,显示有协作参与。
从发布节奏看,rc0 通常意味着正式版前还会有若干候选或补丁发布。关心 Gemma 与 StableLM 在 vLLM 上的行为变化的用户,可以在这一版本上开展兼容性测试,并关注后续正式版的变更日志。
rc0 是 release candidate 的缩写,表示第一个候选发布版本。在语义化版本实践中,0.34.0rc0 排在 0.34.0 正式版之前,其 API 与行为已基本冻结,但仍可能因回归报告而调整。与 alpha、beta 相比,rc 阶段通常只接受缺陷修复而非新功能,因此适合作为兼容性验证的起点。rc0 中的数字在出现多个候选版时会递增(如 rc1、rc2),每次迭代都对应一批已修复问题的重新打包。生产环境一般应等待去掉 rc 后缀的正式版,或至少确认自身依赖的模型路径已在候选版中通过测试。
对使用者的实际影响
对于已经在生产中使用 Gemma 或 StableLM 的团队,升级前需要重点验证三类场景:一是加载已有权重时是否出现配置不兼容,二是推理输出的数值是否与旧版本保持一致,三是显存占用与吞吐表现是否发生明显偏移。迁移到 Transformers 后端并不必然意味着性能下降,但后端切换通常会改变算子选择,实际表现需要以基准测试为准。
对于新接入这两个模型系列的用户,统一后端的直接好处是配置方式更接近其他 Transformers 模型,减少了专门查阅模型特有参数的成本。
后端切换带来的性能偏移主要来自算子选择与内核调度的变化。旧有专用实现可能针对 Gemma 或 StableLM 的特定结构手写了融合算子(如融合的 RMSNorm、旋转位置编码),而 Transformers 后端走的是通用路径,是否启用融合取决于 vLLM 的适配层是否识别到对应模式。此外,KV Cache 的布局、批处理调度策略与量化内核(如 FP8、AWQ)的挂接方式也可能随后端不同而变化。因此迁移后的吞吐与显存表现不能简单外推,需要用代表性请求分布做 A/B 基准测试,重点关注首 token 延迟、解码吞吐和峰值显存三项指标。
编辑观点
vLLM 此次迁移是推理框架走向成熟的一个信号:当模型覆盖面足够广之后,维护统一后端比维护大量定制实现更有价值。对社区而言,真正需要观察的是迁移后的回归问题密度,以及后续版本是否会将更多模型系列纳入同一后端。Gemma 与 StableLM 只是这一步的开始。
相关推荐

Hermes Agent零基础教程:自进化AI智能体实战
Hermes Agent零基础教程:详解这个GitHub两月获41.7K星的开源自进化AI智能体,从Harness Engineering核心理念、学习循环、三层记忆系统到WSL安装与实战配置,小白也能轻松上手。

AI Agent落地实战:用WorkBuddy打造智能办公助理
本文通过实战案例演示如何用腾讯WorkBuddy完成文件批量转换与归档,对比聊天大模型与AI Agent的能力差异,分析WorkBuddy的积分体系、适用场景与产品定位,为办公自动化选型提供参考。

从单卡瓶颈到千亿参数:大模型分布式并行6大关键问题
基于B站教程梳理大模型分布式并行核心知识:从decoder-only架构的逐token生成与X乘W计算本质出发,解析单卡瓶颈下数据并行、张量并行、流水线并行等6个关键问题,适合私有化部署与模型训练场景的学习者建立系统认知。