vLLM 维护者 PyTorch 大会聚餐:高吞吐烤肉与零延迟干杯
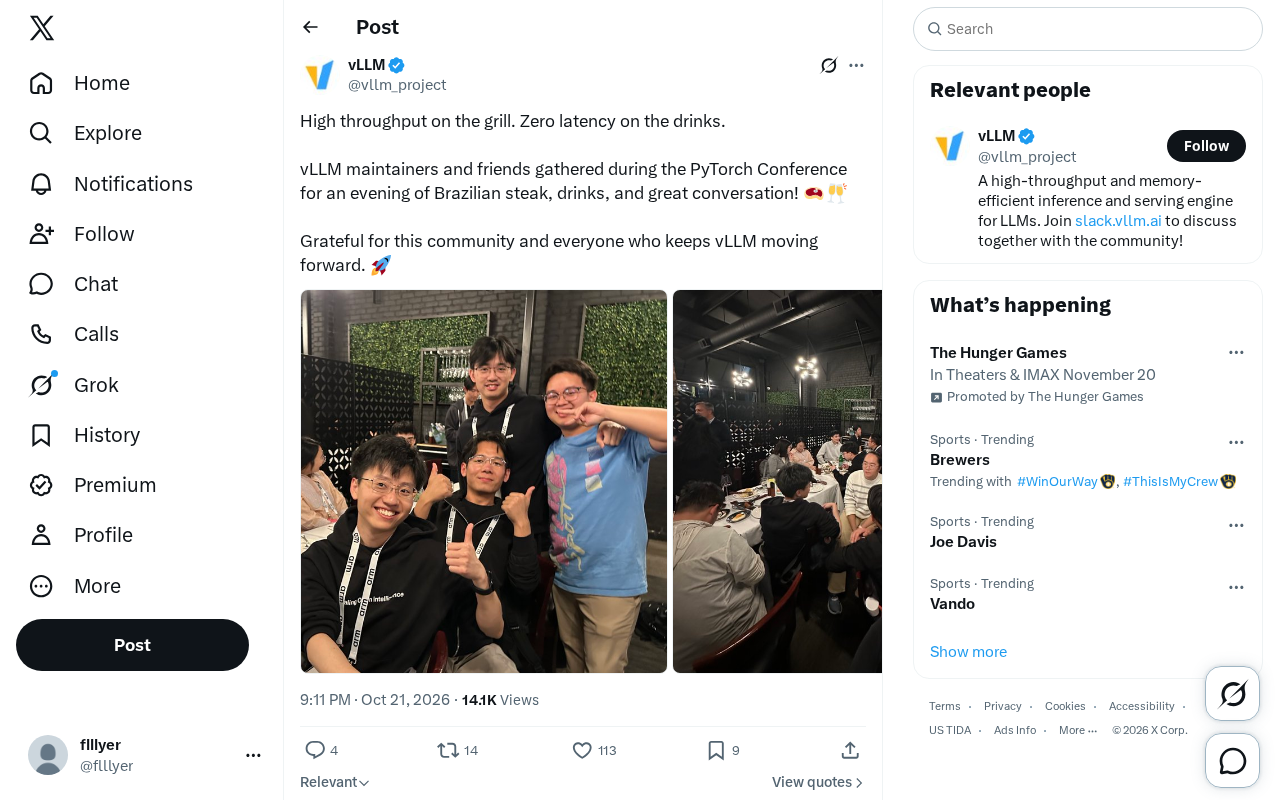
vLLM 维护者在 PyTorch Conference 期间聚餐,用「高吞吐烤肉、零延迟饮品」的技术梗致谢社区。
vLLM 官方推特发布了一条轻松动态:在 PyTorch Conference 期间,vLLM 维护者与朋友们共进晚餐,享用巴西烤肉与饮品并深入交流。推文用「High throughput on the grill」和「Zero latency on the drinks」两个技术梗,巧妙借用 vLLM 所专注的推理性能指标来形容聚会的畅快,并表达了对社区的感谢。文章借此补充了 vLLM 作为开源高吞吐、低延迟 LLM 推理引擎的背景,指出其核心创新包括 PagedAttention 等内存管理技术,维护者活跃于 PyTorch 等社区。整体来看,这条信息量有限的推文折射出成熟开源项目借大型会议组织线下聚会、增强社区凝聚力的常见运营方式,也强化了项目的技术品牌形象。
vLLM 官方推特发布了一条轻松的动态:在 PyTorch Conference 期间,vLLM 的维护者与朋友们聚在一起,享用巴西烤肉和饮品,并进行深入交流。推文用两个技术梗精妙概括了这场聚会——「烤架上高吞吐,饮品零延迟」,还表达了对社区的感谢,称正是大家推动 vLLM 不断前进。
一场技术社区的线下聚会
据 vLLM 官方推特描述,这场聚会发生在 PyTorch Conference 期间,参加者包括 vLLM 的维护者以及他们的朋友。活动形式是晚餐,主打巴西烤肉和酒水,核心目的是交流。推文没有透露具体人数、地点或讨论的技术细节,但从「great conversation」的表述来看,这更像是一次社区联络感情的轻松场合,而非正式的技术议程。
值得留意的是推文的措辞方式:用「High throughput on the grill」形容烤肉供应充足,用「Zero latency on the drinks」形容饮品上桌迅速。这两个比喻直接借用了 vLLM 所专注的推理性能指标——吞吐量和延迟,显示出维护者即使在聚餐时也不忘技术身份。
vLLM 是什么,为何社区活跃
对于不熟悉 vLLM 的读者,这里做一个简要背景补充。vLLM 是一个开源的高吞吐量、低延迟大语言模型推理和服务引擎,核心创新包括 PagedAttention 等内存管理技术,被广泛用于生产环境中的 LLM 部署。项目在 GitHub 上拥有大量贡献者,并围绕推理性能持续迭代。
vLLM 的维护者群体活跃于 PyTorch 等深度学习框架社区,此次在 PyTorch Conference 期间组织聚会,反映出两个开源社区之间的人员交集与协作关系。推文结尾的「Grateful for this community」也印证了项目对社区贡献的重视。
PagedAttention 的工作原理:PagedAttention 借鉴了操作系统中虚拟内存与分页的思想来管理 KV Cache。传统推理引擎为每个请求预分配一整块连续显存存放键值缓存,容易因请求长度差异造成大量碎片与浪费;PagedAttention 将 KV Cache 切分为固定大小的「页」(block),按需分配、以逻辑到物理的映射表寻址,从而允许页在显存中非连续存放。这一机制把显存浪费压到极低水平,使更多请求能同时驻留显存、被批处理执行,由此带来吞吐量的显著提升,同时也让前缀共享、并行采样等场景更高效。
吞吐量与延迟的区别:这两个指标常被并列提及,但含义不同甚至相互制约。吞吐量指单位时间内系统处理的 token 数或请求数,衡量的是整体服务能力与硬件利用率;延迟指单个请求从发出到完成所需的时间,衡量的是用户感知的响应速度。批处理(batching)通常是提升吞吐量的主要手段,但过大的批次会增加排队与单请求等待时间,从而抬高延迟。vLLM 的连续批处理(continuous batching)正是为了在两者之间取得平衡:请求完成即退出批次、新请求立即补入,而非等待整批结束,使 GPU 尽可能保持忙碌的同时控制尾延迟。
从推文看开源项目的社区运营
这条推文本身信息量有限,但它折射出成熟开源项目的一种常见做法:借大型会议的机会组织线下聚会,维护者与贡献者、用户面对面交流,增强社区凝聚力。vLLM 官方账号用幽默的技术梗包装聚会信息,既传递了社区温度,也强化了项目的技术品牌形象。
对于关注 vLLM 的开发者而言,这类动态的价值不在于技术内容,而在于确认项目背后有一群持续投入的维护者,并且社区氛围友好开放。推文中「everyone who keeps vLLM moving forward」的致谢,正是开源协作文化的典型表达。
延伸:vLLM 的持续演进方向
虽然这条推文没有讨论技术路线,但结合 vLLM 项目一贯的公开动态,其核心关注点始终围绕推理吞吐量、延迟优化、内存效率以及新模型架构的支持。维护者们在会议期间聚会交流,也可能为后续的协作开发埋下伏笔。对开发者来说,关注 vLLM 的 GitHub 仓库和官方社交媒体,是获取最新进展的有效途径。
(本文基于 vLLM 官方推特公开内容撰写,未包含推文之外的推测性信息。)
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
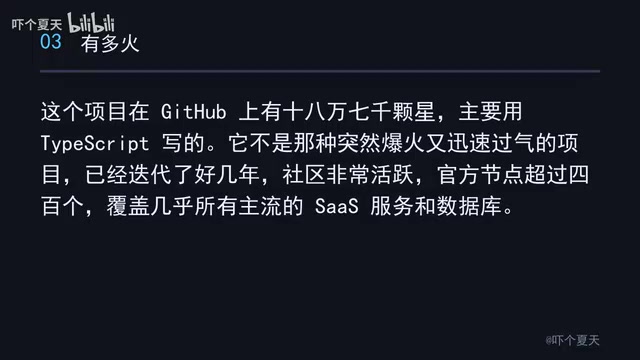
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
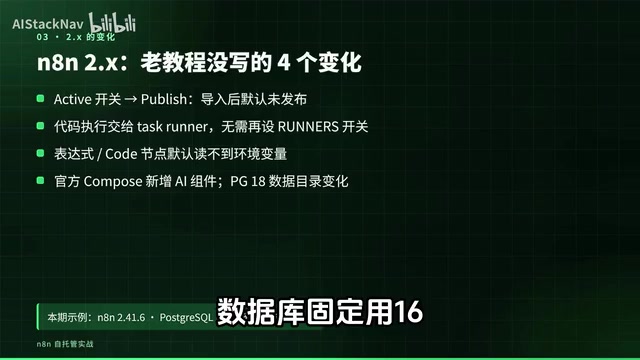
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。