vLLM发布v0.32.1rc0:为训练器新增权重传输HTTP协议文档
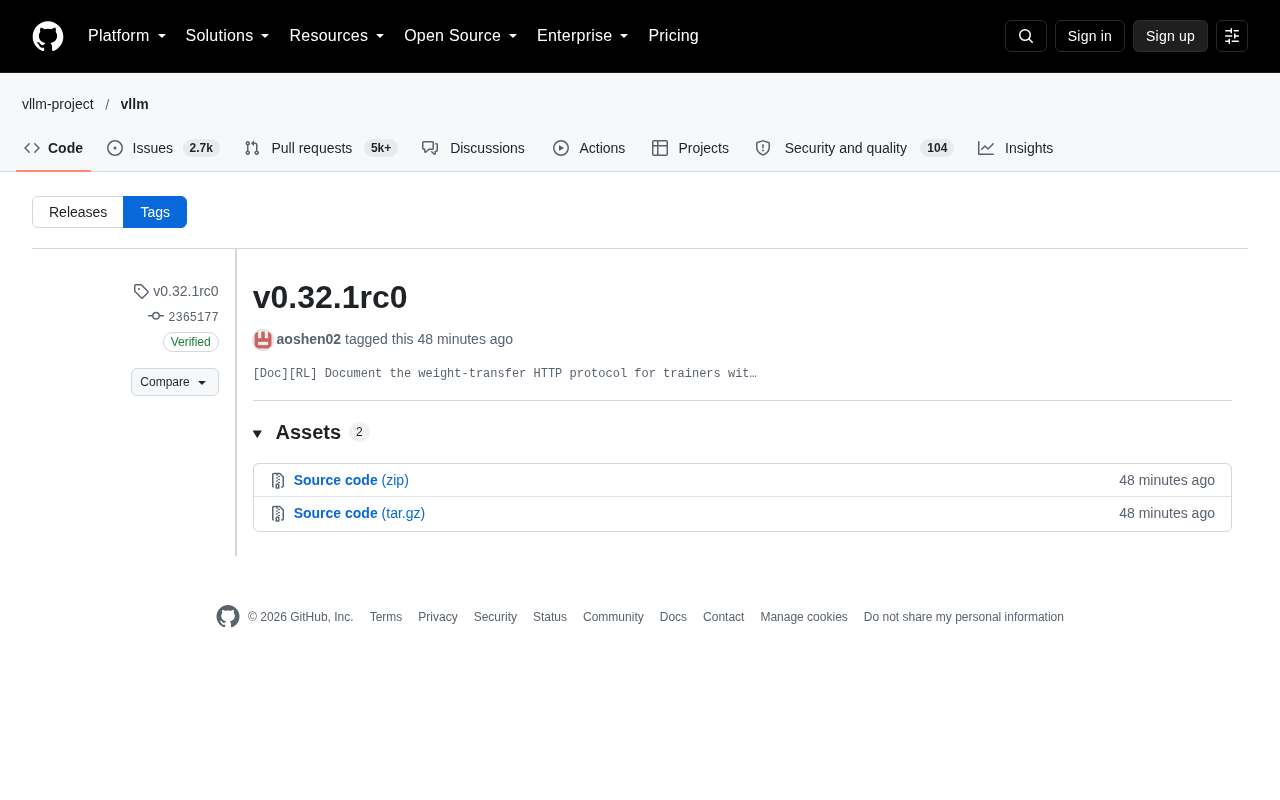
vLLM 发布 v0.32.1rc0 候选版,核心是为权重传输 HTTP 协议补充文档。
vLLM 在 GitHub 释出 v0.32.1rc0 候选版本,由贡献者 aoshen02 提交,核心改动是为训练器补充 weight-transfer HTTP 协议的文档。该协议面向 RLHF、在线偏好优化等训练与推理分离的场景,通过 HTTP 接口完成权重推送与拉取,替代落盘重载或 NCCL 直传,降低部署约束、提升跨节点灵活性。文章认为,把接口文档化意味着该能力被视为对外稳定契约,外部团队可据此实现自有 trainer 端。由于素材缺失完整 diff 与资产清单,协议端点、消息格式与鉴权细节无法确认。作者建议生产用户等待正式版,RL 开发者评估适配成本,贡献者可从文档类 PR 入手。
版本速览:一次以文档为核心的候选发布
近日,大模型推理框架 vLLM 在 GitHub 上释出 v0.32.1rc0 候选版本。这个 tag 由贡献者 aoshen02 于 18 日打上,提交信息指向一个相当具体的改动:为训练器补充 weight-transfer HTTP 协议的文档([Doc][RL] Document the weight-transfer HTTP protocol for trainers)。
从命名规则看,rc0 代表 release candidate 的第 0 个候选版本,意味着它面向正式发布前的验证阶段,而非稳定版。对于生产环境用户,通常建议等待正式 tag;而对想提前适配接口的开发者,这个候选版提供了预览窗口。
本次提交在 GitHub 上带有 verified 签名(GPG key ID B5690EEEBB952194),提交本身经过平台校验真实性。不过你可能没注意到,页面上的标签对比与资产列表在抓取时出现加载失败,因此本次变更的完整 diff、二进制 wheel 资产清单并未在素材中体现,这也是后续需要补充确认的部分。
权重传输 HTTP 协议:为什么值得单独写文档
强化学习场景下的参数同步难题
在 RLHF、在线偏好优化等训练流程里,推理与训练是两个分离的系统:训练器(trainer)负责更新参数,推理引擎(如 vLLM)负责高吞吐生成。每一步训练后,新权重需要从训练侧传到推理侧,这一环节的效率直接决定整体吞吐。
传统做法是把权重落盘再重新加载,或者依赖 NCCL 等集合通信库做 GPU 间直传。前者 IO 开销大、切换慢,后者对拓扑和部署环境要求高。weight-transfer HTTP 协议走的是另一条路——用 HTTP 接口完成权重的推送与拉取,让训练器与推理服务解耦,部署更灵活,跨节点、跨集群也更容易实现。
RLHF(基于人类反馈的强化学习) 是当前大模型对齐训练的主流范式,其典型流程包含三个阶段:监督微调(SFT)、训练奖励模型、用强化学习算法(如 PPO)优化策略模型。在 PPO 阶段,系统需要反复执行「生成—打分—更新」循环:推理引擎用当前策略模型批量生成回复,奖励模型对回复评分,训练器据此计算梯度并更新参数。每一轮迭代都要求推理侧与训练侧的模型权重严格一致,因此权重同步的延迟和可靠性直接成为流水线的瓶颈之一。
在线偏好优化(Online DPO 等) 则进一步把偏好数据的生成和训练交替进行,同样依赖高频的权重传递。这类场景对同步机制的要求不仅是「传得快」,还包括版本一致性、失败可重试以及跨异构集群的兼容性,这正是 HTTP 协议方案试图覆盖的需求面。
文档化的意义
接口类能力如果只有代码没有文档,外部集成方只能靠读源码反推协议细节,成本高且容易踩坑。这次提交把协议单独文档化,说明该能力已经被当作对外承诺的稳定接口来对待,至少对内部训练器团队而言是正式契约。对构建自定义 RL 流水线的团队来说,这意味着可以依据文档实现自己的 trainer 端,而不必绑定官方实现。
需要说明的是,由于原始素材并未包含文档正文,本文无法给出协议的具体端点、消息格式或鉴权方式。这些细节需以仓库中的实际文档为准。
GPG 签名与 verified 标记:GitHub 上的提交若带有 verified 徽章,表示该提交的 GPG(或 SSH、S/MIME)签名与提交者账号绑定的公钥匹配,可证明提交确实由该账号持有人创建、且内容未被篡改。文中出现的 key ID B5690EEEBB952194 即用于标识签名所用公钥。对开源项目而言,签名验证是供应链安全的一环,尤其在发布候选版本与二进制资产时,用户可据此确认来源可信。
release candidate(rc)版本语义:按语义化版本惯例,X.Y.ZrcN 表示功能已冻结、进入发布前验证的第 N 个候选版本,期间只接受缺陷修复,不再引入新特性。项目方通常在此阶段收集回归测试反馈,若无阻塞问题则提升为正式版。因此 rc 版不适合直接用于生产,但适合集成方提前做接口兼容性验证。
从这次提交看 vLLM 的工程取向
近几个版本里,vLLM 在推理侧之外持续加码训练侧协同能力。把权重传输协议写成文档,表面是文档工作,实质是在明确系统边界:推理引擎不再只是被动接收权重的黑盒,而是提供一套可编程接口供训练器调用。
这种思路与业界「推理训练一体化」的趋势一致——训练和推理不再各自为政,而是在参数同步、显存调度、批处理策略上相互配合。HTTP 协议的选择也体现了务实:相比专有 RPC,HTTP 更易调试、更易被各类语言栈接入,代价是在超低延迟场景下可能不如共享内存或 RDMA 方案,具体取舍要看协议实现是否支持批量与流式传输。
NCCL 与集合通信:NCCL(NVIDIA Collective Communications Library)提供 all-reduce、broadcast 等 GPU 间高速通信原语,是分布式训练中梯度同步的事实标准。用它做权重直传可绕过主机内存与磁盘,延迟极低,但要求通信双方位于同一 NCCL 通信域内,对网络拓扑(如 NVLink、InfiniBand)和启动方式有较强约束,跨集群或推理服务动态伸缩时不易维持。相比之下,HTTP 协议以牺牲部分延迟换取部署解耦与语言栈无关性,二者适用场景互补而非替代。
推理训练一体化:该趋势指训练与推理共享模型定义、并行策略和调度基础设施,减少两套系统的重复建设。vLLM 在推理侧积累的 PagedAttention、连续批处理等能力,正逐步向训练后阶段延伸,权重传输接口是这一方向的基础设施层。
给不同用户的建议
生产用户:rc0 属于候选版本,若无明确需求,建议等待 v0.32.1 正式版;升级前核对 release notes 中的行为变更。
RL 流水线开发者:可以关注该协议文档,评估其与现有 trainer 的适配成本。若已有自研权重同步方案,可对比 HTTP 方案在你们集群拓扑下的延迟表现。
框架贡献者:文档类 PR 门槛相对低,是熟悉 vLLM 代码结构与 RL 流程的好切入点。
由于素材信息有限,上述判断基于版本命名惯例与提交标题,具体 API 细节请以仓库文档为准。
常见问题
v0.32.1rc0 是稳定版吗? 不是。rc 后缀表示候选发布版本,用于正式版前的测试与验证。
weight-transfer HTTP 协议解决什么问题? 在训练器与推理引擎分离的 RL 流程中,通过 HTTP 接口完成权重同步,降低对落盘重载或 GPU 直连通信的依赖。
这次更新有性能变化吗? 从提交信息看以文档为主,素材未提及运行时改动,无法确认性能影响。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。