vLLM发布v0.34.0rc2版本:调整GPU内存配置

vLLM发布v0.34.0rc2,核心改动是停止在多数可扩展场景默认设置gpu_memory_utilization。
vLLM 发布 v0.34.0rc2 候选版本,由贡献者 njhill 于 11 月 12 日打上标签,属于以维护为主的版本,未引入新功能。核心改动是停止在大多数可扩展场景中自动设置 `gpu_memory_utilization` 参数,该参数原本用于控制模型加载时预分配的 GPU 显存比例(默认约 0.9)。移除自动赋值后,显存预算的决定权交还上层调用方,避免与共享 GPU 的其他进程或外部编排逻辑冲突,但也要求使用 Python API 且未显式传参的开发者检查配置,防止升级后显存分配不符合预期。改动同步更新了文档与测试,命令行用户受影响相对较小。文章建议升级前阅读完整 release notes 并在测试环境验证显存相关路径。
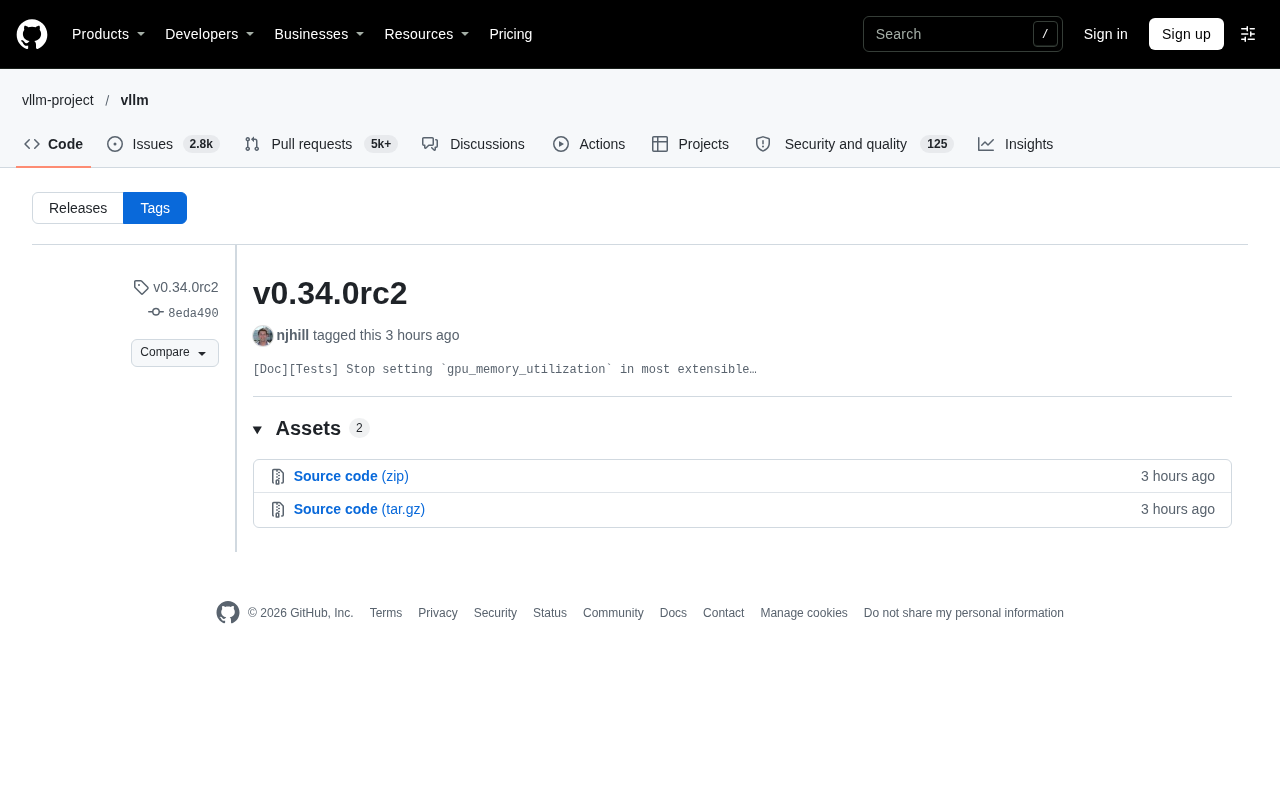
vLLM项目发布了v0.34.0rc2候选版本,本次更新主要包含文档与测试方面的调整,核心变动是停止在大多数可扩展场景中默认设置gpu_memory_utilization参数。这一改动看似细微,却可能影响开发者在部署推理服务时的显存管理方式。
版本发布概况
根据GitHub上的标签信息,v0.34.0rc2由贡献者njhill于11月12日打上标签。从提交记录看,这个候选版本聚焦于代码库的维护性改进,而非引入新功能。发布页面显示,该版本附带了若干资源文件,但具体内容未在摘要中展开。
候选版本通常意味着功能已基本冻结,进入测试与修复阶段。对于生产环境用户而言,rc版本不建议直接部署,但可以提前了解变更方向。
核心变更:不再默认设置gpu_memory_utilization
本次提交的标题明确指出了改动范围:在大多数可扩展(extensible)场景中停止设置gpu_memory_utilization。这个参数在vLLM中用于控制模型加载时预分配的GPU显存比例,默认值通常为0.9。
过去,vLLM会在初始化时自动为该参数赋值,简化了用户配置。但自动设置也可能带来问题:当用户希望精细控制显存分配,或运行环境需要与其他进程共享GPU时,硬编码的默认值反而造成干扰。移除自动设置后,用户需要显式指定该参数,或者依赖底层框架的默认行为。
对开发者的影响
对于直接使用vLLM Python API的开发者,如果代码中未显式传入gpu_memory_utilization,升级后行为可能发生变化。建议检查现有配置,明确该参数的取值,避免因默认值缺失导致显存分配不符合预期。
对于通过命令行启动服务的用户,影响相对较小,因为命令行工具通常已提供默认值。但文档中相关示例可能需要同步更新,这也是本次提交同时涉及文档和测试的原因。
PagedAttention 与 KV Cache 显存占用
理解 gpu_memory_utilization 的作用,需要先了解 vLLM 的 PagedAttention 机制。传统推理框架在生成阶段需要为每个请求预留连续的 KV Cache 空间,容易产生显存碎片和浪费。PagedAttention 借鉴操作系统虚拟内存分页的思路,把 KV Cache 切分为固定大小的 block,按需分配、非连续存储,从而显著提升显存利用率和并发吞吐。也正因如此,vLLM 在启动时必须预先知道可用显存的大致上限,用它来计算能容纳多少 block、支持多大的并发 batch。gpu_memory_utilization 正是这一预算的输入:它告诉 vLLM 可以占用 GPU 总显存的多少比例来存放模型权重与 KV Cache 块。该值设得过高,可能与同卡上的其他进程争抢显存导致 OOM;设得过低,则 KV Cache block 数量不足,并发能力被压缩。因此这个参数并非普通超参,而是直接决定服务容量规划的关键配置。
可扩展场景(extensible scenarios)的含义
提交中提到的“可扩展场景”,指的是 vLLM 允许用户替换或扩展其内部组件的那些使用方式,例如自定义执行器(executor)、接入第三方调度器、在多进程或分布式部署中由外部框架托管显存分配等。在这些场景下,vLLM 不再是显存的唯一管理者,若仍强行写入一个默认的 gpu_memory_utilization,就会覆盖调用方已经规划好的显存预算,甚至引发重复预留。停止默认设置,本质上是把显存预算的决定权交还给上层编排逻辑,符合“库不应替调用方做全局资源决策”的设计原则。这也解释了为何改动被标注为面向可扩展场景,而非一刀切地删除所有默认值。
文档与测试同步调整
提交信息中的[Doc][Tests]前缀表明,改动不仅涉及代码逻辑,还包括文档说明和测试用例的更新。这种同步调整是良好工程实践的体现:文档反映新行为,测试确保改动不会破坏现有功能。
从发布页面的资源列表看,该版本附带了两个资源文件,但具体内容未在抓取的信息中显示。感兴趣的开发者可以前往GitHub发布页面查看完整变更。
版本迭代节奏观察
vLLM作为大模型推理领域的热门开源项目,版本迭代较为频繁。rc2的出现说明rc1可能已经过一轮测试反馈,修复了若干问题后推出第二个候选版本。这种小步快跑的模式有助于快速响应用户反馈,但也要求使用者关注变更日志,及时调整集成代码。
对于依赖vLLM构建服务的团队,建议在升级前阅读完整的release notes,并在测试环境中验证关键路径。特别是涉及显存配置的部分,不同GPU型号和模型规模下的表现可能存在差异。
候选版本(rc)在语义化发布中的定位
rc 即 release candidate,是正式版发布前的最后验证阶段。按常见约定,进入 rc 意味着新功能已冻结,后续只接受缺陷修复和文档修补,版本号形如 0.34.0rc2 表示 0.34.0 正式版的第二个候选。与 alpha、beta 相比,rc 更接近生产质量,但仍不承诺 API 与行为的最终稳定;一旦正式版发布,rc 阶段的行为变更会被视为正式语义的一部分。对使用者而言,rc 的价值在于提前暴露兼容性问题,尤其是像本次这样会改变默认行为的改动——在 rc 阶段发现并反馈,成本远低于正式版上线后的紧急回滚。
小结
v0.34.0rc2是一个以维护为主的候选版本,核心改动是停止在多数场景下自动设置gpu_memory_utilization。这一调整给予开发者更明确的控制权,但也要求用户主动管理显存参数。在正式版发布前,建议关注后续rc版本的反馈和修复情况。
相关推荐

Codex入门教程:从安装部署到API中转配置实战
Codex入门教程详解:绕过官方登录的信用卡与手机号门槛,通过API中转站完成注册、充值与密钥配置,手把手演示Windows下config.toml文件的修改方法,十分钟完成部署。
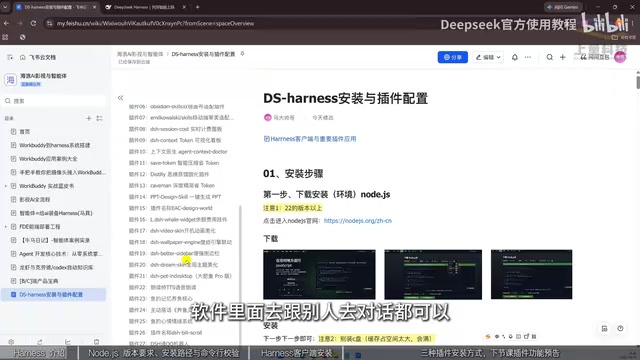
DeepSeek Harness从入门到实战:安装与插件全解析
DeepSeek Harness 教程:从安装 NodeJS 环境、部署 Harness 客户端到三种插件安装方式(AI 代装、插件市场、命令行),解析 AI Agent 工作流搭建的实操路径。

DeepSeek Harness实战教程:从安装到插件打造AI超级Agent
DeepSeek Harness实战教程:详解Node.js环境安装、Harness客户端下载配置,以及让AI自装、插件市场、命令行三种插件安装方式,帮你把AI从聊天工具变成能处理本地文件和复杂任务的超级Agent。