vLLM工具调用准确率修复实践

vLLM工具调用准确率问题源于解析层错位,需从格式校验与回归测试入手修复。
本文基于Hacker News讨论,分析vLLM在工具调用场景下准确率波动的根源与修复思路。工具调用是AI应用与外部系统交互的关键能力,参数格式错误会直接影响Agent系统可靠性。问题根源在于模型生成的结构化输出与vLLM解析器之间的格式不匹配、特殊token处理不当及流式输出截断。修复需从推理引擎解析层入手,确保工具调用参数被完整准确提取。实践建议包括:增加JSON Schema严格校验、处理流式与长参数边界情况、建立工具调用准确率基准测试集并持续监控。文章最后指出,推理框架的兼容性与解析可靠性是Agent落地的隐形门槛,开发者应优先验证而非仅关注模型本身能力。
vLLM作为高性能LLM推理引擎,在工具调用(tool call)场景下的准确率问题近期引发讨论。本文基于Hacker News上的一则分享,解析问题根源与修复思路。
工具调用准确率为何成为痛点
在AI应用开发中,工具调用是让模型与外部系统交互的关键能力。无论是API调用、数据库查询还是函数执行,都依赖模型准确生成结构化参数。然而,vLLM在工具调用场景下可能表现出准确率波动,导致参数格式错误或调用失败。据Hacker News上的讨论,这一问题直接影响生产环境的稳定性。
工具调用的准确性不仅关乎单次请求的成功率,更影响整个Agent系统的可靠性。当模型输出的工具调用参数出现偏差时,下游逻辑可能产生连锁错误。
问题根源:解析与生成的错位
从原始分享的标题“Fixing Tool-Call Accuracy in vLLM”可以推断,修复工作聚焦于vLLM对工具调用输出的处理机制。常见原因包括:模型生成的结构化输出与vLLM解析器之间的格式不匹配、特殊token处理不当、以及流式输出下的截断问题。
这些技术细节在原始素材中未展开,但可以明确的是,修复需要从推理引擎的解析层入手,确保工具调用参数被完整、准确地提取。
结构化输出与解析器的契约关系:工具调用要求模型输出符合特定JSON Schema的结构化数据,而vLLM的解析器负责从生成的token流中提取这些数据。两者之间存在隐式契约:解析器需要准确识别起始/结束token、处理嵌套结构和转义字符。当模型的采样参数(如temperature、top_p)导致输出格式偏离训练分布时,解析器可能无法正确匹配边界,从而产生参数截断或格式错误。此外,不同模型系列(如Llama、Qwen、Mistral)对工具调用的特殊token约定不同,vLLM需适配多种模板,增加了错位风险。
流式输出下的增量解析挑战:在流式场景中,vLLM逐token返回结果,解析器必须在数据不完整时进行增量判断。若解析器过早触发工具调用结束信号,或未能缓冲跨chunk的JSON片段,就会导致参数丢失。长参数(如大段文本或嵌套对象)尤其容易在chunk边界处被截断。修复通常需要引入状态机式解析器,在流式过程中维护括号层级和字符串状态,确保只有在结构完整时才提交结果。
修复方向与实践建议
对于使用vLLM部署工具调用能力的开发者,可关注以下方向:
- 校验输出格式:在解析层增加对JSON Schema的严格校验,捕获格式错误。
- 处理边界情况:针对流式输出和长参数场景,确保不截断、不丢失。
- 回归测试:建立工具调用准确率的基准测试集,持续监控。
据Hacker News讨论,该修复方案已在实际场景中验证,为社区提供了可参考的实践路径。
JSON Schema严格校验的落地方式:在解析层引入JSON Schema校验,意味着对模型输出的工具调用参数进行结构验证,而不仅是语法解析。可使用Pydantic或jsonschema库在vLLM的后处理阶段增加校验步骤,对必填字段、类型、枚举范围和嵌套结构进行逐项检查。校验失败时,可触发重试或降级策略(如返回错误提示而非静默失败),从而避免下游逻辑接收到残缺参数。对于高频工具,建议预编译Schema校验器以减少运行时开销。
回归测试基准的构建:建立工具调用准确率基准测试集,需要覆盖典型工具(如搜索、计算、API调用)和边界场景(空参数、超长参数、特殊字符、多工具并行调用)。测试集应包含固定随机种子的生成配置,以区分模型能力波动与解析器缺陷。持续监控可结合CI流水线,在vLLM版本升级或模型切换时自动运行,量化准确率变化,及时发现回归。
对AI应用开发的启示
工具调用准确率是AI应用落地的隐形门槛。vLLM的这次修复提醒开发者,推理引擎的细节处理直接影响上层应用的稳定性。在构建依赖工具调用的Agent时,应优先验证推理框架的兼容性与解析可靠性,而非仅关注模型本身的能力。
随着工具调用成为LLM标配能力,推理引擎层面的准确率优化将持续受到关注。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
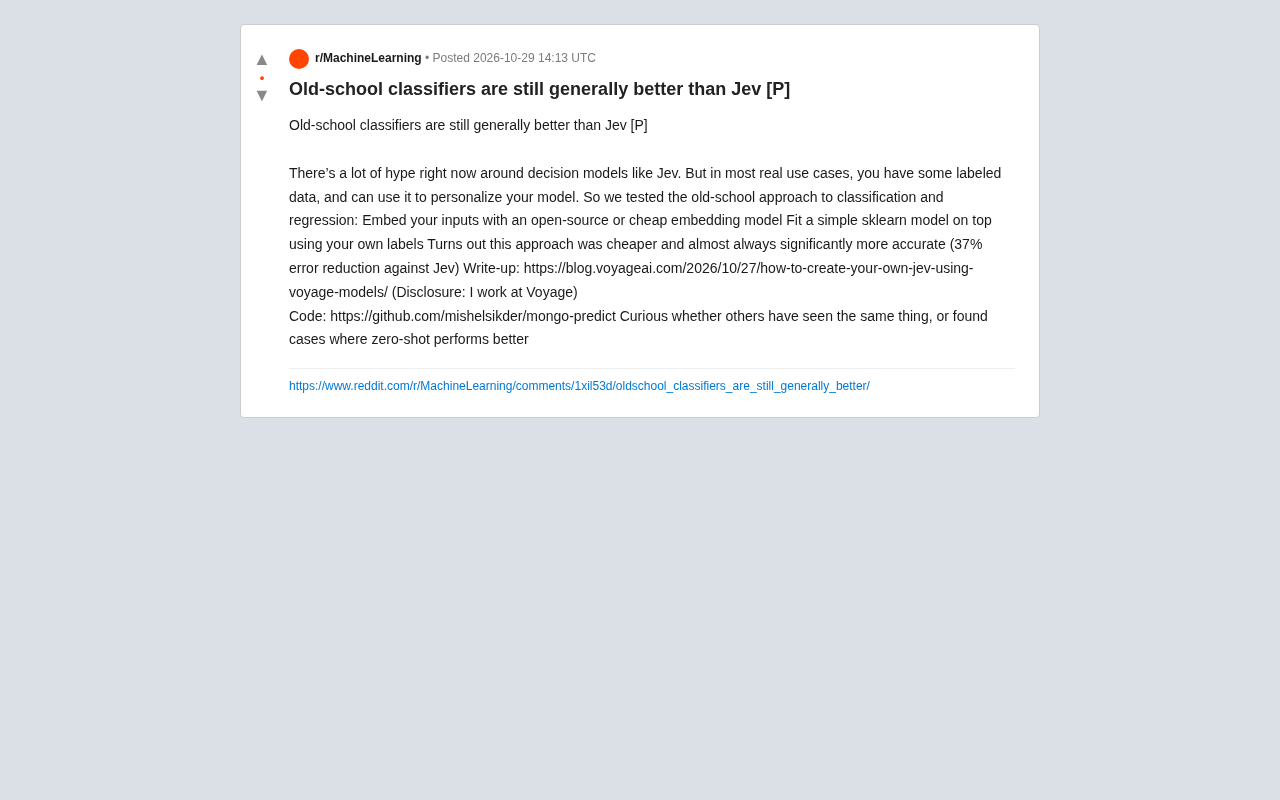
老派分类器仍胜Jev:嵌入+sklearn误差降37%
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。