vLLM新版本发布:DeepSeek推理性能飙升1.9至5.3倍

vLLM v0.3.1 针对 DeepSeek 深度优化,低并发提速1.9倍、高并发5.3倍,但官方镜像存在CUDA版本冲突Bug。
vLLM 发布 v0.3.1,针对 DeepSeek 系列模型做了深度优化,低并发场景加速 1.9 倍,150 并发时吞吐量提升 5.3 倍,首 Token 生成时间(TTFT)最高降低 5.8 倍。性能提升主要来自三方面:完整实现 DeepSeek 的 SWA 有界重放机制(贡献约 30% 的 TTFT 下降)、集成 MegaTension/MegaMHC/MegaGate 等官方高性能内核,以及将多步操作融合并行化。不过实战中发现官方镜像存在严重 Bug:镜像基于 CUDA 12.9 构建,却混入了 CUDA 13 版本的底层库,导致启动即报错。解决方案是基于 CUDA 12.9 重建 Docker 镜像并重装 Torch 库。文章建议使用 vLLM 部署 DeepSeek 的企业尽快评估升级,性能红利足以覆盖迁移成本。
开源推理引擎vLLM近日发布了新版本(v0.3.1),这一更新在AI社区引发了广泛关注。据B站UP主分享的实测经验,该版本针对DeepSeek系列模型进行了深度优化,推理性能获得了惊人的提升——低并发场景下加速1.9倍,高并发场景下吞吐量更是飙升5.3倍。
性能提升的核心数据
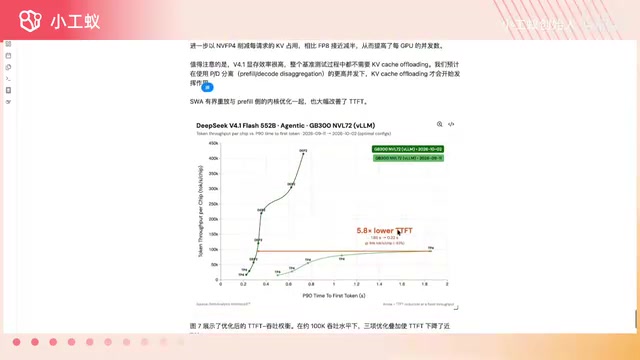
根据vLLM官方博客的说明,这次性能飞跃主要体现在两个关键指标上。在首Token生成时间(TTFT)方面,新版本实现了高达5.8倍的降低,这意味着用户等待模型开始响应的延迟大幅缩短。而在吞吐量方面,当并发请求达到150个时,系统整体吞吐量可提升至原来的5.3倍。
简单来说,假如你原本拥有一台机器运行DeepSeek广告模型,升级vLLM后,相当于免费获得了额外数台同等性能的机器。这种通过软件优化带来的硬件效率提升,对于企业降低AI部署成本具有重大意义。
首Token生成时间(TTFT) 是衡量大模型推理服务质量的核心指标,全称 Time To First Token,指从用户发出请求到模型吐出第一个Token所经历的延迟。与总生成时间不同,TTFT 只反映"预填充(prefill)"阶段的效率——也就是模型处理整段输入提示、建立 KV 缓存的过程。在聊天机器人、代码补全、Agent 工具调用等交互式场景中,用户对 TTFT 的感知极为敏感:TTFT 越长,主观上就越觉得"模型卡住了"。
TTFT 主要受输入序列长度、模型规模、显存带宽以及批处理调度策略影响。vLLM 此次将 TTFT 降低 5.8 倍,本质上是通过 SWA 有界重放、内核融合等手段压缩了预填充阶段的计算与访存开销,从而让"首字冒出来"的速度大幅提升。对于长上下文、高并发的企业级推理服务而言,TTFT 的改善往往比吞吐量提升更能直接转化为用户留存。
三大技术优化解析
SWA有界重放机制
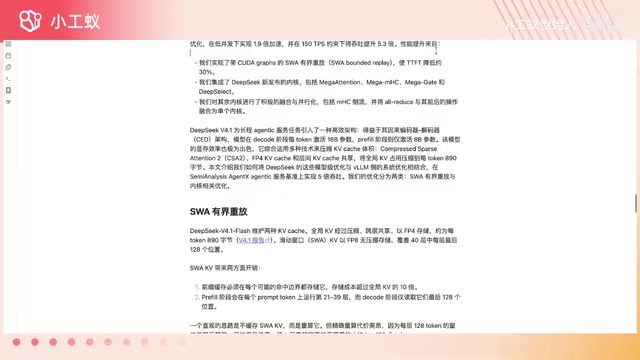
据UP主介绍,DeepSeek模型中引入的SWA(Sliding Window Attention)有界重放功能,此次被vLLM完整实现。这一机制对首Token生成时间的降低贡献显著,官方数据显示TTFT下降了约30%。对于需要快速响应的交互式应用场景,这一优化直接提升了用户体验。
SWA(Sliding Window Attention,滑动窗口注意力) 是一种稀疏注意力变体:标准自注意力中每个 Token 需要关注前面所有 Token,计算量与显存占用随序列长度呈平方级增长;而 SWA 只让每个 Token 关注其前面固定窗口内的邻居,将复杂度降到近似线性。DeepSeek 系列模型在部分层采用了 SWA,以支持超长上下文并降低推理成本。
所谓"有界重放(bounded replay)",指的是推理引擎在处理 SWA 层时,无需为每个 Token 保留完整的 KV 缓存,而是只重放窗口范围内的有限历史。vLLM 完整实现这一机制后,既避免了为滑动窗口之外的历史 Token 浪费显存,又能在预填充阶段减少重复计算,因此对降低 TTFT 贡献约 30%。它也是理解本次性能飞跃的关键技术前提。
DeepSeek新内核集成
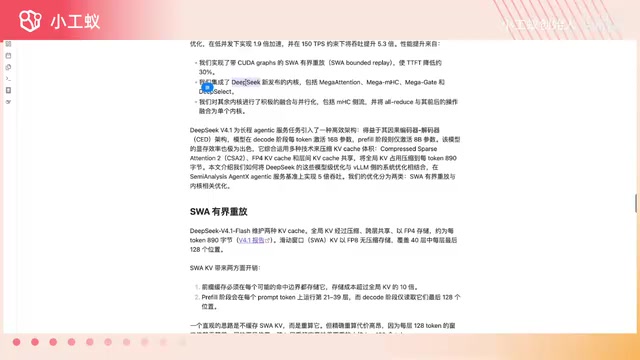
DeepSeek近期开源了多个针对英伟达硬件优化的计算内核,包括MegaTension、MegaMHC、MegaGate以及DeepSeekLact等。vLLM团队将这些新内核集成到了推理引擎中,使得底层计算效率得到进一步提升。
计算内核(Kernel) 是运行在 GPU 上的最小可执行计算单元,一个 Transformer 层往往会被拆成数十个内核依次执行。内核数量越多、启动越频繁,GPU 在调度与数据搬运上的"空转"就越多,实际算力利用率就越低。因此,把多个小内核合并成更大、更饱满的内核(Kernel Fusion)是推理优化的通用思路。
文中提到的 MegaTension、MegaMHC、MegaGate、DeepSeekLact 等,是 DeepSeek 官方针对英伟达硬件特性(如 Tensor Core、共享内存)手写并开源的高性能内核,分别对应注意力、MoE 路由、门控等不同计算模块。vLLM 将这些内核直接集成进推理引擎,相当于用"官方调优过的零件"替换了通用实现,从而在底层把计算效率往上推了一档。
融合操作与并行化
vLLM还将多步操作进行了融合与并行化处理,将原本需要分步执行的操作合并为单步完成。这种系统级的优化策略,从整体上减少了计算开销和内存访问次数。
升级过程中的实战踩坑
尽管性能提升显著,但UP主在实际部署中发现了官方镜像存在的一个严重Bug。当系统环境使用CUDA 12.9版本时,vLLM启动会直接报错,导致所有模型无法正常运行。
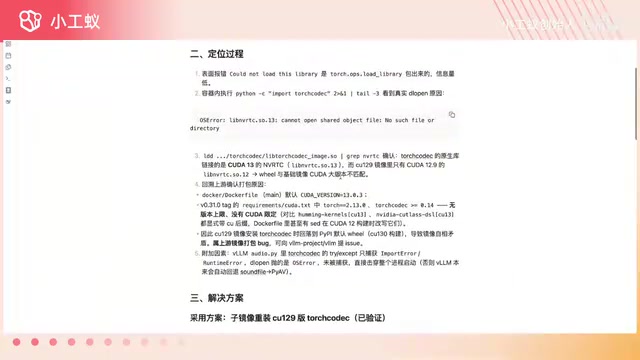
问题根源在于官方镜像的依赖管理出现了版本混淆:镜像本身基于CUDA 12.9构建,但在安装某个音频处理相关的底层库时,却错误地引入了CUDA 13版本的组件,造成了版本冲突。
解决方案是重新构建镜像。用户需要在原镜像基础上编写Dockerfile,基于CUDA 12.9版本重新安装Torch相关库。修复完成后,模型即可正常启动并享受新版本带来的性能红利。
CUDA 版本冲突是深度学习部署中最常见也最棘手的问题之一。CUDA 是英伟达的 GPU 计算平台,PyTorch、vLLM 等框架都需要针对特定 CUDA 版本编译。当镜像中的 PyTorch 基于 CUDA 12.9 构建,却在某个依赖(如音频处理库)中引入了为 CUDA 13 编译的组件时,运行时会因找不到匹配的 libcuda/libcudart 符号而直接崩溃。
这类问题的隐蔽性在于:Docker 镜像构建阶段通常不会报错,只有真正加载模型、调用 GPU 时才暴露。因此排查时建议先用 nvidia-smi 确认驱动支持的 CUDA 上限,再通过 pip list | grep cuda 或 conda list 核对各库的 CUDA 编译版本是否一致,最后按文中方案基于 CUDA 12.9 重装 Torch 系列依赖重建镜像。
对企业用户的建议
DeepSeek系列模型凭借其出色的性价比和开源策略,已成为众多企业的首选。而vLLM作为主流的开源推理引擎,此次针对DeepSeek的深度优化,进一步释放了硬件潜力。
对于正在使用vLLM部署DeepSeek模型的企业,建议尽快评估升级到新版本。虽然升级过程中可能遇到镜像兼容性问题,但1.9至5.3倍的性能提升足以覆盖迁移成本。在AI算力依然昂贵的当下,通过软件优化挖掘现有硬件潜力,是提升投入产出比的有效路径。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。