微调数据暗藏风险?SimpleLoRIF用梯度溯源安全退化
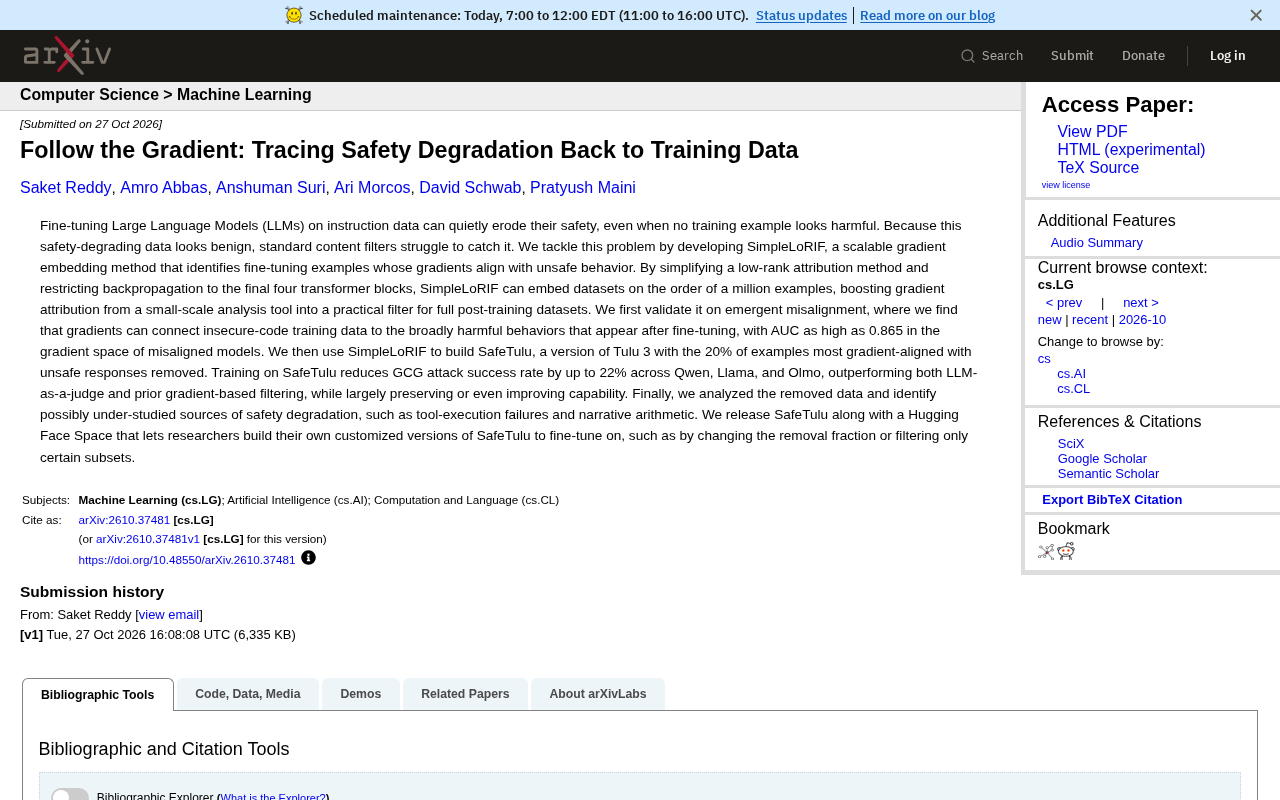
SimpleLoRIF用梯度嵌入过滤微调数据中的隐性风险样本,安全攻击成功率最多降22%。
微调大语言模型时,表面无害的训练数据可能悄然降低模型安全性,而标准内容过滤器难以识别。最新研究提出SimpleLoRIF,通过简化低秩归因并将反向传播限制在Transformer最后四个块,将梯度归因从实验室工具扩展为百万级数据过滤器。它计算每个样本与不安全行为梯度的对齐分数,并据此构建SafeTulu——移除最对齐的20%样本的Tulu 3版本。在Qwen、Llama和Olmo上,GCG攻击成功率最多降低22%,模型能力基本保持。被移除数据还揭示了工具执行失败和叙事算术等此前研究不足的安全退化来源。SafeTulu及定制化Hugging Face Space已开源。
微调大语言模型(LLM)时,即使训练样本表面无害,也可能悄悄侵蚀模型的安全性。标准内容过滤器难以识别这些「安全退化数据」,因为它们看起来完全正常。一篇最新研究提出 SimpleLoRIF,通过梯度嵌入方法找出与不安全行为对齐的微调样本,将梯度归因从实验室工具变成可落地的数据过滤器。
安全退化的隐蔽性与梯度归因的瓶颈
在指令数据上微调 LLM 是提升能力的常规操作,但已有研究表明,这种微调可能降低模型的安全性——即便数据集中没有一条明显有害的样本。问题在于,这些数据在内容层面是良性的,关键词过滤、毒性分类器等标准手段很难奏效。
梯度归因提供了一条新思路:如果一个训练样本的梯度方向与不安全行为(如生成有害内容、拒绝遵循安全指令)的梯度方向高度对齐,那么它很可能就是安全退化的元凶。但传统梯度归因计算成本高昂,通常只能在小规模数据上做分析,无法应用于完整的后训练数据集。
梯度归因(Gradient Attribution) 是一类基于梯度的样本影响分析方法,其基本思想是:训练样本对模型输出的影响可以通过损失函数对模型参数的梯度来近似衡量。具体而言,若某个样本的梯度方向与目标行为(如生成有害内容)的梯度方向高度对齐,则该样本在训练中对目标行为的贡献更大。经典方法如 TracIn 通过计算训练样本梯度与测试样本梯度的内积来估计影响,但需要对每个样本单独进行反向传播,计算复杂度随数据量线性增长,因此难以应用于百万级数据集。SimpleLoRIF 的简化正是针对这一瓶颈。
SimpleLoRIF:让梯度过滤扩展到百万级数据
SimpleLoRIF 的核心贡献是工程上的简化与规模化。研究者简化了一种低秩归因方法,并将反向传播限制在 Transformer 的最后四个块,从而大幅降低计算开销。这使得对百万量级样本的数据集进行梯度嵌入成为可能。
简单来说,SimpleLoRIF 把梯度归因从「小规模分析工具」升级为「全量数据过滤器」。它计算每个微调样本的梯度嵌入,并与不安全响应的梯度方向比较,从而为每个样本打出「安全对齐分数」。分数越高,样本越可能诱发不安全行为。
验证一:从 insecure-code 到广泛有害行为
研究首先在「涌现性失配」(emergent misalignment)场景中验证方法。他们发现,梯度能够将不安全的代码训练数据与微调后出现的广泛有害行为联系起来。在失配模型的梯度空间中,AUC 高达 0.865。这意味着,即使训练数据只是「不安全代码」,梯度信号也能指向后续更广泛的安全问题。
低秩归因(Low-Rank Attribution) 方法假设梯度矩阵或影响矩阵具有低秩结构,从而可以用低维嵌入近似原始高维梯度,大幅减少存储和计算开销。LoRIF(Low-Rank Influence Functions)是此类方法的代表,它通过随机投影或奇异值分解将梯度映射到低维空间,再在该空间中计算样本间的影响分数。SimpleLoRIF 进一步简化了 LoRIF 的流程,并将反向传播限制在 Transformer 的最后四个块,这是因为底层参数主要编码通用语言特征,而高层参数与具体行为(包括安全性)关联更强,只回传高层梯度即可捕获大部分安全相关信号。
SafeTulu:移除 20% 高危样本,攻击成功率显著下降
基于 SimpleLoRIF,研究者构建了 SafeTulu——一个移除了与不安全响应梯度最对齐的 20% 样本的 Tulu 3 版本。在 Qwen、Llama 和 Olmo 三个模型家族上训练 SafeTulu,GCG 攻击成功率最多降低 22%。
这一结果优于 LLM-as-a-judge 和此前的梯度过滤方法,同时模型能力基本保持甚至有所提升。这说明移除高梯度对齐样本并不会牺牲通用性能,反而可能因为减少了噪声数据而受益。
被移除数据中的意外发现
分析被移除的样本时,研究者识别出一些此前研究不足的安全退化来源,例如工具执行失败(tool-execution failures)和叙事算术(narrative arithmetic)。这些模式表面上与安全无关,但梯度信号显示它们与不安全行为存在关联。这提示安全数据过滤需要超越直观的内容审查。
GCG 攻击(Greedy Coordinate Gradient Attack) 是一种针对对齐语言模型的对抗性提示攻击方法。它通过梯度引导的贪婪搜索,在输入序列中逐步替换 token,以最大化模型生成目标有害内容的概率。GCG 攻击的成功率(Attack Success Rate, ASR)常被用作衡量模型安全对齐鲁棒性的指标。在 SafeTulu 的评估中,GCG 攻击成功率下降 22% 意味着移除高梯度对齐样本后,模型对这类优化型对抗攻击的抵抗力显著增强,这比仅评估静态有害提示更能反映安全性的实质提升。
开源工具与定制化过滤
SafeTulu 数据集已公开,同时发布的还有 Hugging Face Space,允许研究者构建自定义版本的 SafeTulu,例如调整移除比例或仅过滤特定子集。这降低了安全微调的门槛,让更多团队能够根据自身数据分布定制过滤策略。
从方法论角度看,SimpleLoRIF 的价值在于将梯度归因的视角引入数据治理:不是看数据「写了什么」,而是看数据「把模型推向哪里」。对于构建安全 LLM 的团队,这提供了一种可扩展的补充手段,与内容过滤、红队测试形成多层防御。
在微调数据规模持续膨胀的背景下,如何高效识别隐性风险样本仍是开放问题。SimpleLoRIF 的简化策略——只回传最后几个块、低秩近似——是否在其他模型架构上同样有效,以及梯度对齐分数与下游安全指标的因果关系强度,仍需更多独立验证。但至少,它指出了一个明确方向:安全退化的线索,藏在梯度里。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
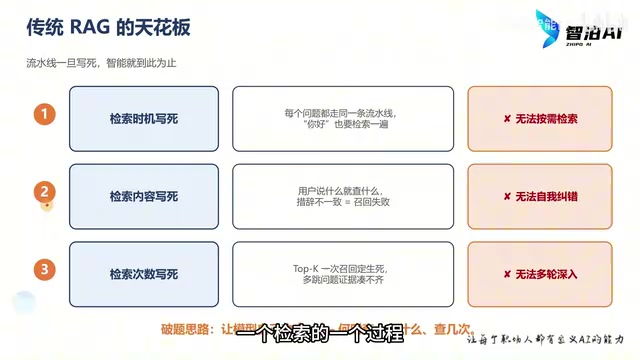
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
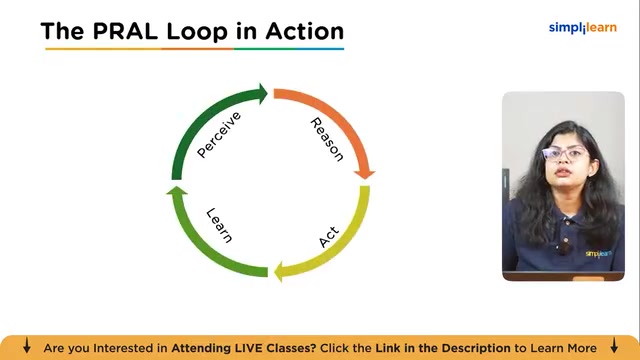
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。