微软Maia 300自研AI芯片亮相:剑指多吉瓦级推理部署

微软发布Maia 300推理芯片,剑指多吉瓦级Azure部署与每瓦性能优势。
微软正式亮相其下一代AI推理平台Maia 300,定位长上下文推理、低延迟对话与智能体场景。硬件上采用8组HBM4显存堆栈、台积电N2P计算芯粒及96加速器整机架形态,官方称每兆瓦功耗token吞吐量提升40%。该芯片将支撑Azure多吉瓦级推理部署,并逐步成为微软自家产品的主要推理系统。生产计划于2027年启动,届时将成为云厂商自研推理芯片路线的重要检验。
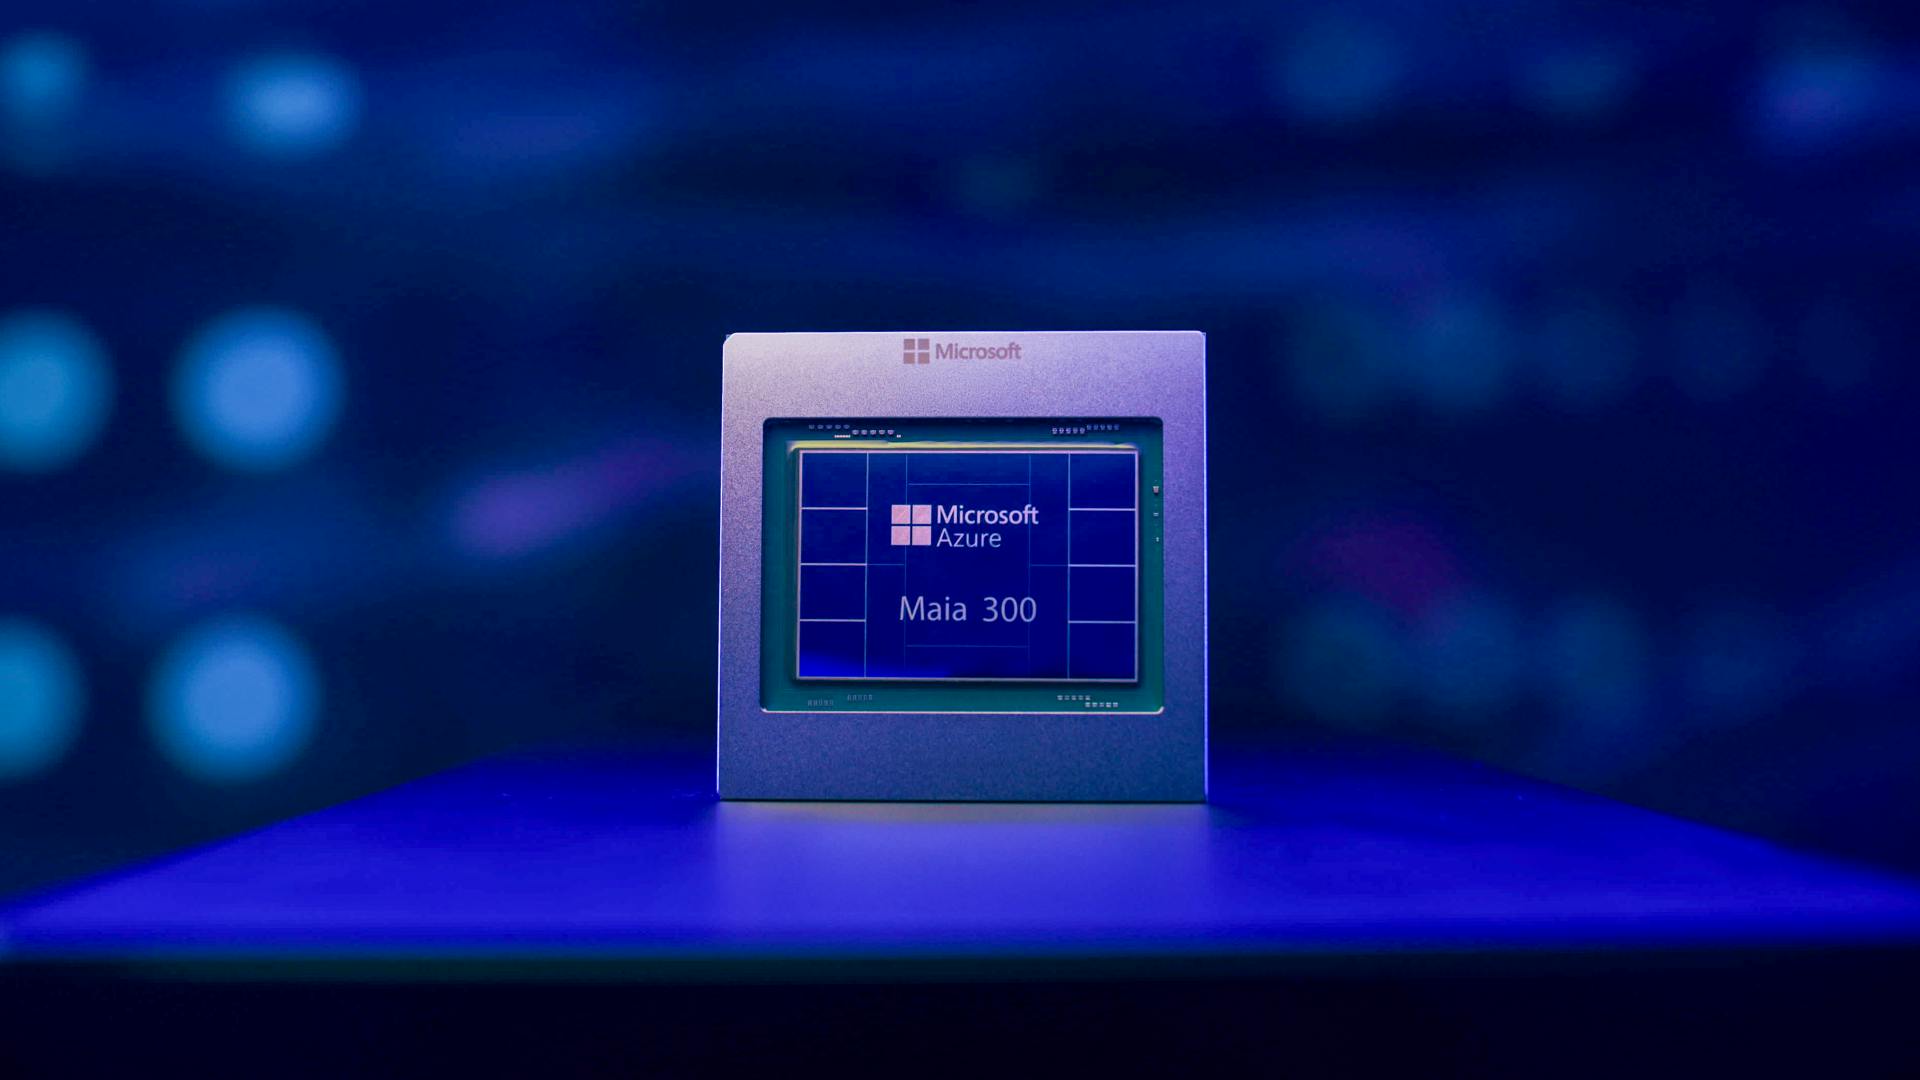
微软在AI芯片赛道再次加码。其下一代AI推理平台Maia 300正式亮相,定位清晰——面向长上下文推理、低延迟对话与智能体(agents)场景,并宣称将支撑Azure多吉瓦级别的推理部署。
Maia 300的核心规格
从官方披露的信息看,Maia 300在硬件层面做了几项关键升级:
- 8组HBM4显存堆栈:相比上一代,更高带宽的内存子系统直接服务于长上下文场景,让模型不必频繁在显存与外部存储间搬运数据。
- 台积电N2P制程的计算芯粒(chiplet):采用先进制程节点,在能效比上争取优势。
- 96加速器机架(96-accelerator racks):以整机架为部署单元,指向超大规模集群而非单卡出货。
微软给出的关键指标是每兆瓦功耗下token吞吐量提升40%。这个数字值得注意——它讨论的不是单芯片峰值算力,而是"每瓦性能",说明Maia 300的设计重心放在了大规模推理的经济性上。
HBM4(High Bandwidth Memory 4)是JEDEC主导的第四代高带宽显存标准,通过将多层DRAM裸片垂直堆叠、并以硅中介层(interposer)与计算芯粒紧邻互联,实现远超传统GDDR的带宽与能效。相比HBM3E,HBM4把接口位宽从1024位扩展到2048位,单堆栈带宽可突破2TB/s量级,同时在同等容量下降低每比特的访问能耗。对长上下文推理而言,KV缓存(键值缓存)会随序列长度线性膨胀,显存带宽往往先于算力成为瓶颈——这正是微软强调"8组HBM4堆栈"的原因:更多堆栈意味着更大的容量与更宽的带宽通道,从而减少模型权重与KV缓存往返外部存储的开销。
N2P是台积电2纳米家族中的性能增强版本,属于其N2节点之后的衍生工艺。N2首次引入全环绕栅极(GAA)纳米片晶体管,取代FinFET结构,在相同功耗下可获得更高驱动电流,或在相同频率下降低漏电与功耗。N2P在此基础上进一步优化,通常提供数个百分点到约一成的性能或能效提升。对AI加速器来说,先进制程不仅关乎峰值算力,更直接影响每瓦性能——这正是Maia 300主打"每兆瓦token吞吐"时依赖的底层支撑。
**芯粒(chiplet)**指把原本单一大芯片拆分为多个功能模块,各自用最合适的制程制造,再通过先进封装(如CoWoS或类似2.5D/3D封装)集成在同一基板上。好处是:计算逻辑用最先进节点保证能效,I/O或缓存等部分可用成熟节点降低成本与风险,同时提升良率。Maia 300称其计算部分采用N2P芯粒,意味着微软在追求能效的同时,也借chiplet策略控制了先进制程的用量与制造复杂度。
为什么是"推理",而不是训练?
这代Maia的定位很明确:推理平台。微软在公告中强调它面向long-context reasoning、low-latency conversation和agents三类工作负载,这三个方向恰好对应微软当前产品线里最吃算力的部分。
长上下文推理意味着模型要处理更长的输入;低延迟对话要求首token响应足够快;而agents则需要频繁、多轮的工具调用与推理循环。三者叠加,对推理基础设施的压力远超传统的单轮问答。
把推理作为主战场,也符合微软的商业逻辑。训练可以集中在少数超算集群完成,但推理是每天、每个用户、每次请求都在发生的持续开销。谁能压低推理的每token成本,谁就能在AI产品的毛利上占据主动。
**长上下文推理(long-context reasoning)**指模型需要处理数万乃至百万级token的输入,例如整本文档、代码库或多轮对话历史。其挑战不只是注意力计算量随序列长度呈平方级增长,更在于KV缓存占用的大量显存,以及由此带来的带宽压力。低延迟对话关注的是首token时间(TTFT)与每token输出间隔,直接决定用户对聊天产品的体感。**智能体(agents)**则是让模型自主规划、调用工具、多轮循环执行任务,一次用户请求可能触发数十次模型调用,对推理吞吐与调度效率的要求成倍放大。这三类负载共同的特点是:对显存带宽、互联延迟与每瓦性能极度敏感,而非单纯追求训练时的浮点峰值。这也解释了为何专用推理芯片往往在内存子系统与整机架互联上做文章,而不是单纯堆算力。
多吉瓦意味着什么
"Multi-gigawatts"是这份公告里最有分量的表述。它把讨论从"部署了多少张卡"拉高到了"占用多少电力"的层面。
一座吉瓦级数据中心是能源基础设施级别的存在。微软表示Azure Maia将扩展到multi-gigawatt部署,并成为微软自家产品的主要推理系统。换句话说,Maia 300不只是一款可选的云上加速器,而是要逐步替代微软内部推理负载所依赖的第三方芯片。
这也解释了为什么微软要把自研芯片做成整机架形态——在多吉瓦规模下,网络拓扑、供电与散热的设计比单芯片指标更重要。
吉瓦级数据中心通常指持续供电能力达到1GW(约100万千瓦)量级的设施,相当于一座大型核电机组或数座燃气电站的输出。当前全球最大的AI训练集群功耗多在数百兆瓦级,而"multi-gigawatt"意味着微软规划的是数倍于此的推理基础设施。在这个尺度下,电力获取、变电站接入、冷却(液冷或浸没式)与网络布线成为首要约束,单芯片的峰值指标反而退居次要。这也是云厂商转向整机架交付的根本原因:机架级设计可以统一供电母线、液冷回路与高速互联拓扑,使部署与运维标准化,从而支撑规模化扩张。
量产节奏与落地时间表
公告提到生产将在2027年启动。从发布到量产之间留出了较长的时间窗口,这符合先进制程与HBM4产能爬坡的现实周期。对微软而言,这段时间也用于软件栈适配——芯片能否跑满,取决于编译器、算子库与框架支持的成熟度。
自研芯片竞赛的下一步
微软并非唯一押注自研AI芯片的云厂商。Maia 300的出现,让"云厂商自研推理芯片"这条路线更加清晰:不再追求通用算力,而是针对自家模型和产品形态做定制化设计。
40%的每兆瓦token提升是个有力的卖点,但它目前仍是微软自己给出的数据。真正的检验标准,是Maia 300能否在2027年量产后,以稳定的良率和可用的软件生态,兑现多吉瓦部署的承诺。
相关推荐

Claude Pro不含API权限?Max与Team计划新增API额度详解
Claude Pro订阅不含API访问权限,API需单独计费。但Max和Team计划现已包含每月API额度:Max 5x为100美元,Max 20x为200美元,Team每席位最高合计500美元。本文详解各档位额度、领取方式及对开发者的影响。

隔离环境实测35万星REA:4秒装完,但两个坑要当心
隔离实验室实测35万星开源逆向工程工具REA:4秒安装、15秒列出截图工具全部外联地址、梳理565个通信通道,同时暴露写入用户级设置与31个高风险工具权限两个坑,附三条安全使用规则。
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
逆向工程+AI Agent:几周克隆Adobe应用的技术真相
一位开发者因Adobe提前取消费转向逆向工程,用AI Coding Agent几周内做出7款开源替代品。本文解析逆向工程原理、Reverse Engineer Anything这个MCP Server六天破10万星的原因,以及AI克隆应用在性能、专有数据和法律层面的真实边界。