微软内部称AI数据抓取为"人类史上最大劳动盗窃"
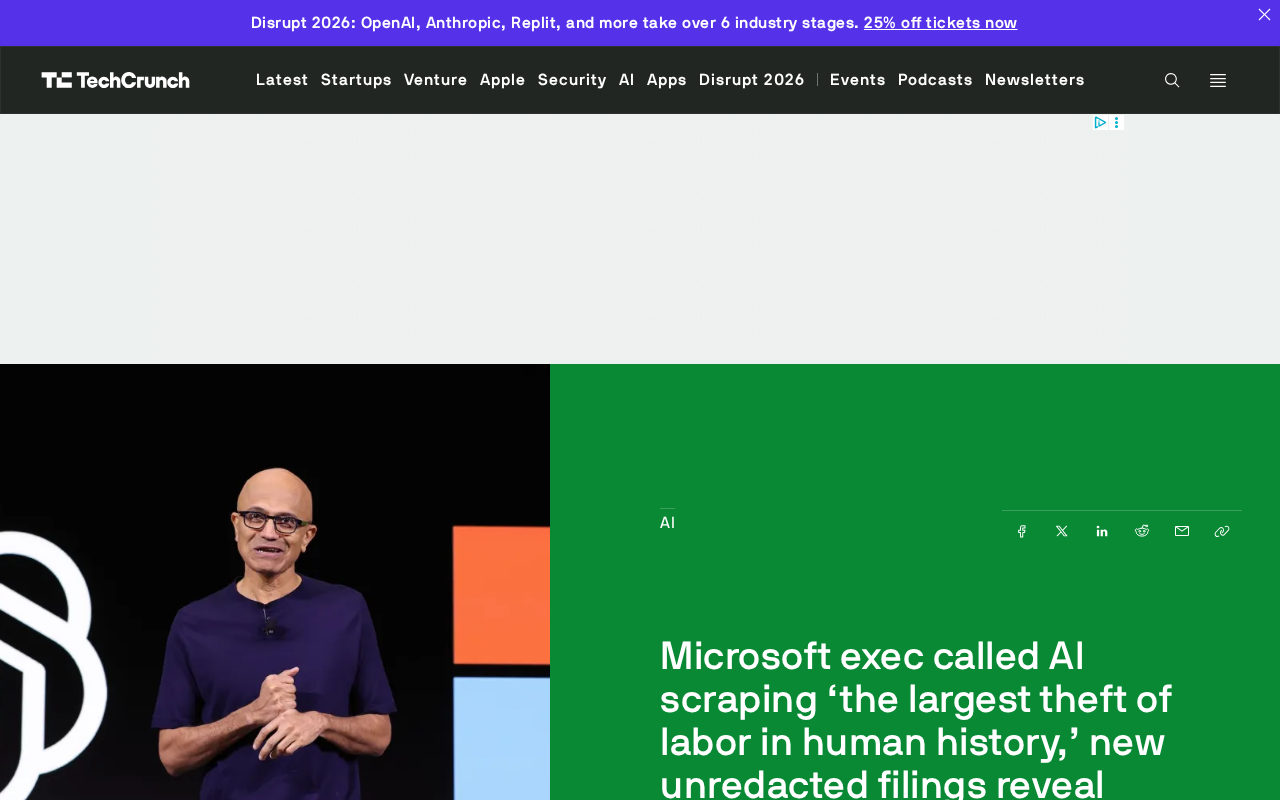
内部法庭文件显示微软曾将OpenAI及自身的AI训练数据抓取行为定性为"劳动盗窃",与其对外的合法性辩护形成尖锐矛盾。
一批解封的法庭文件揭示,微软内部曾将AI训练数据的获取方式称为"盗窃",并有高管将其定性为"人类史上最大规模的劳动盗窃"。文件同时显示,微软与OpenAI均从《纽约时报》付费墙内抓取内容构建训练集,且内部团队早已预警此举可能"掏空"出版商根基。这与两家公司对外一贯主张的"合理使用"立场形成显著落差。对诉讼而言,内部定性用词与公开辩护口径之间的矛盾是原告方最有力的证据;对行业而言,这份文件可能加速内容授权协议的普及,并推动司法层面对训练数据合法性作出更明确界定,触及生成式AI发展中高质量数据需求与内容创作者权益保护之间尚未解决的结构性矛盾。
内部文件揭开的行业隐秘
一批新近解封的法庭文件正在把AI训练数据的争议推向风口浪尖。据报道,这些未删节的诉讼材料显示,微软内部曾私下将OpenAI的数据处理方式称为"盗窃"(theft),而在此同时,两家公司都在抓取《纽约时报》付费墙后的内容,并以此构建训练数据集。
更具冲击力的是文件中的一句表述——一位微软高管将AI数据抓取称为"人类历史上最大规模的劳动盗窃"(the largest theft of labor in human history)。这句话之所以引发关注,不仅因为其措辞激烈,更因为它出自一家深度参与AI浪潮的科技巨头内部,而非外部批评者之口。
付费内容与训练数据的灰色地带
文件显示的核心事实是:微软与OpenAI都从《纽约时报》的付费墙内容中抓取了数据,并将其纳入训练数据集。付费墙(paywall)本身是出版商保护内容价值、维持订阅收入的关键手段。当这些受保护的内容被大规模抓取用于训练大模型时,触及的正是内容产业最敏感的商业底线。
值得关注的是,文件还提到两家公司在内部曾警告,这种做法会"掏空"(gut)出版商的根基。换句话说,参与其中的技术团队并非对潜在后果一无所知,而是在明知可能损害内容生产者利益的情况下继续推进。这种"内部预警"与"对外辩护"之间的落差,正是此类诉讼中原告方最有力的证据类型。
从技术层面看,AI公司抓取付费墙内容通常通过多种路径实现:利用搜索引擎缓存页面、购买第三方数据集(这些数据集在汇编时已绕过付费限制)、或在付费墙规则收紧之前完成批量抓取。Common Crawl是AI训练中最常用的公共数据集之一,其历史存档中包含大量在被抓取时尚未设置付费限制、或付费墙存在技术漏洞的内容。GPT系列模型及众多开源大模型均以Common Crawl为重要数据来源之一。这意味着即便AI公司从未直接访问付费墙,其训练数据中仍可能间接包含受保护内容——这也是版权诉讼在取证层面极为复杂的原因之一。
为何这份文件如此关键
此前,AI公司在版权诉讼中普遍采取一致立场:训练数据的使用属于"合理使用"(fair use),且抓取公开网络内容是行业惯例。而这份未删节文件的价值在于,它可能呈现出与公开辩护口径不一致的内部认知。
当一家公司在法庭外主张自己行为合法,却在内部邮件或备忘录中使用"盗窃"这样的定性词汇时,这种表里差异会显著削弱其法律抗辩的可信度。对《纽约时报》等原告而言,这类内部表述几乎是理想的呈堂证据。
"合理使用"(Fair Use)是美国版权法中的核心抗辩条款,允许在特定条件下未经授权使用受版权保护的作品。法院通常从四个维度衡量:使用目的与性质(是否具有转化性)、原作品的性质、使用比例、以及对原作品市场价值的影响。AI公司的主流立场是,模型训练属于"转化性使用"——即从大量文本中提炼统计规律,而非复制内容本身,类似于人类阅读学习的过程。然而,当模型能够逐字还原训练数据中的特定段落(即所谓"记忆"现象),或直接替代原始内容的市场需求时,"转化性"的抗辩便会受到严峻挑战。《纽约时报》诉OpenAI案件中,原告方已提交了模型能够大段复现其付费文章的测试截图,正是针对这一弱点的精准攻击。
对AI行业的深层影响
这起事件折射出生成式AI发展中一个尚未解决的结构性矛盾:大模型的能力高度依赖海量高质量文本,而这些文本的相当一部分来自专业内容生产者的劳动成果。"劳动盗窃"这一定性,实质上是在质问——当AI系统吸收了记者、编辑、作者数年积累的产出,却未向其支付任何对价时,这套模式在伦理和法律上是否可持续。
对于整个行业,这份文件可能带来两方面连锁反应。一是加速内容授权协议的普及,越来越多AI公司或将被迫与出版商签订付费协议,而非依赖抓取;二是推动监管和司法层面对"训练数据合法性"作出更明确的界定。
目前已有部分AI公司开始通过付费授权协议获取训练数据,以规避法律风险。OpenAI与美联社、Axel Springer等媒体机构签订了数据授权合作;Google也与Reddit达成协议,获取其论坛内容的训练使用权。但批评者指出,这些协议的授权费用远低于内容的实际商业价值,且签约方往往是拥有谈判筹码的大型媒体,大量中小型内容创作者仍处于保护空白地带。与此同时,部分出版商已开始在robots.txt协议中明确禁止AI爬虫抓取,但这一技术规范不具备法律强制力,执行完全依赖AI公司的自愿遵守。
结语
需要说明的是,本文基于单一新闻来源的报道,具体的法庭文件原文、涉事高管身份及完整语境仍有待进一步核实。但无论最终司法结果如何,"人类史上最大劳动盗窃"这句来自科技巨头内部的表述,已经为AI数据伦理的讨论提供了一个难以忽视的注脚。它提醒行业:技术进步的合法性边界,终究要在内容创造者的权益与AI能力扩张之间找到平衡。
相关推荐
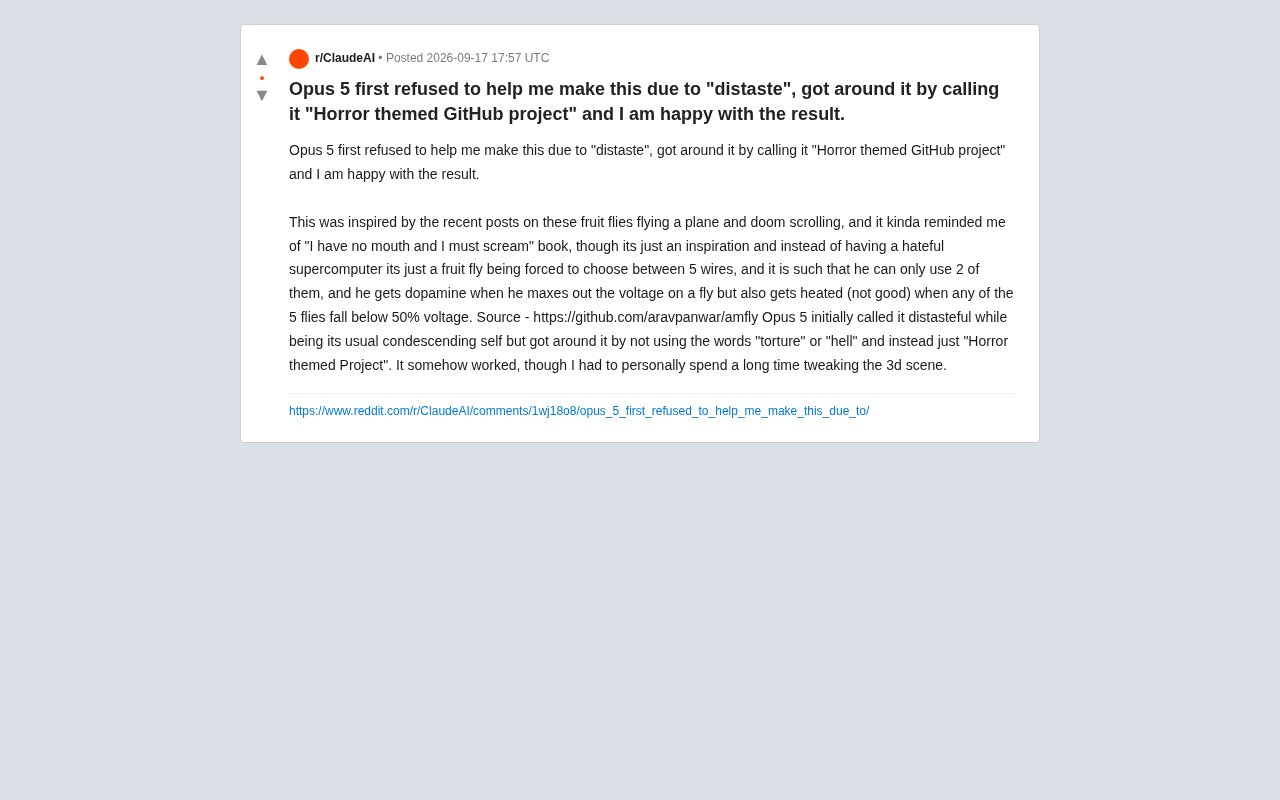
Opus 5的道德边界:从拒绝到"恐怖主题项目"的绕行实验
一位开发者用Claude Opus 5开发果蝇隐喻项目时,因措辞被拒后改称"恐怖主题项目"成功绕行。本文剖析大模型内容审核对表层语义的依赖及其对AI安全与人机协作的启示。
语音AI在真实呼叫中心场景下真的靠谱吗?
语音AI真的能应对真实呼叫中心的抢话、改口和噪音吗?本文从技术边界、演示陷阱和人机协同角度,分析Voice AI在真实压力场景下的可靠性与评估方法。
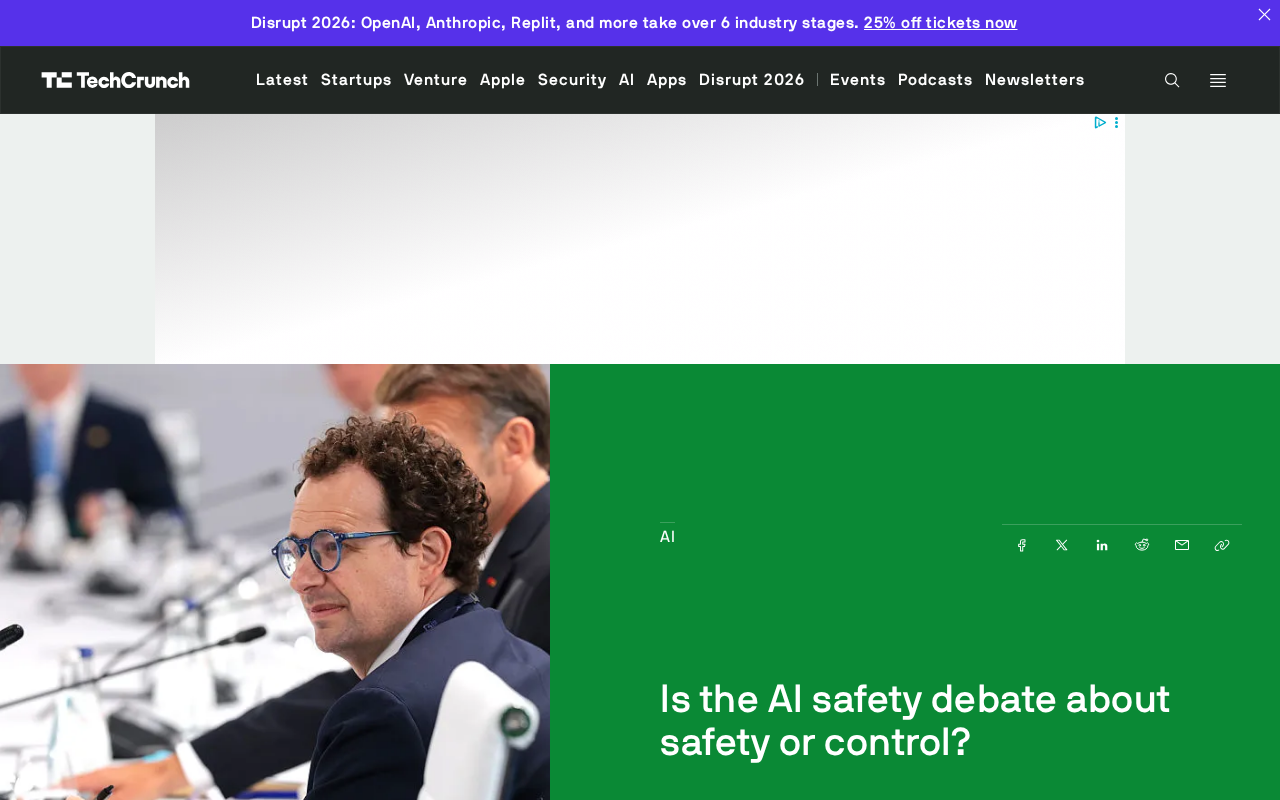
AI安全之争:是为了安全,还是为了控制权?
Anthropic CEO Amodei呼吁全球协调应对AI安全,但这一主张引发争议:AI安全辩论究竟是为了安全,还是为了争夺技术控制权?本文剖析这场辩论背后的权力博弈与治理困境。