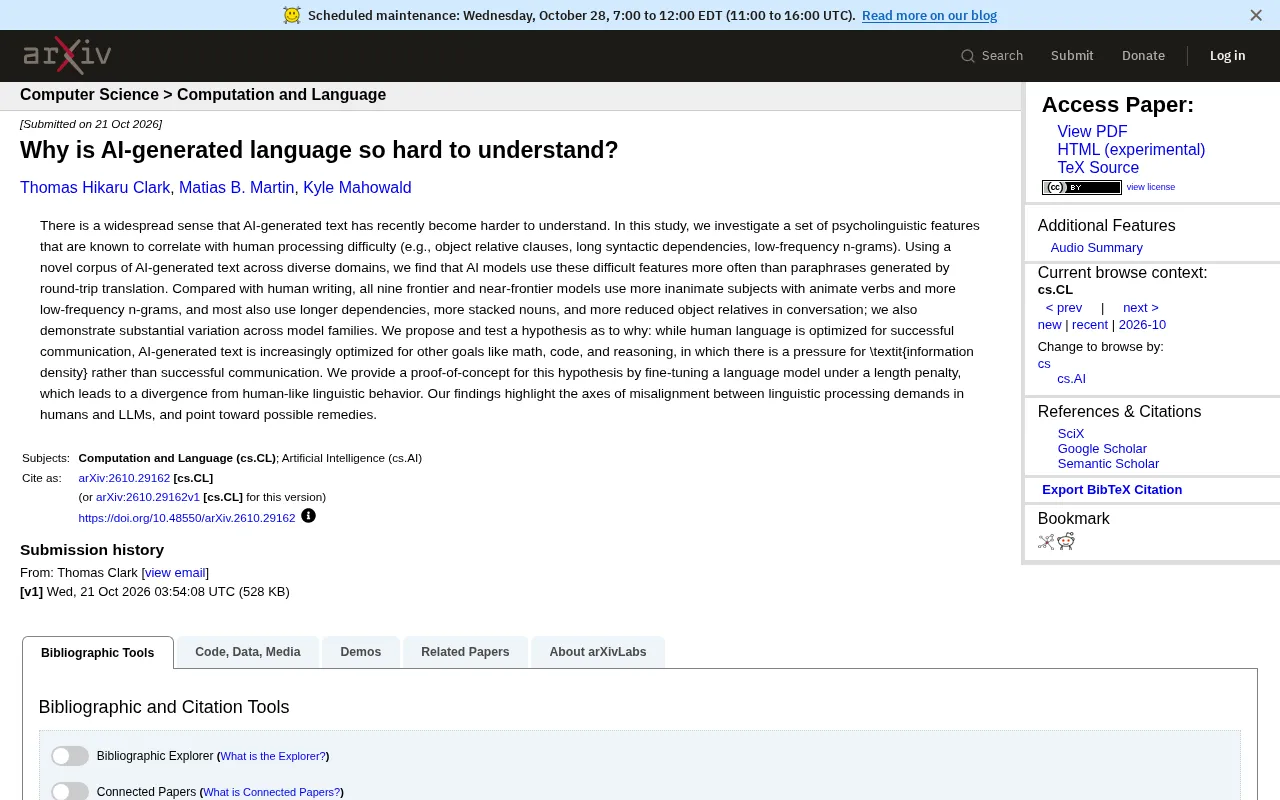
为什么AI生成的语言这么难懂?

AI文本流畅却难懂,根源在优化目标与人类理解路径的错位。
文章基于Hacker News讨论,剖析AI生成语言「流畅却难懂」的多重成因:模型优化的是下一个token的概率,而非读者的理解效率;文本语义密度失衡,abstract堆砌形成「正确的废话」;模型缺乏读者模型与共同背景,无法校准预设知识边界;对齐训练奖励全面平衡的表达,催生回避立场的防御性文风。讨论还指出,模型越强,「难懂」并未消失,只是从语法错误转为过度平滑的复杂。文章最后给出实用建议:要求先给结论再展开、列出论点再写段落、用具体例子锚定概念,以人类理解路径约束生成过程。
在Hacker News上,一个关于「为什么AI生成的语言如此难以理解」的讨论引发了71点热度和59条评论。这个问题看似简单,却触及了当前大语言模型在语言生成层面的深层矛盾:模型被设计得越来越「流畅」,但读者却常常感到「费解」。
流畅≠易懂:AI语言的认知负荷问题
AI生成的文本往往语法完美、用词考究,但读起来却让人头晕。这并非错觉。Hacker News上的讨论指出,问题不在于AI「不会说话」,而在于它说的是一种没有真实交际意图的语言。
人类写作时,作者会预判读者的知识背景、阅读目的和可能的困惑点,主动调整信息的密度和顺序。而大语言模型生成文本时,优化的目标是「下一个token的概率」,而非「读者的理解效率」。结果就是:句子之间逻辑连接词齐全,但信息推进的节奏并不服务于人类的理解路径。
一位评论者用了一个精妙的比喻:读AI生成的文本,就像听一个从不喘气的人说话——每个字都清楚,但整体上缺乏让你消化和回应的间隙。
认知负荷(Cognitive Load)原本是教育心理学中的概念,由John Sweller在1980年代提出,指工作记忆在处理信息时所承受的负担。人的工作记忆容量有限,一次只能处理约4±1个信息组块,一旦超出,理解效率就会急剧下降。认知负荷分为三类:内在负荷(材料本身的复杂程度)、外在负荷(呈现方式不当造成的额外负担)、以及关联负荷(用于构建图式的心智投入)。AI文本让人费解,很大程度上是外在负荷过高——句子之间的过渡、抽象名词的堆叠、缺乏具体锚点,都迫使读者额外消耗工作记忆去重建作者的意图。这与人类写作中「预判读者认知状态、主动降低外在负荷」的实践形成鲜明对比。
语义密度与「正确的废话」
另一个被反复提及的因素是语义密度失衡。AI倾向于在一个段落里塞入大量抽象名词和修饰语,形成一种「高密度但低信息量」的文本。表面上看每句话都在陈述观点,细读却发现许多句子在重复或稀释同一个意思。
这种现象在Hacker News的讨论中被概括为「正确的废话」:AI不会犯明显的逻辑错误,但它会用不同的措辞反复包装同一个安全、笼统的结论。读者需要耗费额外精力去辨别哪些是真正的新信息,哪些只是修辞上的填充。
这与人类专家的写作形成对比。好的技术作者会主动压缩冗余、用具体例子锚定抽象概念,而AI往往反其道而行之——用抽象解释抽象,用概括包裹概括。
语义密度(Semantic Density)在社会语义学中指的是单位文本所承载的意义数量。语言学家J.R. Martin等人将其作为衡量语域复杂度的一个维度:学术文本通常语义密度高,因为大量信息被压缩进名词短语;口语则语义密度低。然而高语义密度并不必然意味着高信息量——当抽象名词只是相互指涉而缺乏经验锚点时,语义密度上升而实际信息增量趋近于零。Hacker News讨论中所说的「正确的废话」,正是这种语义密度与信息量脱钩的状态:文本语法完备、术语准确,却因为缺乏可验证的具体指涉,读者反复咀嚼后得到的仍是笼统结论,从而产生「读了很多却什么也没记住」的挫败感。
缺乏「共同 ground」:AI不知道你在哪里
讨论中一个共识是:人类交流建立在共同 ground(共同背景知识)之上。当你说「这个方案和上次那个类似」,你默认对方知道「上次那个」是什么。人类作者会在写作中逐步建立这种共同背景,或根据目标读者调整预设。
AI没有这种能力。它不知道读者的知识边界在哪里,因此要么过度解释(对专家显得啰嗦),要么假定过多(对新手显得跳跃)。Hacker News评论者指出,这种「读者模型缺失」是AI文本难以理解的结构性原因。模型可以模仿学术腔、博客腔或新闻腔,但它模仿的是语域的表面特征,而非语域背后的读者关系。
共同 ground(共同背景知识)是认知科学与语用学中的核心概念,由Herbert Clark等人在1990年代系统阐述。它指交际双方共同知道、且彼此都知道对方知道的那部分知识与预设。人类对话中,「这个」「上次那个」等指示性表达之所以能被理解,正是因为双方在互动中不断建立和更新共同 ground——通过提问、确认、修正,逐步校准彼此的认知状态。Clark称之为「grounding」过程。大语言模型在单轮生成时没有这样交互式校准的机会,它只能基于训练语料中的统计模式推测读者可能的背景,因此无法判断哪些信息需要展开、哪些可以省略。这种「共同 ground 的不可协商性」,是AI文本在跨读者群体时普遍难以适配的深层原因。
为什么模型越强,文本反而越难读?
一个反直觉的观察是:随着模型能力提升,AI文本的「难懂」并未消失,只是换了一种形式。早期模型的问题是语法错误和逻辑断裂,容易被识别;当代模型的问题则是过度平滑的复杂——句子结构完整、术语使用准确,但整体读起来像一份没有重点的合规文档。
讨论中有人将这种现象归因于对齐训练的副作用。为了让模型「有帮助且无害」,训练过程倾向于奖励全面、平衡、留有余地的表达,这自然导向一种回避明确立场、堆砌限定条件的文风。读者感受到的「难懂」,部分是对这种防御性写作的直觉反应。
对齐训练(Alignment Training)通常指通过监督微调、基于人类反馈的强化学习(RLHF)等手段,使模型输出符合人类偏好与安全规范。其奖励信号往往偏好「全面、无遗漏、不冒犯」的回答,因为这类输出在标注者眼中显得更可靠。但奖励全面性会系统性地鼓励模型堆砌限定条件、列举多种可能性、避免给出明确判断——这正是「防御性写作」的成因。值得注意的是,这种偏好并非模型能力缺陷,而是优化目标的直接产物:一个在安全评估中得分更高的模型,可能同时在可读性上更差。理解这一权衡,有助于使用者区分「模型不会写清楚」和「模型被训练成不优先写清楚」。
如何与AI语言相处
Hacker News的讨论并未止于抱怨。几条实用建议获得了较多认同:要求AI「用一句话说结论」再展开;让它先列出论点再写段落;对关键概念要求给出具体例子而非定义。核心逻辑是:用人类的理解路径去约束生成过程,而不是被动接受模型默认的输出节奏。
AI生成语言难以理解,本质上不是技术缺陷的偶然产物,而是优化目标与人类交际需求之间的错位。认识到这一点,比单纯抱怨「AI写得不好」更有助于我们用好这类工具。
相关推荐
OpenAI数学突破、Anthropic IPO与推理模型教程
OpenAI公布数学、计算机与物理三项成果,声称证明ETH不成立;Anthropic提交上市申请,披露营收与客户数据;SpaceX获400亿美元GPU融资;开源模型工具调用准确率问题与约束解码方案;8视频推理模型构建教程。

推理模型14个核心概念:从思维链到GRPO全面拆解
系统拆解推理模型14个核心概念:思维链、测试时计算、验证器、RLVR与GRPO、蒸馏与reward hacking,并给出思考token的成本控制规则,帮你判断何时值得为推理付费。

OpenAI称推翻ETH引热议,Meta豪赌AI基建
OpenAI宣布AI辅助发现,预印本声称推翻指数时间假设ETH,同时推出中端模型GPT-6.1 Tera。Cloudflare披露跨客户数据泄露复盘,Meta拟融资950亿美元投入AI基建。